us-genai-court-opinions
收藏资源简介:
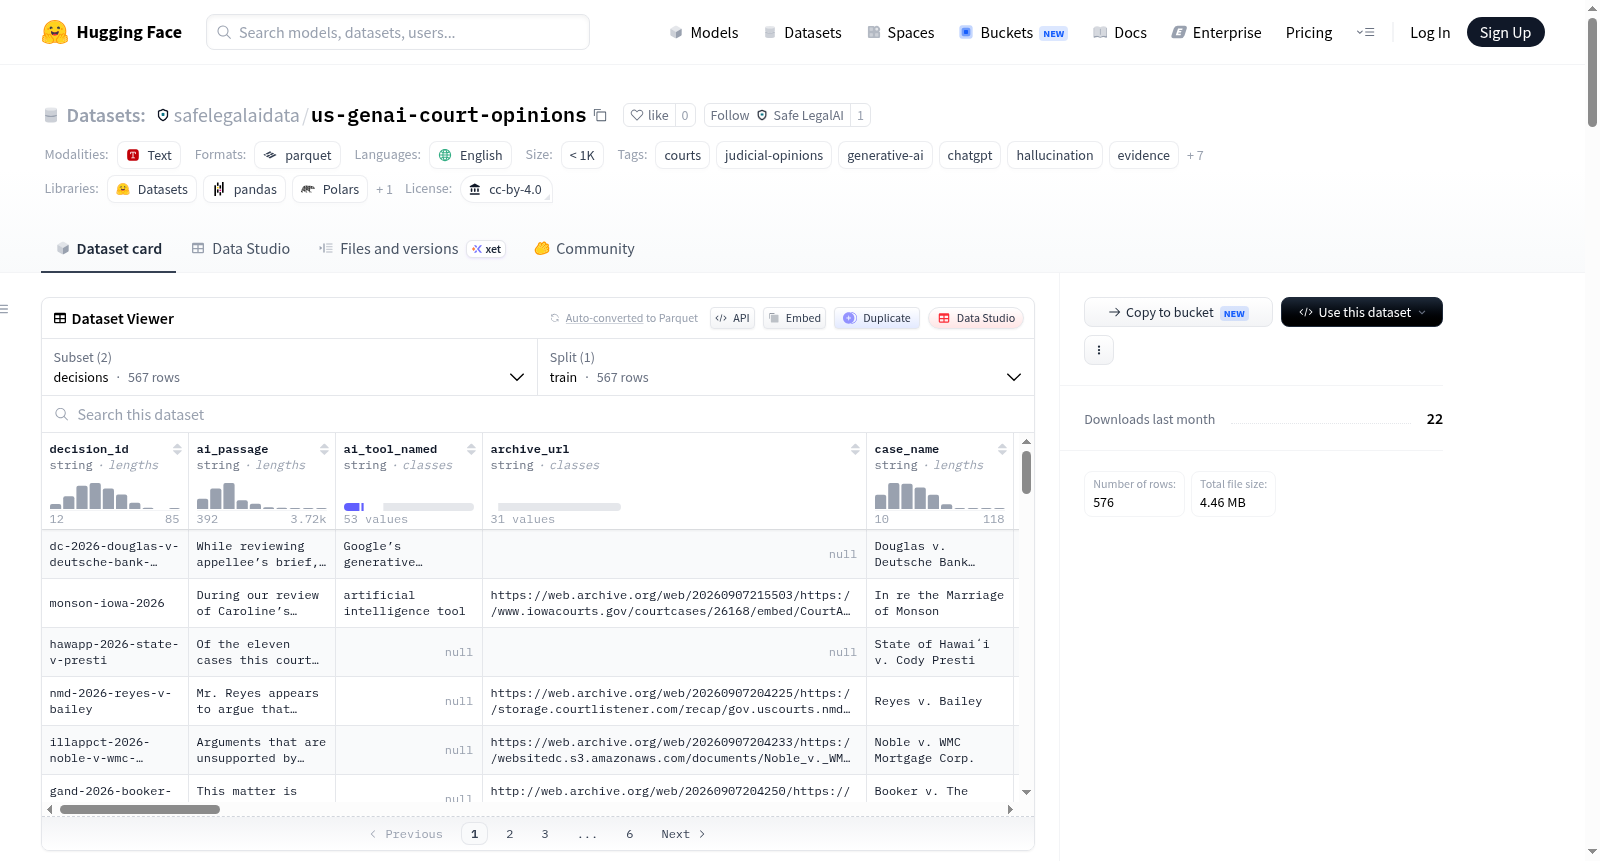
该数据集收录了567份美国法院出具的、实质讨论生成式AI的司法文件(包括判决书、命令、协同意见书、异议意见书及行政命令),并包含9件涉及法律AI公司或产品的诉讼案卷及其时间节点记录。每份文件均按主题编码,并引用公共领域的相关段落。数据集由SafeLegalAI(Cognesio LLP)于2026年9月8日构建,采用CC BY 4.0许可协议。数据集包含两个表格:decisions(567行,涵盖案件名称、法院、法院层级、州、提交日期、引用、案号、文件类型、主题列表等)和litigation(9行,每个代表一个以法律AI公司或产品为当事人的诉讼程序)。主题分布包括虚构引用类522条、自诉人使用AI类10条等。适用于统计比较、监测列表构建、检索摘要及教学等。
This dataset contains 567 U.S. court documents (including opinions, orders, concurrences, dissents, and administrative orders) that substantially discuss generative AI, along with 9 litigation dockets involving legal AI companies or products with their timeline milestones. Each document is topic-coded and includes relevant public domain paragraphs. Built by SafeLegalAI (Cognesio LLP) on September 8, 2026, under CC BY 4.0 license. It has two tables: decisions (567 rows with case name, court, court level, state, filing date, citation, docket number, document type, topic list, etc.) and litigation (9 rows for lawsuits involving legal AI companies or products). Topic distribution includes 522 fictional citations, 10 pro se AI use, etc. Suitable for statistical comparisons, monitoring lists, retrieval/summarization, teaching, and library guides.
数据集概述:美国法院关于生成式AI的判决书语料库
基本信息
- 数据集名称:US court decisions on generative AI (coded corpus)
- 构建机构:SafeLegalAI(Cognesio LLP)
- 构建日期:2026-09-08
- 许可协议:CC BY 4.0
- 语言:英语
- 数据规模:n<1K(少于1000条)
- 版本:v0.1.2
数据内容
本数据集包含两个数据表:
1. decisions 表(567行)
该表收录了567份由美国法院撰写的实质性讨论生成式AI的文件,包括判决书、命令、同意意见、异议意见及行政命令。每一行代表一份法院文件,涵盖以下字段:
- 案件信息:案例名称、审理法院、法院层级、所在州、归档日期、引用、案卷号、文件类型
- 主题标注:
topics[](包括虚构引用、法院使用AI、证据认证、证据开示、特权与工作产品、非法执业、刑事司法算法、自诉人使用AI、能力与费用、规则制定、实体AI法)、primary_topic - AI相关内容:法院是否使用AI、具名AI工具、法院处理结果(disposition)、逐字摘录的公有领域AI段落(
ai_passage) - 其他:引用的权威文献、40-60词的摘要、事件详情(针对虚构引用案件)、追踪器链接
2. litigation 表(9行)
收录了以法律AI公司或其产品为当事人的诉讼程序,含日期标记的关键节点(milestones[]),涵盖美国、加拿大、德国、法国等司法管辖区的案件。
主题分布(decisions表)
按首要主题划分,虚构引用(fabricated-citations) 占绝对主导,共522行(92%),其余主题包括:
- 自诉人使用AI:10行
- 通过判决确立规则:8行
- 刑事司法算法:6行
- 实体AI法:5行
- 证据认证:5行
- 法院使用AI:4行
- 发现/电子发现:3行
- 能力与费用:2行
- 特权与工作产品:2行
法院层级分布
- 联邦地区法院:319行(占56%)
- 州上诉法院:145行
- 联邦上诉法院:28行
- 州最高法院:26行
- 州初审法院:26行
- 联邦破产法院:11行
- 联邦专门法院:10行
- 其他:2行
地域分布(排名前15的州)
加利福尼亚州(53)、纽约州(49)、德克萨斯州(32)、佛罗里达州(28)、伊利诺伊州(27)、亚利桑那州(21)、密歇根州(19)、俄亥俄州(18)、印第安纳州(18)、宾夕法尼亚州(16)、华盛顿州(16)、阿拉巴马州(13)、俄勒冈州(13)、马里兰州(12)、内华达州(11)。
诉讼案件状态分布
已判决(3)、已驳回(2)、进行中(1)、已和解(1)、同意令(1)、上诉中(1)。
数据来源与方法论
- 线索来源:Damien Charlotin的AI幻觉案例数据库(CC BY 4.0)、CourtListener搜索索引、法院网站搜索及新闻报道。
- 核实方式:每份文件均从发布法院官网、govinfo.gov或RECAP公开档案获取原始文件并逐份阅读。
- 编码原则:编码标准保守,并附公有领域原文摘录以便读者核验。
- 去重策略:虚构引用案件在事件追踪器中设有唯一页面,本语料库通过链接引用而非重复收录。
适用场景
适用:按法院、司法管辖区、日期、行为者、结果等维度统计比较记录;基于source_url/fetched_at构建监测列表和警报;基于引用的一手文件进行检索或摘要生成;教学和图书馆指南。
不适用:对产品、人员或法院进行排名;推断超出法院或监管机构自身声明的普遍性;将编码列视为事实或法律认定。
引用与致谢
每条记录均包含source_url、fetched_at及(若被Wayback Machine收录则保留)archive_url。意见书、命令和规则属于美国公有领域(17 U.S.C. § 105等),编译和编码采用CC BY 4.0许可,要求署名SafeLegalAI(safelegalai.com),由Cognesio LLP发布。代码采用Apache-2.0许可。查询、更正及回应权请访问 https://safelegalai.com/report。