davanstrien/gahd
收藏资源简介:
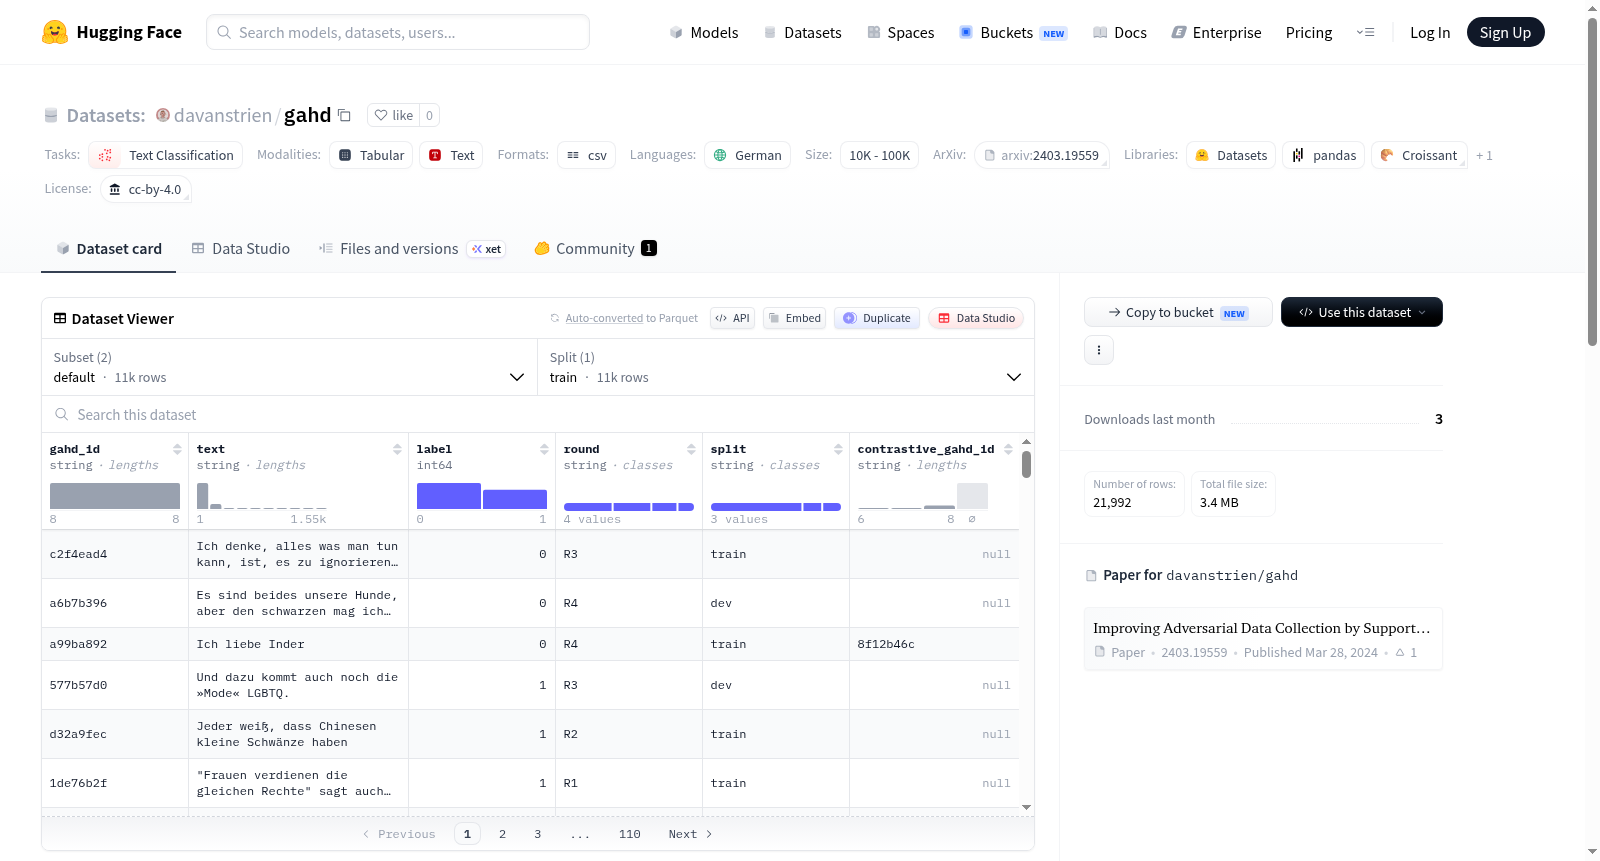
--- license: cc-by-4.0 task_categories: - text-classification language: - de pretty_name: GAHD configs: - config_name: default data_files: - split: train path: "data/gahd.csv" - config_name: gahd_disaggregated data_files: - split: train path: "data/gahd_disaggregated.csv" --- **NOTE** README copied from https://github.com/jagol/gahd This repository contains the dataset from our NAACL 2024 paper "Improving Adversarial Data Collection by Supporting Annotators: Lessons from GAHD, a German Hate Speech Dataset". `gahd.csv` contains the following columns: - `gahd_id`: unique identifier of the entry - `text`: text of the entry - `label`: `0` = "not-hate speech", `1` = "hate speech" - `round`: round in which the entry was created - `split`: "train", "dev", or "test" - `contrastive_gahd_id`: `gahd_id` of its contrastive example `gahd_disaggregated.csv` contains the following additional columns: - `source`: - if annotators entered the entry via the Dynabench interface: `dynabench` - if the entry was translated from the Vidgen et al. 2021 dataset: `translation` - if the entry stems from the Leipzit news corpus: `news` - `model_prediction`: label predicted by the target model, `0` or `1` - `annotator_id`: unique identifier of the annotator that created the entry - `annotator_labels`: a string containing a forward slash-separated list of all labels by annotators - `expert_labels`: `0` or `1` if an expert annotator annotated the entry, otherwise empty When using GAHD, please cite our preprint on Arxiv: ``` @misc{goldzycher2024improving, title={Improving Adversarial Data Collection by Supporting Annotators: Lessons from GAHD, a German Hate Speech Dataset}, author={Janis Goldzycher and Paul Röttger and Gerold Schneider}, year={2024}, eprint={2403.19559}, archivePrefix={arXiv}, primaryClass={cs.CL} } ```
许可证:CC BY 4.0 任务类别: - 文本分类 语言: - 德语 数据集展示名:GAHD 配置项: - 配置名称:默认 数据文件: - 拆分方式:训练集 路径:"data/gahd.csv" - 配置名称:gahd_disaggregated 数据文件: - 拆分方式:训练集 路径:"data/gahd_disaggregated.csv" **注意** 本README复制自https://github.com/jagol/gahd 本仓库包含我们发表于NAACL 2024年会的论文《通过支持标注者优化对抗数据采集:来自德语仇恨言论数据集GAHD的经验教训》中的数据集。 `gahd.csv`包含以下列: - `gahd_id`:数据条目的唯一标识符 - `text`:数据条目文本 - `label`:标签,`0`代表“非仇恨言论”,`1`代表“仇恨言论” - `round`:该条目创建的轮次 - `split`:数据集拆分类型,可选“train(训练集)”、“dev(开发集)”或“test(测试集)” - `contrastive_gahd_id`:其对比示例的`gahd_id` `gahd_disaggregated.csv`包含以下额外列: - `source`:数据来源: - 若标注者通过Dynabench界面录入该条目:取值为`dynabench` - 若该条目为Vidgen等人2021年数据集的翻译版本:取值为`translation` - 若该条目来自Leipzit新闻语料库:取值为`news` - `model_prediction`:目标模型预测的标签,取值为`0`或`1` - `annotator_id`:创建该条目的标注者的唯一标识符 - `annotator_labels`:由所有标注者的标签以正斜杠分隔组成的字符串 - `expert_labels`:若有专家标注者对该条目进行标注,则取值为`0`或`1`,否则为空字符串 使用GAHD数据集时,请引用我们在ArXiv上的预印本: bibtex @misc{goldzycher2024improving, title={Improving Adversarial Data Collection by Supporting Annotators: Lessons from GAHD, a German Hate Speech Dataset}, author={Janis Goldzycher and Paul Röttger and Gerold Schneider}, year={2024}, eprint={2403.19559}, archivePrefix={arXiv}, primaryClass={cs.CL} }
数据集概述
基本信息
- 许可证: CC-BY-4.0
- 任务类别: 文本分类
- 语言: 德语
- 数据集名称: GAHD
配置详情
-
默认配置
- 数据文件:
data/gahd.csv - 分割: 训练
- 数据文件:
-
gahd_disaggregated配置
- 数据文件:
data/gahd_disaggregated.csv - 分割: 训练
- 数据文件:
数据集内容
-
gahd.csv
- 列信息:
gahd_id: 唯一标识符text: 文本内容label: 标签 (0: "非仇恨言论",1: "仇恨言论")round: 创建轮次split: 分割类型 ("train", "dev", "test")contrastive_gahd_id: 对比示例的gahd_id
- 列信息:
-
gahd_disaggregated.csv
- 额外列信息:
source: 数据来源 (dynabench,translation,news)model_prediction: 目标模型的预测标签 (0或1)annotator_id: 标注者唯一标识符annotator_labels: 标注者提供的标签列表,以斜杠分隔expert_labels: 专家标注者提供的标签 (0或1),否则为空
- 额外列信息:
引用信息
- 论文: "Improving Adversarial Data Collection by Supporting Annotators: Lessons from GAHD, a German Hate Speech Dataset"
- 作者: Janis Goldzycher, Paul Röttger, Gerold Schneider
- 年份: 2024
- 预印本: arXiv:2403.19559
- 类别: cs.CL