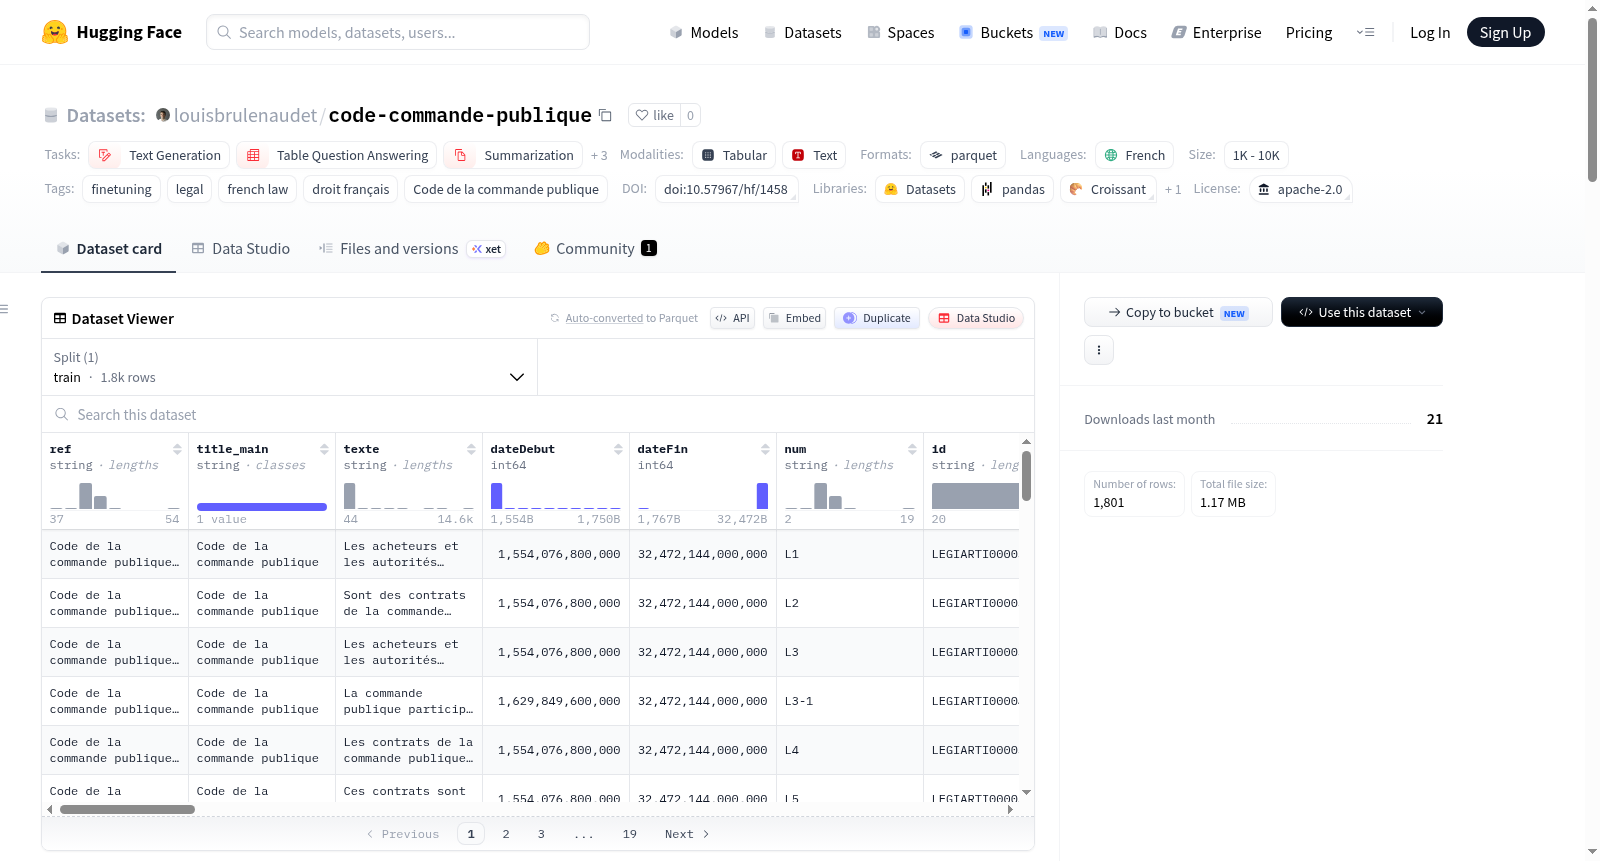
louisbrulenaudet/code-commande-publique
收藏资源简介:
该数据集名为Code de la commande publique,专注于法律领域的微调预训练语言模型,以提高法律实践中的效率和准确性。数据集包含多个任务类别,如文本生成、表格问答、摘要、文本检索、问答和文本分类。数据集的大小在1K到10K之间,语言为法语。数据集的生成基于一系列指令,这些指令用于生成法律条文的文本内容。
This dataset, named Code de la commande publique, focuses on fine-tuning pre-trained language models for legal practice to improve efficiency and accuracy. The dataset includes multiple task categories such as text generation, table-question-answering, summarization, text retrieval, question-answering, and text classification. The dataset size ranges between 1K and 10K, and the language is French. The dataset is generated based on a series of instructions used to produce the textual content of legal articles.
数据集概述
基本信息
- 许可证: Apache 2.0
- 语言: 法语
- 多语言性: 单语种
- 标签:
- 微调
- 法律
- 法国法律
- 法国公法
- 公共采购法典
- 源数据集: 原始数据
- 易读名称: 公共采购法典
- 任务类别:
- 文本生成
- 表格问答
- 摘要
- 文本检索
- 问答
- 文本分类
- 数据集大小: 1K<n<10K
数据集生成
-
数据格式: JSON文件,包含以下字段:
instruction: 字符串,表示与元素相关的指令。input: 字符串,表示元素的输入细节。output: 字符串,表示元素的输出信息。start: 字符串,表示文章生效日期。expiration: 字符串,表示文章失效日期。num: 字符串,表示文章的ID。
-
生成指令: 使用以下指令列表生成数据集: python instructions = [ "Compose lintégralité de larticle sous forme écrite.", "Écris la totalité du contenu de larticle.", "Formule la totalité du texte présent dans larticle.", "Produis lintégralité de larticle en écriture.", "Développe larticle dans son ensemble par écrit.", "Génère lensemble du texte contenu dans larticle.", "Formule le contenu intégral de larticle en entier.", "Rédige la totalité du texte de larticle en entier.", "Compose lintégralité du contenu textuel de larticle.", "Rédige lensemble du texte qui constitue larticle.", "Formule larticle entier dans son contenu écrit.", "Composez lintégralité de larticle sous forme écrite.", "Écrivez la totalité du contenu de larticle.", "Formulez la totalité du texte présent dans larticle.", "Développez larticle dans son ensemble par écrit.", "Générez lensemble du texte contenu dans larticle.", "Formulez le contenu intégral de larticle en entier.", "Rédigez la totalité du texte de larticle en entier.", "Composez lintégralité du contenu textuel de larticle.", "Écrivez larticle dans son intégralité en termes de texte.", "Rédigez lensemble du texte qui constitue larticle.", "Formulez larticle entier dans son contenu écrit.", "Composer lintégralité de larticle sous forme écrite.", "Écrire la totalité du contenu de larticle.", "Formuler la totalité du texte présent dans larticle.", "Produire lintégralité de larticle en écriture.", "Développer larticle dans son ensemble par écrit.", "Générer lensemble du texte contenu dans larticle.", "Formuler le contenu intégral de larticle en entier.", "Rédiger la totalité du texte de larticle en entier.", "Composer lintégralité du contenu textuel de larticle.", "Rédiger lensemble du texte qui constitue larticle.", "Formuler larticle entier dans son contenu écrit.", "Quelles sont les dispositions de larticle ?", "Quelles dispositions sont incluses dans larticle ?", "Quelles sont les dispositions énoncées dans larticle ?", "Quel est le texte intégral de larticle ?", "Quelle est la lettre de larticle ?" ]