RubyCraft-3.4-Instruct
收藏资源简介:
RubyCraft-3.4-Instruct是一个经过合成生成和严格过滤的数据集,旨在快速适配小型语言模型(SLMs)至最新的编程语言规范,特别是Ruby 3.4。该数据集展示了如何以极低成本(约€4.20)创建高性能的代码专家模型,有效减少对昂贵的大型语言模型API的依赖。数据集按教师模型和质量等级组织,以促进模型蒸馏和鲁棒性研究。数据生产流程包括合成生成、静态分析、Oracle验证、语义去重和LLM评分等多个阶段,确保数据的高质量和功能性。数据集包含多个子集,分别由Gemini-2.5-Flash和GPT-OSS-120B教师模型生成,并经过不同级别的质量筛选,适用于文本生成和代码生成任务。
RubyCraft-3.4-Instruct is a synthetically generated and rigorously filtered dataset designed to quickly adapt small language models (SLMs) to the latest programming language specifications, particularly Ruby 3.4. The dataset demonstrates how to create high-performance code expert models at a very low cost (approximately €4.20), effectively reducing reliance on expensive large language model APIs. The dataset is organized by teacher models and quality levels to facilitate model distillation and robustness research. The data production process includes multiple stages such as synthetic generation, static analysis, Oracle verification, semantic deduplication, and LLM scoring, ensuring high quality and functionality of the data. The dataset contains multiple subsets generated by Gemini-2.5-Flash and GPT-OSS-120B teacher models, each subjected to different levels of quality filtering, and is suitable for text generation and code generation tasks.
数据集概述:RubyCraft-3.4-Instruct
RubyCraft-3.4-Instruct 是一个合成生成并经过严格筛选的数据集,旨在帮助小型语言模型(SLMs)快速适应 Ruby 3.4 编程语言规范。该数据集以极低的成本(约 €4.20)展示了如何创建高性能的代码专家模型,从而减少对昂贵的大型语言模型API的依赖。
- 许可证: Apache-2.0
- 语言: 英语
- 标签: Ruby, 代码生成, 小型语言模型, 合成数据, 蒸馏, 指令微调
- 任务类别: 文本生成
- 数据集大小: 10K < n < 100K
数据组成与配置
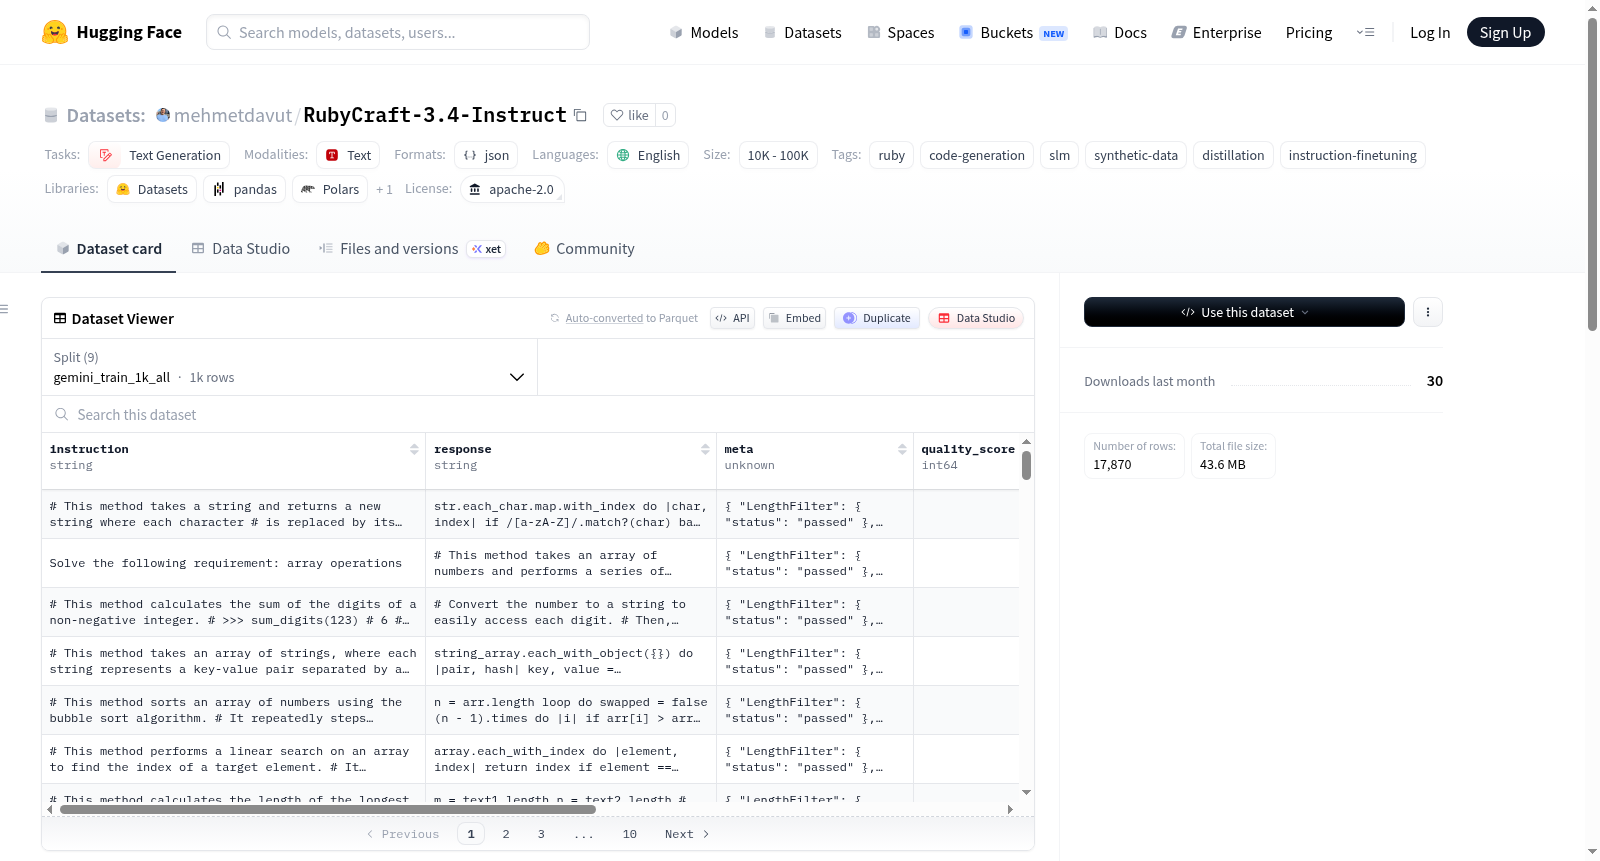
数据集按教师模型和质量层级进行组织,以支持模型蒸馏和鲁棒性研究。包含以下 8 个文件,分为两个配置(config)组:
| 文件名 | 教师模型 | 样本数 | 描述 |
|---|---|---|---|
gemini_train_1k_all (gemini_1k_all.jsonl) |
Gemini-2.5-Flash | 1,000 | 原始合成数据(主要教师) |
gemini_train_1k_hq (gemini_1k_hq.jsonl) |
Gemini-2.5-Flash | 527 | 1K 数据集的高质量子集 |
gemini_train_5k_all (gemini_5k_all.jsonl) |
Gemini-2.5-Flash | 5,000 | 更大规模的原始合成数据集 |
gemini_train_5k_hq (gemini_5k_hq.jsonl) |
Gemini-2.5-Flash | 1,845 | 冠军训练集,为提高效率而优化 |
gpt_oss_train_1k_all (gpt_oss_1k_all.jsonl) |
GPT-OSS-120B | 1,000 | 来自辅助教师的原始合成数据 |
gpt_oss_train_1k_hq (gpt_oss_1k_hq.jsonl) |
GPT-OSS-120B | 462 | GPT-OSS 1K 数据集的高质量子集 |
gpt_oss_train_5k_all (gpt_oss_5k_all.jsonl) |
GPT-OSS-120B | 5,000 | 来自辅助教师的大规模原始合成数据 |
gpt_oss_train_5k_hq (gpt_oss_5k_hq.jsonl) |
GPT-OSS-120B | 1,346 | GPT-OSS 5K 数据集的高质量子集 |
数据生产与筛选流程
所有样本均通过“自主合成数据流水线”处理,包含以下阶段:
- 合成生成: 教师大语言模型(Gemini-2.5-Flash 和 GPT-OSS-120B)被提示为 200 个复杂软件场景生成独特的实现,以测试多教师鲁棒蒸馏。
- 严格筛选(策展):
- 静态分析: 使用 RuboCop 强制执行 Ruby 3.4 的现代风格规则。
- Oracle 验证: 通过
ruby-c验证代码语法,并在沙盒环境中执行以确保功能正确性。 - 语义去重: 使用嵌入模型 (
all-MiniLM-L6-v2) 去除冗余的实现模式。 - LLM 作为评判者: 根据样本对 Ruby 3.4 现代特性(例如模式匹配、
Data.define)的使用情况,按 1-10 分进行评分。