
遇见数据集

nyralabs/disfluency_speech_english

收藏
Hugging Face2026-07-15 更新2026-07-22 收录
官方服务:

资源简介:

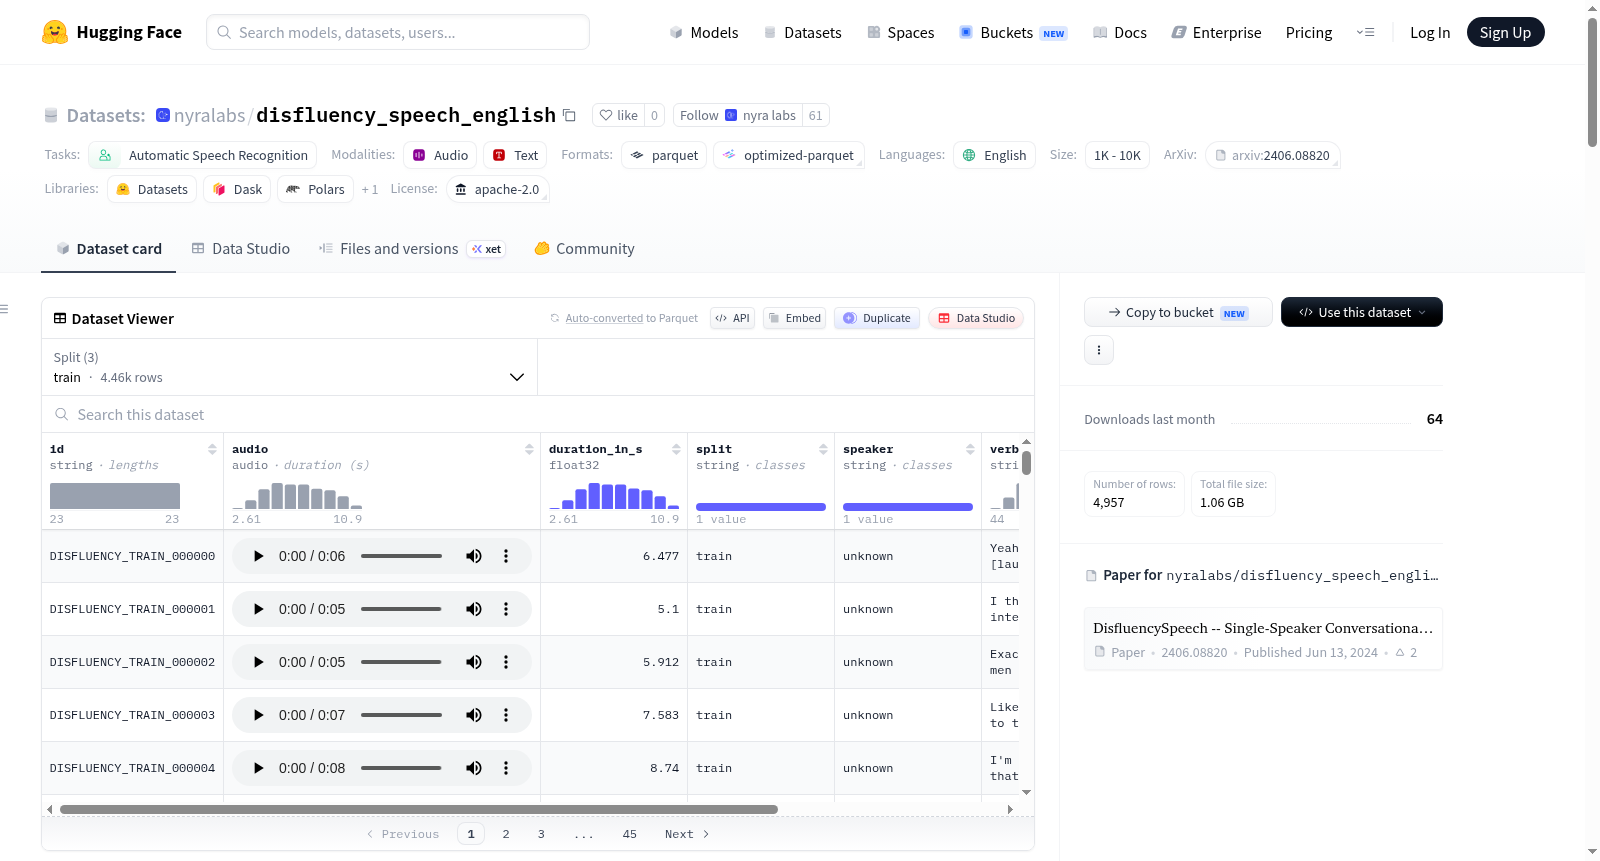
Nyra Disfluency Speech English是一个英语语音数据集,专门用于评估verbatim ASR(逐字自动语音识别)模型。这些模型不仅需要转录说话者的意图词汇,还需包括填充词(如[UH]、[UM])、切断(用*标记,例如th*)、重复以及声音事件(如[laughter]、[breath])。该数据集基于AMAAI Lab的DisfluencySpeech数据集重新格式化,提供了成对的转录:verbatim_transcript(记录说话者实际说的内容,包括所有非流利元素)和intended_transcript(清理后的版本,仅保留说话者的意图意义)。数据集包含4,957个话语,约9.4小时音频,分为训练集(4,458个样本)、验证集(250个样本)和测试集(249个样本)。每个样本包含id、音频、时长、分割集、说话者以及两个转录版本。数据集设计用于Nyra Verbatim Speech Benchmark,以详细评估逐字ASR模型,并分析填充词、声音、切断、重复和意图转录错误。

Nyra Disfluency Speech English is an English speech dataset for evaluating verbatim ASR: models that should transcribe not only the intended words, but also fillers, cutoffs, repetitions, and sound events. This dataset is based on the AMAAI Lab DisfluencySpeech dataset and reformatted for verbatim-transcription benchmarking with paired verbatim_transcript (what the speaker actually said) and intended_transcript (a cleaned version of what the speaker meant to say). It contains 4,957 utterances and about 9.4 hours of audio, split into train (4,458), validation (250), and test (249) sets. Each sample includes features such as id, audio, duration, split, speaker, and the two transcript versions. It is used by the Nyra Verbatim Speech Benchmark for detailed evaluation of verbatim ASR models, breaking errors down into fillers, sounds, cutoffs, repetitions, and intended-transcript failures.
提供机构:
nyralabs
搜集汇总
数据集介绍
nyralabs/disfluency_speech_english 数据集图片
构建方式
基于AMAAI实验室发布的DisfluencySpeech语料库,Nyra Health团队对该数据集进行了重新格式化,以服务于逐字语音识别系统的评估。原始数据集提供了带注释的转录及其多种逐步清理的变体。Nyra版本通过配对verbatim_transcript(实际所说内容)与intended_transcript(意图表达内容),形成了可直接用于逐字ASR评测的标准化格式。数据集的划分包括训练集4,458条、验证集250条和测试集249条,总计4,957条语音样本,涵盖约9.4小时音频。
特点
该数据集的核心价值在于其双转录结构:verbatim_transcript忠实记录说话者的口语,包含填充词(如[UH]、[UM])、截断音(以*标记)、重复、笑声等非语言事件;intended_transcript则剔除所有口语修正痕迹,保留纯净语义。这种配对设计使其能够同时评估逐字转录质量与意图转录准确性。此外,数据集提供了详尽的标签统计,填充词、截断音节及各类声音事件的数量分布清晰,有助于深入剖析ASR系统在不同口语现象上的表现短板。
使用方法
该数据集专为Nyra Verbatim Speech Benchmark评测框架设计。用户在加载数据集后,可利用benchmark工具从verbatim与intended转录对中自动推导出金标准口语标注,并计算逐字词错误率(vWER)与意图词错误率(iWER)。事件级指标可分别衡量填充词、声音事件、截断和重复的识别表现。使用方式包括通过Hugging Face Datasets库直接加载,或调用benchmark仓库中的脚本进行细粒度错误分析。
背景与挑战
背景概述
近年来,随着自动语音识别技术的飞速发展,对口语中非流利现象(如填充词、截断、重复及非语言声音事件)的精准转录需求日益迫切。Nyra Disfluency Speech English数据集正是为应对这一挑战而诞生,由Nyra Health团队于2024年在AMAAI Lab的DisfluencySpeech数据集基础上构建。该数据集聚焦于逐字转录的评估,核心研究问题在于如何准确区分说话者的实际发音与其意图表达,从而推动语音识别系统从传统的流畅文本转录向更贴近真实口语的精细建模演进。数据集包含约9.4小时、4957条语音样本,并精心设计了成对的逐字转录与意图转录标注,为填补口语流利性建模领域的标准化评测空白提供了关键资源,对提升语音助手的自然交互能力具有显著影响力。
当前挑战
该数据集面临的首要挑战来自其核心研究领域:自动语音识别中的非流利现象建模。传统ASR系统往往忽略或标准化填充词、截断等元素,而逐字转录要求在保留这些细节的同时,仍需准确还原说话者的意图,这对现有关键词检测、语言模型及声学模型构成了根本性难题。此外,数据集的构建过程亦非易事:原始DisfluencySpeech虽提供了多种清洗程度的标注,但需统一转化为配对格式,并明确定义截断符号、声音事件标签等约定,确保不同模型间的评测一致性。非流利标签的自动标注(如从成对转录中推导黄金标签)的严谨性也是挑战之一,需避免引入新的ambiguity,同时音频长度仅有9.4小时,对统计显著性的保障与泛化能力的验证亦提出了额外要求。
常用场景
经典使用场景
在自动语音识别(ASR)领域,逐字转录(verbatim transcription)是一项极具挑战性的任务,要求模型不仅捕捉流利的主干内容,还需忠实记录口语中常见的填充词、重复、截断及非语言声事件。Disfluency Speech English 数据集正是为此而生,其经典用途在于评估和比较不同ASR模型对口语不流畅现象的转录能力。通过提供成对的逐字转录与意图转录,研究者可以精确衡量模型在面对真实、含杂语音时的表现,从而推动ASR技术从实验室的理想化场景迈向更贴近人类日常交流的复杂环境。
实际应用
在实际应用中,该数据集最核心的价值在于赋能对口语交互系统,诸如智能语音助手、会议转录工具以及自动字幕生成系统。这些系统需理解包含犹豫、修正和停顿的自然人类语言,才能提供流畅的交互体验。通过在此数据集上训练和评估,开发者可以优化模型对“真实语音”中非流利成分的鲁棒性,从而提升对话系统的自然度和用户满意度。此外,该数据集也为言语障碍辅助技术提供了评测素材,帮助设计更包容的语音接口。
衍生相关工作
围绕该数据集,衍生了一系列重要的学术工作与基准测试。最显著的是 Nyra Verbatim Speech Benchmark,它系统性地定义了逐字转录的评估协议,并基于此数据集实现了自动化的不流畅标签推导、转录度量(如逐字词错误率 vWER 与意图词错误率 iWER)以及事件级指标计算。此外,原始数据集的构建工作 DisfluencySpeech 也是一项关键贡献,它为单说话人对话语音提供了包含副语言注释的丰富资源。这些工作共同推动了口语理解领域的研究,为后续开发更精细的语音模型与评价框架奠定了坚实的基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

