Nav-AdaCoT-2.9M
收藏资源简介:
Nav-AdaCoT-2.9M是由字节跳动种子与北京大学联合构建的目前最大规模具身导航推理标注数据集,包含290万条数据。该数据集创新性地引入了自适应思维链(AdaCoT)标注,指导模型动态决策何时启动推理以及关注哪些关键信息。其数据来源于多模态导航任务中的视觉-语言交互记录,通过专家标注和强化学习阶段增强数据质量。数据集旨在解决复杂长时序导航中推理能力不足和记忆缺失的问题,支撑VLA模型在动态环境中的自适应规划与跨任务迁移学习。
Nav-AdaCoT-2.9M is the largest currently available embodied navigation reasoning annotation dataset jointly developed by ByteDance Seed and Peking University, consisting of 2.9 million data entries. This dataset innovatively introduces adaptive Chain-of-Thought (AdaCoT) annotations, which guide models to dynamically decide when to initiate reasoning and which key information to focus on. Its data is sourced from visual-language interaction logs in multimodal navigation tasks, and the data quality is enhanced through expert annotation and reinforcement learning stages. The dataset is designed to address the issues of insufficient reasoning capability and memory loss in complex long-horizon navigation tasks, and support adaptive planning and cross-task transfer learning of Vision-Language-Action (VLA) models in dynamic environments.
VLingNav 数据集概述
数据集名称
VLingNav
核心简介
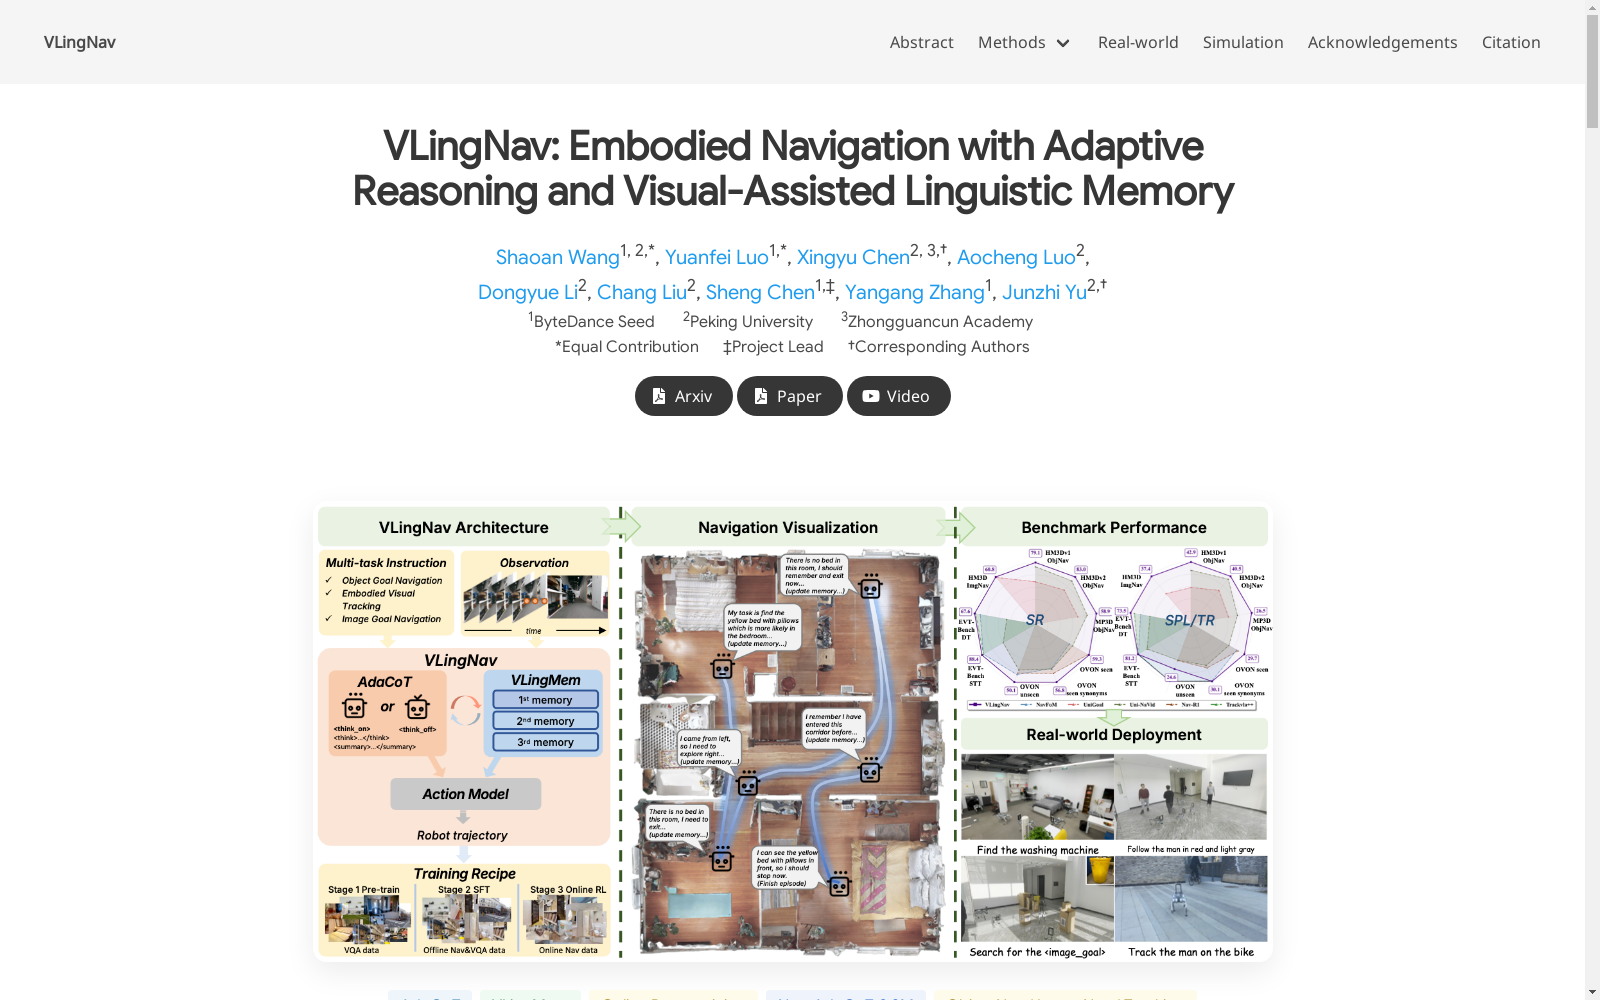
VLingNav 是一个用于具身导航的视觉-语言-动作模型,其核心是基于语言驱动的认知。它旨在解决现有模型在复杂、长视野导航任务中缺乏显式推理能力和持久记忆的问题。
关键方法与组件
- 自适应思维链机制:受人类认知双过程理论启发,该机制能动态地在必要时触发显式推理,使智能体能够在快速、直观的执行与缓慢、审慎的规划之间流畅切换。
- 视觉辅助语言记忆模块:该模块构建了一个持久的跨模态语义记忆,使智能体能够回忆过去的观察,以避免重复探索,并推断动态环境的移动趋势。
训练数据集
- 名称:Nav-AdaCoT-2.9M
- 规模:290万条逐步自适应思维链轨迹
- 描述:这是迄今为止最大的带有推理标注的具身导航数据集,富含自适应思维链标注,能够引导出一种既能调整“何时思考”也能调整“思考什么”的推理范式。
- 构建方法:利用 Habitat 模拟器收集广泛的模拟导航数据,并开发了自动化的思维链标注流程。
训练流程
- 数据收集:构建并使用 Nav-AdaCoT-2.9M 数据集。
- 在线专家引导后训练:为了解决离线模仿学习的局限性,并更好地将视觉语言模型的高级表征与闭环机器人连续动作对齐,引入了在线后训练阶段。智能体主动与模拟环境交互以收集新鲜的、同策略轨迹。策略随后通过结合结果驱动优化和专家引导监督的混合目标函数进行更新。
性能与评估
- 在广泛的具身导航基准测试中实现了最先进的性能。
- 能够以零样本方式迁移到真实世界的机器人平台,成功执行实际的导航任务,包括先前未见和未经训练的任务,并展现出强大的跨领域和跨任务泛化能力。
- 评估任务包括:物体目标导航、图像目标导航、视觉跟踪。
相关资源
- 论文标题:VLingNav: Embodied Navigation with Adaptive Reasoning and Visual-Assisted Linguistic Memory
- 预印本地址:https://arxiv.org/abs/2601.08665
- 作者机构:ByteDance Seed, Peking University, Zhongguancun Academy