
遇见数据集

dramabox-burst-prompts

收藏
Hugging Face2026-09-04 更新2026-09-05 收录
官方服务:

资源简介:

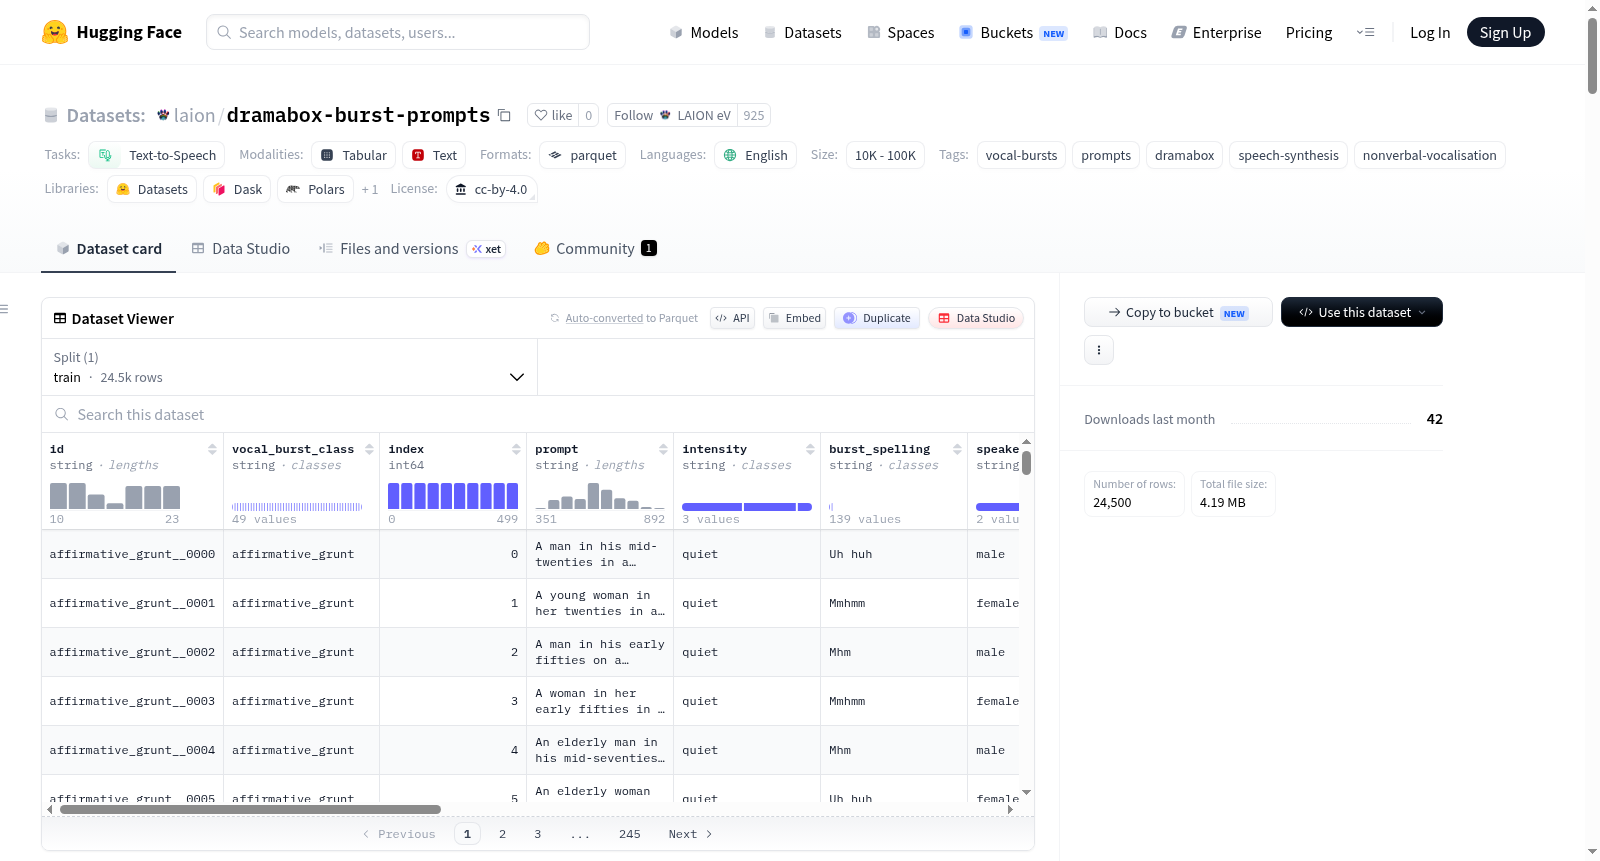
DramaBox 场景提示数据集专为文本到语音合成中的非语言发声(vocal bursts)设计,包含 24,500 个脚本风格场景提示,均匀分布在 49 个发声类别中(每个类别 500 个)。每个提示都通过精心设计的结构确保爆发在正常对话中自然出现,而非孤立音效:提示以平静开场(包含明确的正常语速指令和一句日常对话),随后插入一个非语言发声,大部分场景(62%)在爆发后恢复平静。该数据集旨在修复先前场景中因缺乏平静引入而导致的动态对比不足问题,使模型能够区分“此处有爆发”与“整个话语都很响亮”。数据由 google/gemma-4-31B-it 生成,并通过结构化组合(地点、话题、触发因素、说话者人口统计等)保证多样性。所有提示均经过质量门控(0.9% 拒绝率),确保爆发拼写正确、平静开场符合要求。数据集包含 16 个字段,包括发声类别、强度(loud/mid/quiet)、爆发拼写、说话者性别(男女各半)、年龄组(青年/中年/老年)、地点、触发因素、爆发位置等。提示文本采用 CC BY 4.0 许可,可自由使用;但若使用 DramaBox 模型生成音频,则需遵守 LTX-2 社区许可(可能限制商业用途)。该数据集适用于训练 TTS 模型生成自然融入语音的非语言发声,或用于训练爆发检测器与适配器。

The DramaBox Scene Prompt Dataset is designed for non-verbal vocal bursts in text-to-speech synthesis, containing 24,500 script-style scene prompts uniformly distributed across 49 vocal burst categories (500 per category). Each prompt is carefully structured to ensure the burst appears naturally within normal conversation rather than as an isolated sound effect: the prompt begins calmly (with an explicit instruction for normal speech rate and a daily conversation sentence), then inserts a non-verbal vocal burst, with most scenes (62%) returning to calm after the burst. The dataset aims to address the lack of dynamic contrast caused by the absence of calm introduction in previous scenes, enabling the model to distinguish between there is a burst here and the entire utterance is loud. Data is generated by google/gemma-4-31B-it and diversity is ensured through structured combinations (location, topic, trigger, speaker demographics, etc.). All prompts undergo quality gating (0.9% rejection rate) to ensure correct burst spelling and compliant calm opening. The dataset includes 16 fields, including vocal burst category, intensity (loud/mid/quiet), burst spelling, speaker gender (balanced male/female), age group (young/middle-aged/elderly), location, trigger, burst position, etc. The prompt text is licensed under CC BY 4.0 for free use; however, if using the DramaBox model to generate audio, the LTX-2 Community License must be followed (which may restrict commercial use). The dataset is suitable for training TTS models to generate non-verbal vocal bursts naturally integrated into speech, or for training burst detectors and adapters.
提供机构:
LAION eV
创建时间:
2026-09-04
搜集汇总
数据集介绍
dramabox-burst-prompts 数据集图片
构建方式
该数据集源于对文本到语音合成中非言语发声建模缺陷的系统性回应。研究者观察到,既有戏剧场景提示往往令模型以爆发强度演绎整段对话,致使发声与常规言语的边界模糊,损害了检测器与适配器的训练效能。为解决此问题,构建过程以结构化组合采样为基石,将每一场景锚定于地点、话题与触发事件的唯一三元组,并系统配置说话人性别、年龄段、语域、爆发位置及是否回归平静等维度。全部提示由大型语言模型依循固定指令与三个手写范例逐条生成,并经由质量门控严格筛选,确保开场指令明确传递平静、中等音量的对话交付方式,且开场语句不含任何呼喊、感叹或高唤醒词汇,从而使爆发成为对平静基线的显著偏离。
特点
本数据集的核心特质在于其结构化的多样性设计,而非随机采样。每一个类别内的五百个场景均绑定唯一的地点、话题与触发事件组合,并系统化分配说话人的人口学特征,使得性别与年龄段的分布达到精确平衡,每个类别内的最小与最大单元格仅相差一个提示。所有爆发音均以音素化拼写嵌入引号之内,而声响仅在引号外的舞台指示中被命名,从而规避模型将拟声词误读为实词的风险。平静开场的设置使得爆发在峰值与中位数分贝比上达到约十二分贝,较之无平静引导的先前场景约提升一倍,且该统计量在响、中、静三类中均表现一致,证实了平静基线对相对偏离度的有效放大。
使用方法
该数据集专为文本到语音模型的训练与评测而设计,尤其适用于需要精确控制非言语发声插入位置的场景。使用时,可将提示直接输入兼容的语音合成系统,如参考配置中指定的DramaBox模型,并依照建议参数设定分类器自由引导尺度、时空引导尺度、呼吸因子与参考窗口等超参数,以获得与数据集设计意图一致的音频输出。生成后的音频可用于训练爆发检测器或适配器,亦可作为评测基准,通过峰值与中位数分贝比等指标量化模型对平静开场与爆发偏离的再现能力。值得注意的是,提示文本本身以知识共享署名四点零协议发布,可自由用于任何语音模型,但若使用DramaBox生成音频,则须留意LTX-2社区许可对衍生模型分发的限制条款。
背景与挑战
背景概述
非语言发声(如叹息、喘息、尖叫)是人类语音交流中不可或缺的副语言成分,对其建模长期受限于高质量标注数据的匮乏。2025年,研究团队发布dramabox-burst-prompts数据集,包含24,500条剧本式场景提示,覆盖49类发声,每类500条。该数据集旨在引导文本转语音模型在自然对话中嵌入特定非语言发声,而非孤立音效。其核心创新在于揭示并修正了此前DramaBox模型在突发发声场景中整体提高音量的缺陷,通过强制平静开场建立对比基线,使发声成为相对偏离。该工作为语音合成、情感计算及副语言研究提供了可控、可复现的提示资源,推动了非语言发声生成与检测领域的发展。
当前挑战
该数据集所应对的领域挑战在于,现有语音合成系统难以在连续话语中自然、可控地生成非语言发声,常将整段场景以爆发强度表演,导致发声与对话的边界模糊,训练出的检测器或适配器难以区分突发与常态。构建过程中的挑战同样显著:需确保每条提示均以平静、日常的对话开场,避免任何恐慌或高唤醒词汇;发声需以音素拼写嵌入引号内,且声音名称不得在引号内出现,以防被模型朗读为单词;同时须平衡性别与年龄分布,并严格筛选生成质量。最终,24,500条提示中仅219条因命名发声、缺失突发、开场喊叫等原因被拒绝, rejection率约0.9%,体现了质量门控的有效性。
常用场景
经典使用场景
在语音合成与非言语发声研究领域,如何使文本转语音模型在自然语句内部生成具有动态对比度的爆发式发声,长期构成一项核心挑战。dramabox-burst-prompts数据集最为经典的用途,便是为DramaBox等文本转语音系统提供剧本式场景提示,使其在普通对话的平静基线之上嵌入特定的非言语发声。该数据集涵盖49类爆发发声,每类500条场景提示,总计24,500条。每条提示均以平静的日常对话开场,随后引入目标爆发音,并在62%的场景中回归平静语调,从而在语音信号中形成鲜明的峰值与中位数对比。
解决学术问题
过往的爆发发声生成研究面临一项显著缺陷:模型倾向于将整段场景以爆发强度演绎,致使对话部分同样处于高声喊叫状态,音频所传递的信息退化为“此话语响亮”而非“此处存在爆发音”。这一缺陷严重削弱了爆发检测器与适配器的训练效能。dramabox-burst-prompts通过结构化的提示设计解决了该问题,其每条提示均明确指示平静 conversational 的开场,首个语句为完整的日常话题陈述,且不含任何惊叹或高声成分。实测表明,由该数据集提示生成的音频,其峰值与中位数分贝差中位数达到12.0 dB,显著高于此前无平静引导场景的6.1 dB,为爆发发声的动态对比建模提供了可靠的数据基础。
衍生相关工作
围绕dramabox-burst-prompts数据集,已衍生出一系列与爆发发声合成及评测相关的经典工作。该数据集直接支撑了DramaBox模型在非言语发声生成任务上的参考音频构建与性能验证,并推动了峰值与中位数分贝差这一动态对比度量指标的标准化应用。其所采用的组合式采样策略——将地点、话题、触发因素、说话人属性与爆发位置进行结构化绑定——为后续提示工程研究提供了可复现的范式。数据集中附带的质量门控与拒收样本档案,亦激发了针对生成式语音数据过滤与重采样策略的方法论探讨。相关代码库涵盖类别定义、规格采样、门控、生成、音频合成与对比度测量等模块,构成了完整的可复现研究管线。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

