Nemotron-Math-Proofs-v3-RL
收藏资源简介:
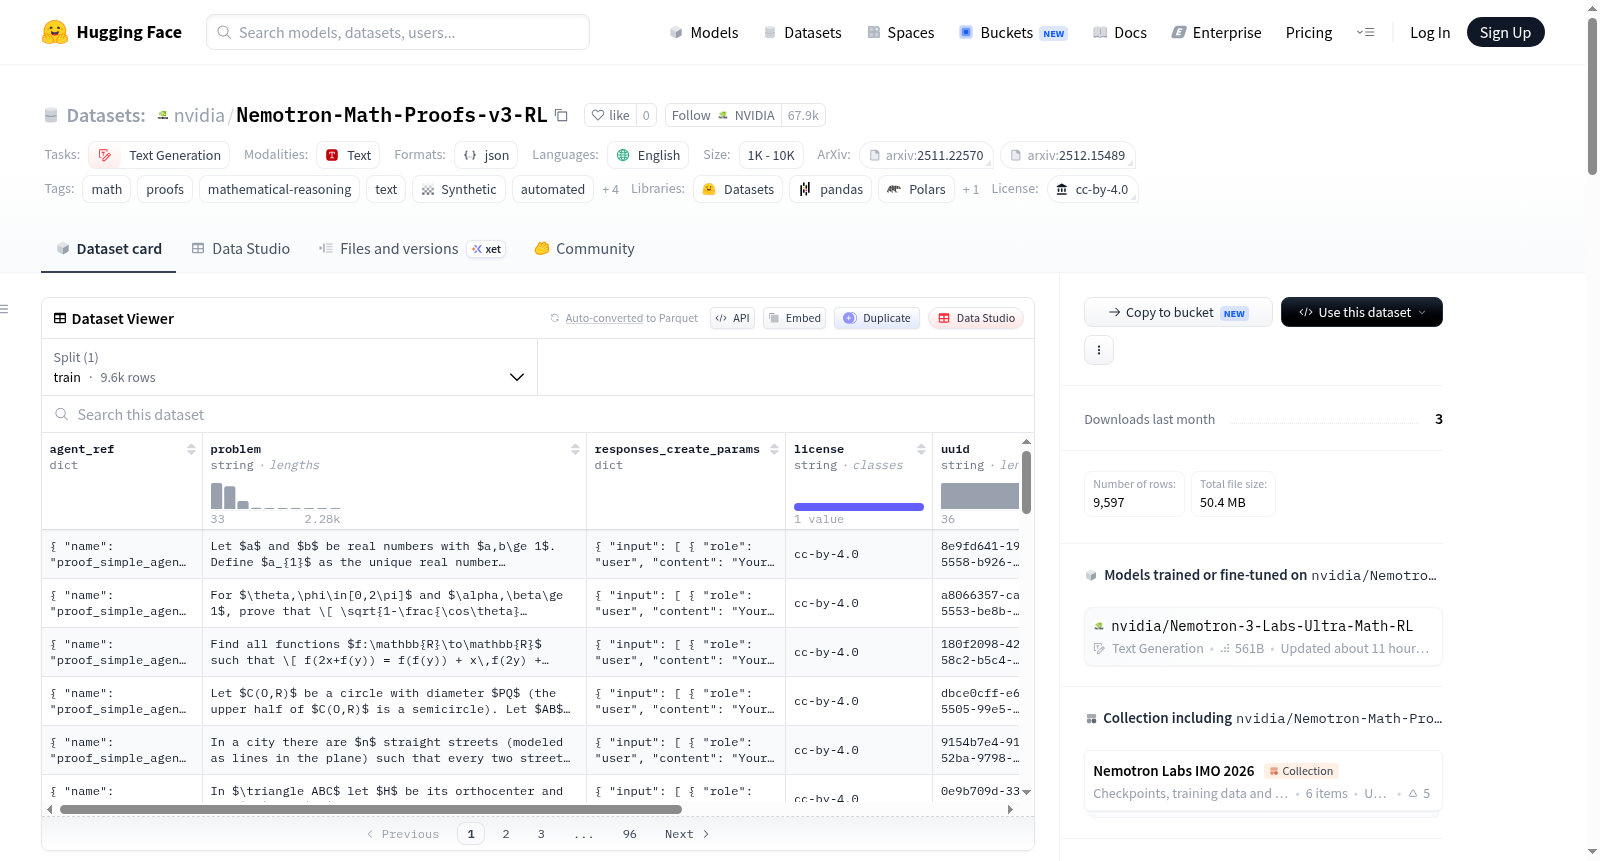
Nemotron-Math-Proofs-v3-RL 是一个用于强化学习的数学推理数据集,专注于长格式数学证明生成。该数据集包含 9,597 个单轮用户提示,这些提示源自 nvidia/Nemotron-Math-Proofs-v1 数据集中来自 AoPS(Art of Problem Solving)社区的困难证明问题。数据集使用 NeMo Gym 兼容格式,每个样本包含一个数学问题(problem),以及用于策略模型生成严格解决方案和自我评估的格式化提示。字段包括 agent_ref(NeMo Gym 代理路由信息)、responses_create_params(单用户消息)、problem(自然语言数学问题)、uuid、license、source、dataset 和 metadata(空列表)。所有记录使用 cc-by-4.0 许可、来源为 AoPS、数据集标识为 Nemotron-Math-Proofs-v3。数据集适用于强化学习训练,通过在线验证器反馈来提升结构化数学推理能力,训练模型生成证明自我评估并识别数学论证中的漏洞。数据以 JSONL 格式存储,仅包含 train 分割(9,597 个样本,磁盘大小约 50.4 MB),不包含策略响应的生成标记。数据集采用混合方法(人工收集、合成、自动化)进行数据收集和标注。该数据集受 Creative Commons Attribution 4.0 International License (CC BY 4.0) 保护,可用于商业或非商业用途。
Nemotron-Math-Proofs-v3-RL is a mathematical reasoning dataset for reinforcement learning, focusing on long-form mathematical proof generation. It contains 9,597 single-turn user prompts derived from difficult proof problems from the AoPS (Art of Problem Solving) community in the nvidia/Nemotron-Math-Proofs-v1 dataset. The dataset uses NeMo Gym-compatible format, with each sample including a math problem (problem) and formatted prompts for generating rigorous solutions and self-evaluation by the policy model. Fields include agent_ref (NeMo Gym agent routing information), responses_create_params (single user message), problem (natural language math problem), uuid, license, source, dataset, and metadata (empty list). All records are licensed under cc-by-4.0, sourced from AoPS, and identified as Nemotron-Math-Proofs-v3. The dataset is suitable for reinforcement learning training to improve structured mathematical reasoning through online verifier feedback, training models to generate proof self-evaluations and identify gaps in mathematical arguments. Data is stored in JSONL format, containing only the train split (9,597 samples, approximately 50.4 MB on disk), without generated tokens from policy responses. Data collection and annotation use a hybrid approach (manual collection, synthesis, automation). The dataset is protected under Creative Commons Attribution 4.0 International License (CC BY 4.0) and can be used for commercial or non-commercial purposes.
Nemotron-Math-Proofs-v3-RL 数据集概述
基本信息
- 数据集名称:Nemotron-Math-Proofs-v3-RL
- 所有者:NVIDIA Corporation
- 创建日期:2026年7月1日
- 许可证:Creative Commons Attribution 4.0 International License (CC BY 4.0)
- 语言:英语
- 任务类型:文本生成
- 数据集规模:1K < 样本数 < 10K
数据集简介
Nemotron-Math-Proofs-v3-RL 是一个用于强化学习的长篇数学推理数据集,包含 9,597 个证明生成提示(proof-generation prompts)。该数据集采用 NeMo Gym 兼容的单轮用户提示格式,提示内容源自 nvidia/Nemotron-Math-Proofs-v1 中来自 AoPS(Art of Problem Solving)社区的难题。训练分割要求策略模型生成严谨的解决方案并进行自我评估,策略响应和实际奖励在训练过程中产生,不存储在文件中。
数据来源
- 问题来源:问题源自 nvidia/Nemotron-Math-Proofs-v1,该数据集收集了来自 AoPS 社区的基于证明的问题,所有记录均标识来源为
AoPS。 - 生成方式:数据采集和标注方法均为混合方式(人工 + 合成 + 自动化)。
数据集结构与格式
- 模态:文本
- 格式:JSONL
- 结构:包含单一的
train分割,内含用于强化学习的证明生成提示
字段说明
| 字段 | 描述 |
|---|---|
agent_ref |
NeMo Gym 智能体路由信息 |
responses_create_params |
包含格式化策略提示的单个用户消息 |
problem |
自然语言的数学问题 |
uuid, license, source, dataset |
记录标识和发布来源字段(分别为 cc-by-4.0、AoPS、Nemotron-Math-Proofs-v3) |
metadata |
发布文件中的空列表 |
样本数量统计
- train 分割:9,597 个样本,9,597 个唯一问题,磁盘占用 50,430,007 字节
版本关系
- 前序版本:
- nvidia/Nemotron-Math-Proofs-v1:本数据集问题的来源
- nvidia/Nemotron-Math-Proofs-v2:前一个发布版本
- nvidia/Nemotron-Cascade-2-SFT-Data:包含来自相同来源问题的自然语言证明子集
- 版本关系说明:本次发布在 Nemotron-Math-Proofs-v1 使用的同一系列难题基础上,新增了用于证明生成的强化学习数据。
预期用途
- 利用在线验证器反馈进行结构化数学推理和证明生成的强化学习
- 训练大语言模型生成证明自我评估并识别数学论证中的缺陷
- 用于可验证奖励的证明生成和强化学习研究
参考资源
- 技术报告:An Open Recipe for IMO Gold: Training Nemotron for Olympiad Mathematics(https://github.com/NVIDIA-NeMo/Skills/blob/main/recipes/nemotron-imo-tts/paper.pdf)
- 相关数据集和模型链接已省略(同前例)
伦理考量
NVIDIA 强调可信 AI 是共同责任,并已建立相应政策与实践。开发者应与其内部开发团队协作,确保该数据集满足相关行业和用例的要求,并应对潜在的误用风险。质量问题、风险、安全漏洞或 AI 相关关切可通过 NVIDIA 官方渠道报告。