
WithinUsAI/GOT_HQ_Merged_75k
收藏官方服务:
资源简介:
HQ-Merged-Dataset:一个高质量合并数据集,每次运行时从16个不同来源(涵盖代码、推理、指令、数学和网络文本领域)各采样5,000个示例,将它们规范化为统一模式,并将结果推送到Hugging Face。
HQ-Merged-Dataset: A high-quality merged dataset combining 5,000 sampled examples from 16 diverse sources spanning code, reasoning, instruction, math, and web text domains. Fresh samples are pulled on each run.
提供机构:
WithinUsAI搜集汇总
数据集介绍
构建方式
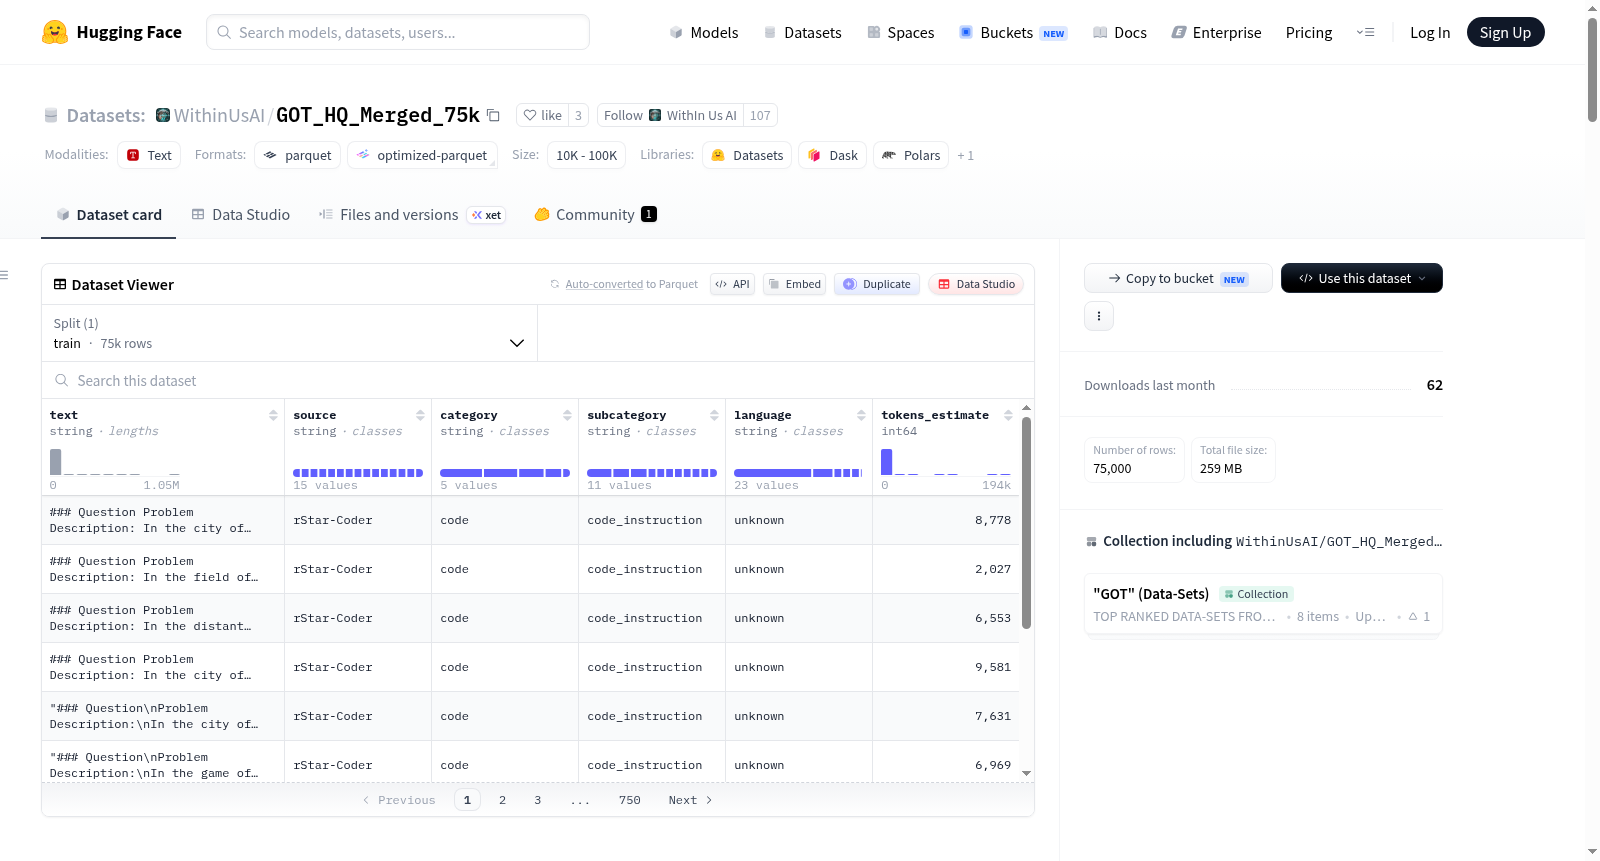
在大型语言模型训练数据日益多元化的背景下,GOT_HQ_Merged_75k数据集应运而生,旨在通过整合多源高质量语料构建统一的训练资源。该数据集从涵盖代码、推理、指令、数学及文本五大领域的16个权威源数据集中,采用固定随机种子(seed=42)对每个源进行洗牌后,各自抽取5,000条样本,最终汇聚成包含75,000条记录的高质量混合数据集。所有样本被标准化为统一的Schema,包含文本内容、来源标识、类别标签、子类别、语言及预估token数等字段,并整体以MIT许可证发布在Hugging Face平台上。
特点
GOT_HQ_Merged_75k数据集最显著的特点在于其高度的领域多样性与数据质量的平衡。其来源覆盖了从编程竞赛解答(如Nemotron-CP-v2)、代码推理轨迹(如rStar-Coder)到通用文本语料(如FineWeb、Wikipedia)等16个不同风格的子集,确保了模型在代码生成、数学推理、指令跟随及开放域文本理解等多任务上的泛化能力。类别分布上,推理类数据占比最高(约25,000条),代码与文本类紧随其后,形成了层次分明的知识结构。此外,每次运行均可重新抽取新鲜样本,兼顾了数据生成的确定性与可更新性。
使用方法
使用GOT_HQ_Merged_75k数据集极为便捷,用户可通过Hugging Face的datasets库直接加载:使用load_dataset函数指定数据集标识符即可获取完整训练集。针对特定需求,可利用filter方法按类别(如code、reasoning)筛选子集,或根据source字段定向使用某个源的数据。数据集在预处理阶段已为每条样本提供预估token数,便于进行批次构建与训练预算控制。值得注意的是,尽管合并数据集本身采用MIT许可证,但各子集均保留其原始许可条款,用户在商业化或二次分发时应逐一核查上游许可。
背景与挑战
背景概述
GOT_HQ_Merged_75k数据集于2026年发布,由开源社区成员GODsStrongestSoldier创建,旨在解决多源异构数据整合这一大语言模型训练中的核心瓶颈。该数据集从微软、英伟达、阿里巴巴、OpenAssistant等机构发布的16个高质量数据源中,各均匀采样5000条样本,覆盖代码、推理、指令、数学与网页文本五大领域,最终融合为75,000条标准化实例。其统一的数据模式与平衡的类别分布为多任务学习提供了坚实基础,在代码生成、数学推理、指令跟随等场景展现出广泛的应用潜力,成为连接分散数据源与统一模型训练的重要桥梁。
当前挑战
数据集面临的首要挑战是多源数据异构性的融合难题。来自The Stack、CommonCrawl等语料库的样本在格式、粒度与质量上差异显著,需设计通用schema实现无损归一化,同时保留源代码的头部信息、推理链的逐步逻辑等关键结构。其次,采样策略的平衡性至关重要,既要避免某些领域(如数学仅5000条)代表性不足,又需抑制规模过大源(如FineWeb的15T tokens)带来的数据偏差。此外,各源许可证的兼容性(如NVIDIA专有许可与MIT、Apache 2.0的混用)对数据集的合规发布构成潜在障碍,要求构建过程严格遵循来源协议。
常用场景
经典使用场景
GOT_HQ_Merged_75k数据集汇聚了来自代码、推理、指令、数学和文本五大领域的16个高质量子数据集,每个来源均匀采样5000条样本,形成75,000条统一格式的高质量实例。在自然语言处理与人工智能研究中,该数据集最经典的应用场景之一是多任务监督微调(Multi-Task Supervised Fine-Tuning),研究者可基于其结构化的类别标签,分别训练面向代码生成(如rStar-Coder、the-stack)、复杂推理(如OpenThoughts-114k、Superior-Reasoning)、指令遵循(如OASST1、OpenOrca)和数学解题(如Orca-Math)的专项模型,亦可混合全部数据以增强模型在多样化任务上的泛化能力。统一的text、category、source等字段设计,使得数据加载与过滤十分便捷,无需额外清洗即可投入训练。
解决学术问题
该数据集有效解决了多源异构高质量数据难以统一获取与高效利用这一长期困扰学术界的核心难题。过去,研究者在进行大语言模型预训练或微调时,往往需要分别从Hugging Face、GitHub等多个平台手动收集并清洗数据,来源间的格式差异、许可协议不一以及数据质量问题严重阻碍了研究进展。GOT_HQ_Merged_75k通过从16个精心挑选的权威子数据集中各取5000条样本,并标准化为统一的schema,消除了数据预处理壁垒,使研究者能直接聚焦于模型架构设计、训练策略优化与评估方法创新。其意义在于显著降低了高质量多任务数据集的使用门槛,推动了指令微调、链式思维推理和多领域泛化等方向的大规模实证研究,为复现和对比前沿工作提供了公平、可靠的数据基础。
衍生相关工作
自GOT_HQ_Merged_75k发布以来,它已催生了一系列富有影响力的后续研究。许多学者直接基于该数据集进行多任务微调,验证了混合多源数据对提升模型整体表现的有效性,并由此提出了更先进的数据混合策略和采样算法。例如,有工作在此基础上研究了数据类别比例对下游任务性能的影响,发现了代码与推理数据在提升逻辑一致性方面的协同效应。另有团队以该数据集为基准,设计了专门针对多语言与多模态扩展的融合训练框架。在推理增强方向,研究者利用其丰富的链式推理样本(如来自OpenThoughts-114k与Superior-Reasoning的数据)进一步蒸馏出更紧凑的推理模型,推动了边缘设备上的智能应用。此外,该数据集的统一schema设计也被后续构建更大规模聚合数据集的直接参考,促进了社区中数据标准化的共识形成。
以上内容由遇见数据集搜集并总结生成


