
遇见数据集

LiteFold/ProteinGym

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

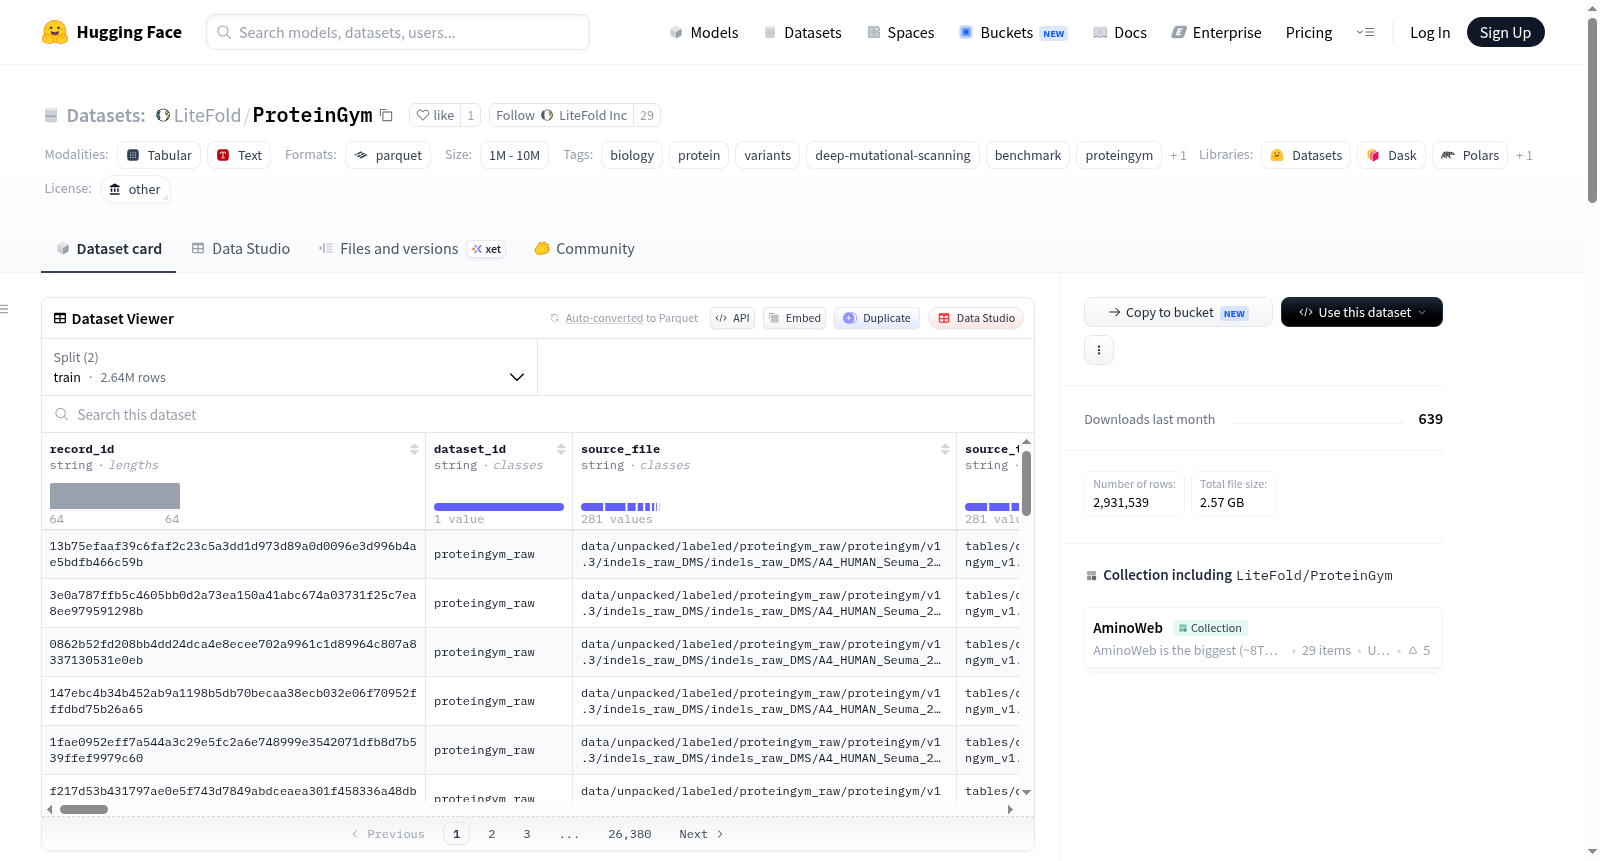
ProteinGym是一个用于评估蛋白质适应性和突变效应预测器的标准基准套件,由OATML/Marks实验室开发,并于NeurIPS 2023数据集和基准赛道发布。它是比较蛋白质语言模型(如ESM、Tranception、ProGen等)、逆折叠模型和监督适应度预测器在共同标准化任务面上的首选参考,覆盖零样本和监督设置。基准分为四个轨道:DMS substitutions轨道收集了超过200个深度突变扫描实验,涵盖约270万个错义变异,涉及多种蛋白质(酶、病毒蛋白、人类疾病基因、抗体、从头设计);DMS indels轨道增加了约70个实验,包含约30万个插入或缺失变异;两个临床轨道(substitutions和indels)提供来自ClinVar(致病性与良性)和gnomAD(常见良性对照)的专家注释变异,以便评估适应度模型的临床实用性,而不仅仅是实验相关性。每个实验提供野生型序列、每个变异的适应度分数、预计算的多序列比对(ColabFold和EVE风格对齐)、可用的结构元数据,以及多个难度级别的标准化交叉验证分割(随机、模数、连续)。性能报告使用Spearman、AUC、MCC、NDCG@10%和Top-K召回率来捕捉排名质量和设计相关检索,proteingym.org上的公共排行榜跟踪各轨道约80多个模型。

ProteinGym is the standard benchmark suite for evaluating protein fitness and mutation effect predictors, developed by the OATML / Marks lab and published at NeurIPS 2023 Datasets and Benchmarks. It is the go-to reference for comparing protein language models (ESM, Tranception, ProGen, etc.), inverse folding models, and supervised fitness predictors on a common, standardized task surface, and it covers both zero-shot and supervised settings. The benchmark is split into four tracks. The DMS substitutions track collects more than 200 deep mutational scanning assays covering roughly 2.7 million missense variants across diverse proteins (enzymes, viral proteins, human disease genes, antibodies, de novo designs). The DMS indels track adds around 70 assays with ~300k insertion or deletion variants. Two clinical tracks (substitutions and indels) provide expert-annotated variants from ClinVar (pathogenic vs. benign) and gnomAD (frequent benign controls), so that fitness models can be evaluated for clinical utility, not just experimental correlation. For each assay, ProteinGym ships the wild-type sequence, a per-variant fitness score, precomputed MSAs (ColabFold and EVE-style alignments), structural metadata where available, and standardized cross-validation splits at multiple difficulty levels (random, modulo, contiguous). Performance is reported with Spearman, AUC, MCC, NDCG@10%, and Top-K recall to capture both ranking quality and design-relevant retrieval, and a public leaderboard at proteingym.org tracks roughly 80+ models across tracks.
提供机构:
LiteFold
搜集汇总
数据集介绍
LiteFold/ProteinGym 数据集图片
构建方式
ProteinGym数据集由OATML与Marks实验室联合开发,于NeurIPS 2023数据集与基准赛道正式发布。其构建立足于大规模深度突变扫描实验的整合,汇聚逾200项酶、病毒蛋白、人类疾病基因、抗体及全新设计蛋白的错义突变测定数据,涵盖约270万个变异位点。除错义突变轨道外,数据集中纳入了约70项插入缺失突变实验,以及源自ClinVar与gnomAD的临床注释变异信息。每个实验均配备野生型序列、变异适应性评分、预计算的多序列比对(涵盖ColabFold与EVE风格比对)、结构元数据及多难度级别的标准化交叉验证划分,基于记录标识符的SHA-256哈希值进行确定性分割,以保障评估的公平与可复现性。
特点
ProteinGym作为蛋白质适应性与突变效应预测领域的权威基准套件,其核心特色在于统一的评估界面与多元评价体系。数据集采用零样本与监督学习双轨设计,支持蛋白质语言模型、逆向折叠模型及监督预测器的横向比较。性能度量涵盖Spearman秩相关系数、AUC、MCC、NDCG@10%及Top-K召回率,兼顾排序质量与设计导向检索能力。公开排行榜实时追踪80余个模型在各轨道的表现,为领域进展提供量化参照。数据集在数数据全面性、评估标准化与实用导向性方面展现出显著优势,成为蛋白质功能预测研究的核心参考。
使用方法
使用者可通过HuggingFace Datasets库便捷加载ProteinGym,基本调用语句为`load_dataset("LiteFold/ProteinGym")`,即可获取训练集与测试集。支持按需选取列子集,例如仅保留记录标识符、突变信息、序列及评分值等核心字段。对于流式加载场景,可启用streaming=True参数以高效处理大规模数据。原始源字段通过JSON格式内嵌于raw_row_json列,便于深度访问与自定义解析。数据集内置table_group字段,支持按实验类型(如错义突变或临床轨道)进行过滤,同时提供独立的元数据表,涵盖列映射与源表行计数,便于分析与集成。
背景与挑战
背景概述
蛋白质功能预测与突变效应评估是计算生物学领域的核心议题,直接关联到药物研发、疾病机理解析及蛋白质工程等前沿方向。由牛津大学OATML实验室与哈佛医学院Marks实验室主导研发的ProteinGym基准测试集,于2023年发表于NeurIPS Datasets and Benchmarks,迅速成为该领域最具权威性的标准化评估平台。该数据集系统整合了超过200项深度突变扫描(DMS)实验数据,覆盖约270万错义突变,并创新性地纳入插入/缺失突变(indels)与临床注释突变(ClinVar、gnomAD),全面支持蛋白质语言模型(如ESM、Tranception)、逆折叠模型及监督式预测器的零样本与监督学习性能比较。ProteinGym通过统一的任务界面与标准化评估指标,显著推动了蛋白质适应度预测模型的可比性与可重复性研究。
当前挑战
ProteinGym所应对的核心领域挑战在于:其一,蛋白质适应度预测涉及多样化突变类型(替换、插入、缺失)与复杂生物背景,现有模型在跨蛋白家族、跨突变类别的泛化能力仍存瓶颈,尤其是临床场景下致病与良性突变的判别效能亟待提升。其二,构建过程中面临数据异构性难题——来自不同实验平台的DMS数据在实验设计、测序深度、评分尺度上高度不一致,需通过严格的质量过滤与标准化流程(如交叉验证分桶策略)消除批次效应。此外,数据集规模的激增(近300万样本、118个字段)对存储效率、检索速度及多模态元数据(MSA、结构文件)的整合提出了严峻挑战,推动计算基础设施与数据处理流水线的持续优化。
常用场景
经典使用场景
ProteinGym 是评估蛋白质适应性及突变效应预测器性能的标杆基准测试集合,在 NeurIPS 2023 数据集与基准轨道中正式发布。该数据集整合了超过 200 个深度突变扫描实验,涵盖约 270 万个错义变体,覆盖酶、病毒蛋白、人类疾病基因、抗体及从头设计蛋白等多样化的蛋白质类型。经典使用场景聚焦于零样本预测与有监督预测两大范式,通过提供标准化的交叉验证划分(随机、模数、连续)和统一评价指标(Spearman 相关系数、AUC、MCC、NDCG@10% 及 Top-K 召回率),使研究者能够在共同的任务表面对比蛋白质语言模型(如 ESM、Tranception、ProGen)、逆折叠模型及有监督适应性预测器的表现。数据集还包含临床变体子集(ClinVar 致病/良性、gnomAD 高频良性对照),使模型评估不局限于实验相关性,更延伸至临床实用价值。
衍生相关工作
ProteinGym 的发布催生了一系列以此为基准的后续研究工作。在零样本预测方向,Tranception 模型利用检索增强策略在该数据集上展现了超越传统 MSA 方法的性能,后续进一步演进为 TranceptEVE 融合模型,结合进化与深度学习的优势。ESM-2 与 ESM-1v 系列的单序列预测能力在 ProteinGym 上得到系统验证,为无需 MSA 的快速推理奠定了基础。在有监督预测领域,GEMME、DeepSequence 及 EVE 等基于进化潜变量的方法在该数据集上被重新评估与改进,并推动了融合无监督与有监督信息的混合策略(如 MSA Transformer 的微调变体)。临床变体子集直接启发了 ClinPred、PrimateAI 及 AlphaMissense 等方法的临床实用性评价研究,促使模型训练向医疗基因变异解读倾斜。蛋白质设计方面,ProteinGym 被用作逆折叠模型(如 ProteinMPNN、ESM-IF)的输入条件评价,检验生成序列的功能保留能力,进而催生了结合语言模型与结构先验的更优设计范式。
数据集最近研究
最新研究方向
ProteinGym作为蛋白质适应度预测与突变效应评估的权威基准,当前研究前沿聚焦于蛋白质语言模型(如ESM、Tranception)在零样本与监督学习场景下的泛化能力,以及逆折叠模型在蛋白质设计中的表现。近期热点包括利用该基准比较模型在临床变异(ClinVar、gnomAD)上的预测准确性与临床实用性,推动蛋白质工程与精准医疗的交叉融合。其大规模替代和插入缺失突变数据(覆盖逾200个深度突变扫描实验及约270万错义变异)为评估模型在多样性蛋白(如酶、病毒蛋白、抗体)上的鲁棒性提供了标准化平台。该基准的深远意义在于系统性地标准化了蛋白质适应度预测的方法论,加速了AI驱动蛋白质设计的实用性转化,为合成生物学与药物发现领域奠定了可靠评估基石。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

