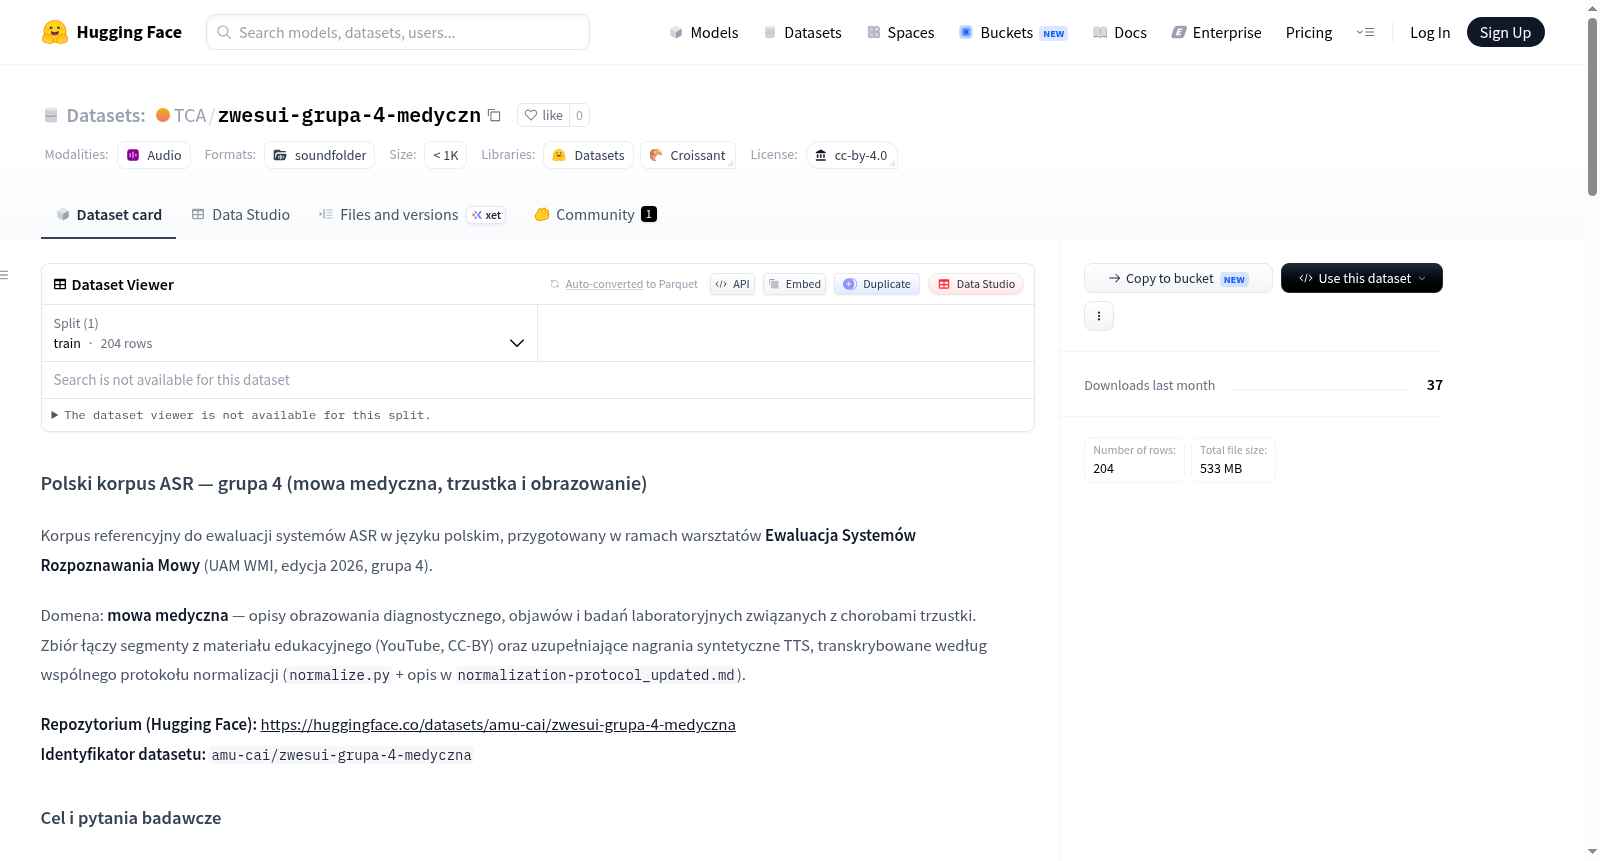
zwesui-grupa-4-medyczn
收藏资源简介:
该数据集是一个专门用于评估波兰语自动语音识别(ASR)系统的参考语料库,聚焦于医学领域,特别是胰腺相关疾病、诊断影像学(如超声、CT、MRI)描述以及实验室检查结果(如胰腺酶、炎症参数)的术语。数据集在语音识别系统评估研讨会(UAM WMI,2026版,第4组)框架下创建,旨在为波兰语医学领域ASR提供标准化的测试基准。数据内容由波兰语的短语音片段构成,主题紧密围绕胰腺医学、影像诊断、临床症状及检验报告。音频来源包含两类:一是从遵循CC-BY许可的YouTube教育视频中截取的片段(标记为youtube),二是为补充特定领域内容而生成的合成语音(标记为edge_tts)。所有语音片段的转录文本均依据统一的规范化协议进行处理,确保作为ASR评估参考文本的一致性。数据集中还包含了丰富的元数据,如匿名化的标注者与验证者标识符、音频来源URL、对应的许可证信息,并将语音类型统一标注为read(朗读语音)。数据集以结构化文件形式组织:音频文件为16 kHz单声道PCM格式的WAV文件,存放于`audio/pl/`目录下;转录及元数据则存储于`transcript/pl/test.tsv`的TSV文件中。该TSV文件包含16个字段,遵循特定的数据模式,核心字段包括音频文件路径、规范化后的参考转录文本、固定领域标签medyczna(医学)、音频来源、语音类型、标注与验证者匿名ID、以及来源链接与许可证。该数据集主要适用于波兰语ASR模型的性能评估、比较研究和基准测试,尤其适用于分析模型在专业医学术语、数字单位、缩写等方面的识别能力,以及探究不同音频来源(自然人类语音与合成语音)对识别错误率(WER/CER)的影响。使用本数据集时需注意其局限性:领域范围较窄(集中于胰腺相关医学),可能限制其向其他医学子领域的泛化能力;YouTube来源的音频质量可能参差不齐;合成语音的声学特征可能与真实人声存在差异;数据存在一定的主题与词汇偏差;且采用的文本规范化规则会直接影响评估指标的计算结果,在进行跨模型或跨研究比较时需确保使用相同的预处理协议。数据集整体采用CC-BY 4.0许可证发布。
数据集概述:Polski korpus ASR — grupa 4 (mowa medyczna, trzustka i obrazowanie)
- 数据集标识符:
amu-cai/zwesui-grupa-4-medyczna - 语言: 波兰语
- 领域: 医学(专注于胰腺、诊断影像、症状及实验室检查)
- 许可证: CC-BY-4.0
- 数据集来源: https://huggingface.co/datasets/amu-cai/zwesui-grupa-4-medyczna
目的与研究方向
该数据集是一个参考性测试集,用于评估波兰语自动语音识别(ASR)系统在医学领域的表现。特别关注胰腺疾病、影像学检查(如USG、CT、MRI)及相关实验室结果(如胰腺酶、炎症参数)相关术语。
主要目标包括:
- 在标准化协议下比较不同ASR模型的表现。
- 识别典型错误来源(专业术语、数字与单位、缩写、检查名称)。
- 评估音频来源类型(YouTube vs TTS)对WER/CER的影响。
示例研究问题:
- 医学领域(专业术语)相比通用波兰语语料库,对WER/CER的恶化程度如何?
- 哪类词元最困难:数字、单位、检查缩写、解剖名称、药物?
- ASR结果在YouTube录音(自然条件)与TTS(清晰发音)之间是否存在显著差异?
- 哪些模型(如Whisper、Conformer、wav2vec2)对医学词汇最鲁棒?
- 标准化协议(如数字写法、标点、缩写)如何影响报告的WER/CER?
数据集描述
数据集由短时长的波兰语语音片段组成,内容与医学领域相关(胰腺、诊断影像、症状及检查结果)。
音频来源:
youtube:从YouTube教育视频中截取的片段(CC-BY许可证,每段音频在source_url中附有链接)。edge_tts:合成的补充音频。
标注与验证:
- 转录根据标准化协议(
normalize.py,normalization-protocol_updated.md)准备并标准化。 annotator和verified_by字段使用化名anon_<8hex>(伪匿名化)。- 每段音频附有来源与许可证元数据(
source_url,source_license),支持来源审计。
分段标准:
- 片段应为连贯的短语或句子(
speech_type=read)。 - 避免在单词中间截断或语音重叠占主导的部分。
- 偏好清晰度足够进行可靠转录的片段。
文件结构
audio/pl/grupa4-yt-NNNN.wav:来自YouTube的音频片段。audio/pl/grupa4-tts-NNNN.wav:合成音频片段。transcript/pl/test.tsv:包含16个字段的TSV文件。
TSV字段说明:
| 字段 | 说明 |
|---|---|
path |
16 kHz单声道PCM WAV文件的相对路径 |
sentence |
标准化后的转录(ASR参考文本) |
domain |
medyczna(医学) |
source |
youtube或edge_tts |
speech_type |
read(朗读语音) |
annotator, verified_by |
化名anon_<hash> |
source_url, source_license |
音频来源及许可证 |
局限性
- 领域限制: 数据集聚焦于狭窄的医学子领域(胰腺与诊断影像),结果可能不泛化到其他专业。
- 音频来源: YouTube音频可能包含噪声、压缩、口音变化及录音条件差异,影响与录音室录音的可比性。
- TTS数据: 合成数据在声学和韵律上可能与人类语音不同,模型可能在这些数据上获得异常好的表现。
- 主题与词汇偏差: 特定术语和句型过度代表,可能偏向于在类似数据上微调的模型。
- 标准化影响: 标准化规则(如数字写法、单位、标点)影响WER/CER结果;比较应使用完全相同的协议。
个人数据与GDPR
annotator和verified_by字段已伪匿名化(SHA-256 + 盐值,格式anon_<8hex>)。- YouTube音频使用CC-BY许可证(链接见
source_url)。 - TTS录音不包含人类声音;脚本文本由团队编写。
引用
bibtex @misc{zwesui-grupa-4-medyczna, title = {Polski korpus ASR — grupa 4 (mowa medyczna, trzustka i obrazowanie)}, author = {Zespół grupa 4, Warsztaty ASR UAM WMI 2026}, year = {2026}, url = {https://huggingface.co/datasets/amu-cai/zwesui-grupa-4-medyczna}, note = {Hugging Face dataset amu-cai/zwesui-grupa-4-medyczna} }
联系与代码
实验仓库:https://git.wmi.amu.edu.pl/s512760/projekt-grupa4-Warsztaty-z-ewaluacji-asr