
遇见数据集

laion-voice-profiles-dpo-cfg

收藏
Hugging Face2026-09-10 更新2026-09-11 收录
官方服务:

资源简介:

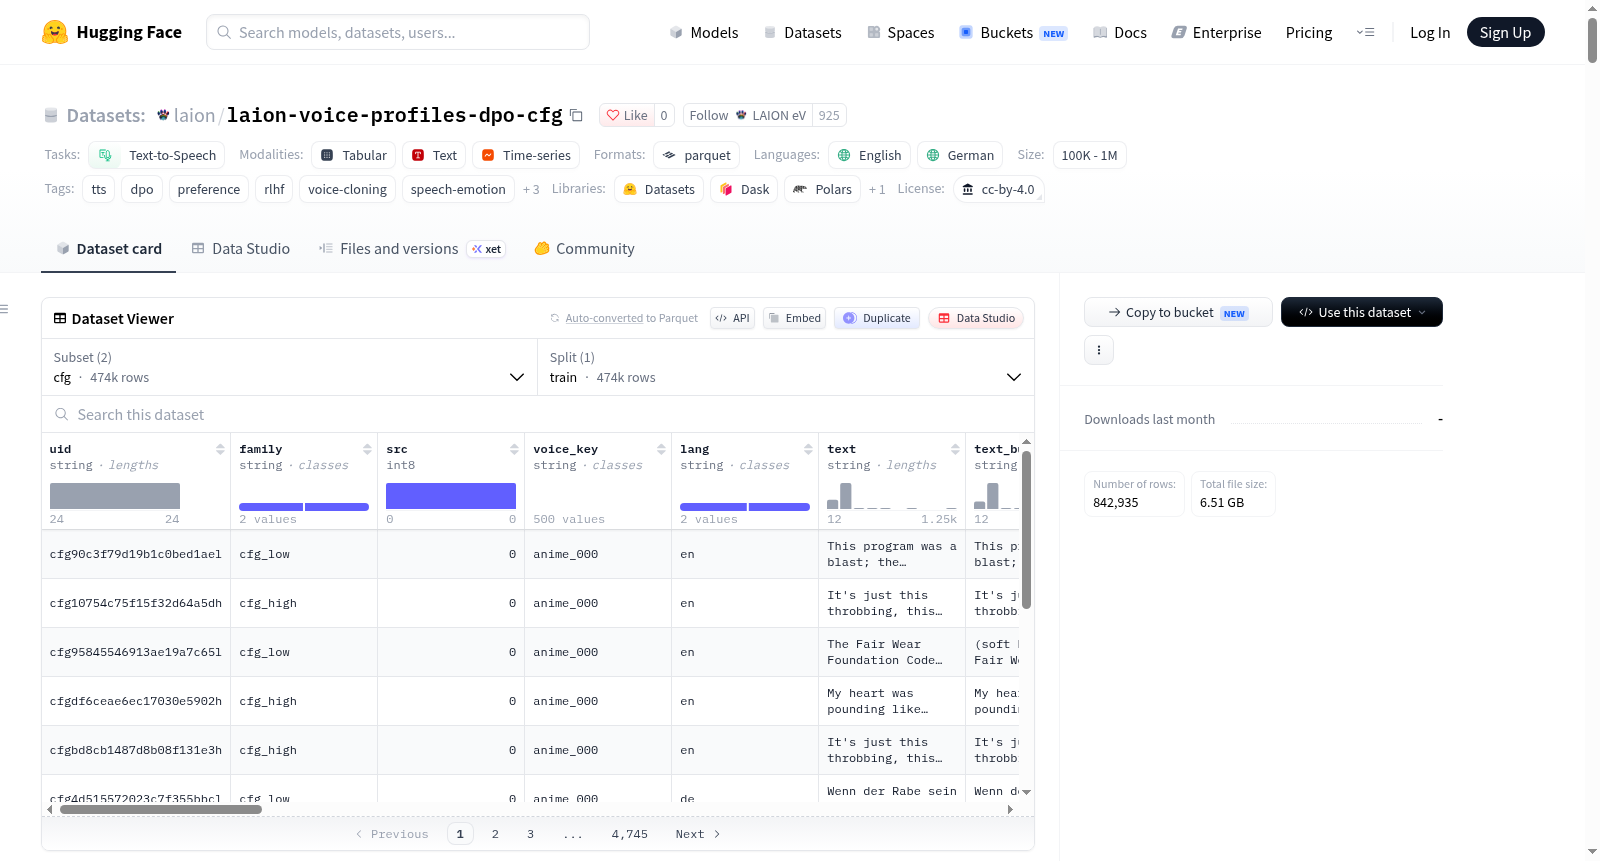
该数据集是LAION Voice Profiles项目的一部分,名为“LAION Voice Profiles — contrastive DPO pairs (CFG + phase 2)”,由Christoph Schuhmann和LAION团队创建。它包含842,935个偏好对(preference pairs),分为四个家族:cfg_high(237,209对)、cfg_low(237,209对)、p2_emox(309,128对)和p2_len(59,389对)。这些数据基于与`laion/laion-voice-profiles-sft`和`laion/laion-voice-profiles-dpo`相同的500个合成语音profile,但专注于强度对比和选择性,以解决之前模型中的缺陷。数据集以两个配置(config)形式提供:`cfg`(包含cfg_high和cfg_low)和`p2`(包含p2_emox和p2_len)。每个配置包含128个parquet分片(shard),采用`zstd`压缩,共计31列。所有样本均为机器生成,语言为英语和德语。数据集的列包括:`uid`(唯一对ID)、`family`(家族名称)、`src`(源组,均为0,表示合成语音profile)、`voice_key`(语音profile ID,500个之一)、`lang`(所选剪辑的语言)、`text`(所选剪辑的生成文本)、`caption_general`(强度陈述)、`frames`(MOSS帧数)、`ref_codes`(参考剪辑的MOSS代码)、`codes`(所选剪辑代码)、`rej_codes`(被拒绝剪辑代码)等。该数据集适用于文本转语音(TTS)任务中的偏好优化、DPO训练、语音克隆、语音情感控制等场景。

This dataset is part of the LAION Voice Profiles project, named LAION Voice Profiles — contrastive DPO pairs (CFG + phase 2), created by Christoph Schuhmann and the LAION team. It contains 842,935 preference pairs, divided into four families: cfg_high (237,209 pairs), cfg_low (237,209 pairs), p2_emox (309,128 pairs), and p2_len (59,389 pairs). The data is based on the same 500 synthetic voice profiles as laion/laion-voice-profiles-sft and laion/laion-voice-profiles-dpo, but focuses on intensity contrast and selectivity to address previous model deficiencies. The dataset is provided in two configurations: cfg (including cfg_high and cfg_low) and p2 (including p2_emox and p2_len). Each configuration contains 128 parquet shards compressed with zstd, totaling 31 columns. All samples are machine-generated, and the languages are English and German. Columns include: uid (unique pair ID), family (family name), src (source group, always 0 for synthetic voice profiles), voice_key (voice profile ID, one of 500), lang (language of the selected clip), text (generated text of the selected clip), caption_general (intensity statement), frames (MOSS frame count), ref_codes (MOSS codes of reference clip), codes (selected clip codes), rej_codes (rejected clip codes), etc. The dataset is suitable for preference optimization, DPO training, voice cloning, voice emotion control, and other tasks in text-to-speech (TTS) scenarios.
提供机构:
LAION eV
创建时间:
2026-09-10
搜集汇总
数据集介绍
laion-voice-profiles-dpo-cfg 数据集图片
构建方式
该数据集根植于语音合成与偏好优化领域,依托500个合成语音档案构建了842,935个偏好对。构建过程以同一说话人的两个片段为单元,在40个情感维度和15个VoiceNet序数维度上,依据标注模型对成品音频的实测值进行分位数筛选,取该说话人自身分布的前1%与后1%形成极端对比,并严格控制帧长差异在10%以内、移除文本信息以阻断转录线索。每对样本均包含MOSS音频编解码器表示、参考片段编码及方向性指令,且同一基础对以角色互换方式双向发射,确保偏好信号无法由音量或密度等简单策略决定。
特点
数据集的核心特质在于将强度本身注入偏好信号,而非仅描述情感类别。cfg家族催生了方向性对比,同一对中高水平与低水平片段仅在一个测量维度上分化,且每个片段在一行中被选、在另一行中被拒,迫使策略必须依据指令条件化。p2家族则针对已有模型的缺陷设计:emox家族令两个情感各自强烈的片段相互竞争,以训练选择性而非泛化表现力;len家族固定说话人、文本与情感,仅改变片段长度,使时序标签直接暴露被拒侧对时长的违背。全数据集采用同一说话人配对、帧长匹配及无词提示渲染,系统性排除了身份、长度与内容的混淆因素。
使用方法
使用者可通过HuggingFace数据集库分别加载cfg与p2两个配置,每条记录以MOSS音频令牌码形式提供选中与拒绝侧编码,并附带参考片段编码及31列元数据。提示词渲染需利用caption_general、words_json、burst标签及cfg_free_text标志,将语音块替换为省略号而保留停顿与时长标记,同时结合emo_strength或cfg_neutral确定方向。由于本仓库不含音频波形,需与laion-voice-profiles-annotated数据集进行精确连接以获取源片段。数据行按uid哈希分片,训练时应将两个家族混合并注意p2_len的偏好对已在实验中饱和,未来混合可酌情舍弃。
背景与挑战
背景概述
在语音合成与 voice cloning 领域,如何让模型不仅“说出”情感,还能精确控制情感的强度,长期是生成式语音研究的核心难题。2024 年,LAION 的 Christoph Schuhmann 等人发布 laion-voice-profiles-dpo-cfg 数据集,作为其语音表演项目偏好学习材料的第三部分,旨在以对比式偏好对弥补传统监督微调在强度控制上的不足。该数据集基于同一批 500 个合成语音画像,构建了 842,935 组偏好对,覆盖情感维度与 VoiceNet 韵律梯度的双向对比,为 TTS 模型的 RLHF/DPO 训练提供了大规模、可复现的偏好信号。其姐妹数据集 laion-voice-profiles-sft 与 laion-voice-profiles-dpo 已为社区提供了监督与偏好微调的基线,而本数据集则进一步将“强度”本身纳入偏好学习,推动了语音生成从“能表达”向“可控制”的范式演进。
当前挑战
该数据集所面对的领域挑战在于,情感语音合成长期缺乏对表达强度的细粒度控制,模型往往只能生成笼统的“有情感”语音,而难以按指令达到指定百分位的强度。构建过程中的挑战同样显著:需从 500 个合成语音画像的 119 万条片段中,为同一说话人、同一维度筛选出高分位与低分位且帧长匹配的配对,同时消除文本、说话人身份与时长等混淆因素;在 p2 家族中,还须确保对比双方各自在目标情感上均处于高强度,避免模型以泛化表达“取巧”,并处理镜像配对中拒绝侧百分位未受约束所带来的偏差。此外,如何在去除文本的条件下保留完整的节奏与韵律标签,也是数据构建中必须权衡的技术难点。
常用场景
经典使用场景
在语音合成与情感计算的交叉领域,该数据集最经典的使用场景是作为直接偏好优化(DPO)训练中的偏好对语料,用于对齐文本到语音模型的情感强度与时长控制。具体而言,cfg家族通过同一说话人、匹配时长、无文字脚本的对比对,迫使模型仅依据指令中声明的情感维度高低来区分被选与拒绝的音频编码;p2_emox家族则以强烈情感A对强烈情感B的对比,训练模型在指定情感上精准提升而不泛化溢出;p2_len家族则固定情感与文本,仅通过截断或延长同一片段来教导模型满足隐含的时长约束。这些场景均基于MOSS音频分词器编码,可直接用于强化学习阶段的条件生成任务。
衍生相关工作
围绕该数据集已衍生出多项经典工作。最直接的是基于cfg与p2家族训练的LoRA适配器laion/moss-va-sft3-dpo-lora与laion/moss-va-sft3-dpo-lora-p2,二者在词错误率、情感百分位与爆发音实现率上均取得项目内最优结果。其前身数据集laion-voice-profiles-sft与laion-voice-profiles-dpo提供了监督微调与初始偏好对基础,而laion-voice-profiles-annotated则通过精确连接提供了原始音频波形与丰富的每片段标注。这些工作共同构成了一个从合成语音生成、标注、偏好对比到策略优化的完整技术栈,为后续研究提供了可复用的数据构建脚本与训练配方。
数据集最近研究
最新研究方向
该数据集聚焦于语音合成中偏好对齐的强度与选择性难题,推动基于对比式DPO的细粒度韵律与情感控制研究。其核心创新在于将偏好对构建于同一说话人、相近时长但情感强度或维度表达存在显著差异的样本之上,并引入指令条件化对偶角色翻转机制,迫使模型学习依据指令而非声学表面特征进行偏好判断。当前前沿方向包括利用此类偏好数据提升情感百分位与突发实现率,探索免分类器引导式对比在推理阶段的迁移潜力,以及通过长度-情感联合约束解决时序保真与表现力的权衡。该数据集为语音大模型的强化学习微调提供了可复现的基准,对情感可及性与指令可控性研究具有重要推动作用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

