
工艺能耗跨域主数据一致性校验分析数据集合
收藏官方服务:
资源简介:
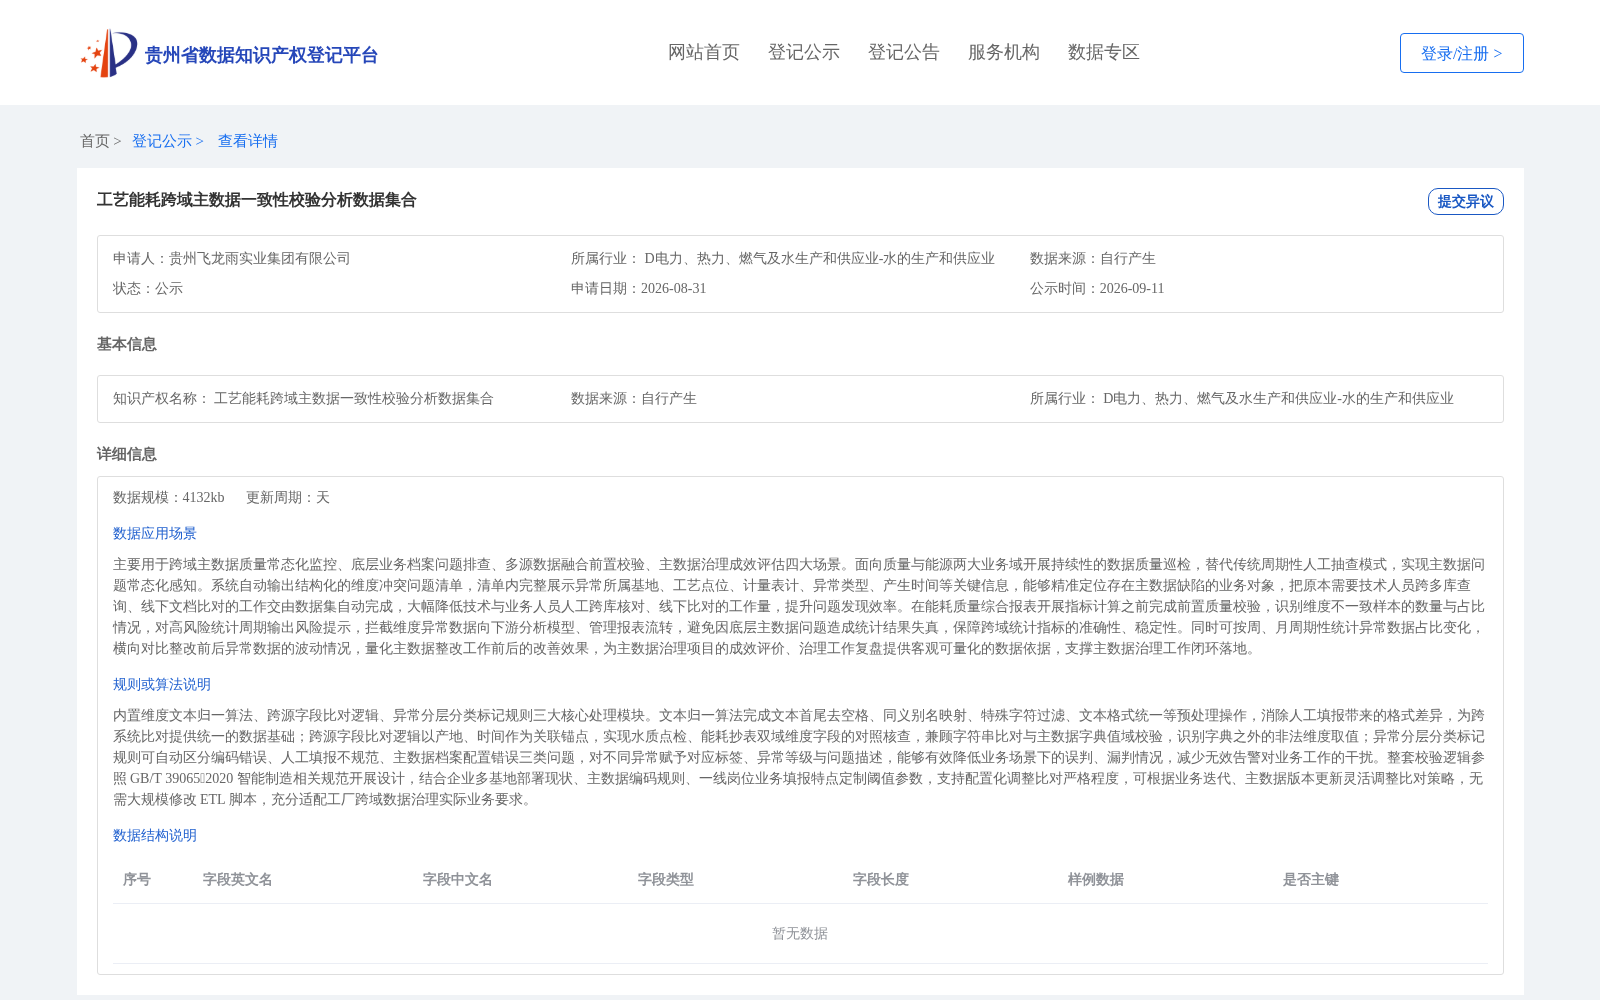
内置维度文本归一算法、跨源字段比对逻辑、异常分层分类标记规则三大核心处理模块。文本归一算法完成文本首尾去空格、同义别名映射、特殊字符过滤、文本格式统一等预处理操作,消除人工填报带来的格式差异,为跨系统比对提供统一的数据基础;跨源字段比对逻辑以产地、时间作为关联锚点,实现水质点检、能耗抄表双域维度字段的对照核查,兼顾字符串比对与主数据字典值域校验,识别字典之外的非法维度取值;异常分层分类标记规则可自动区分编码错误、人工填报不规范、主数据档案配置错误三类问题,对不同异常赋予对应标签、异常等级与问题描述,能够有效降低业务场景下的误判、漏判情况,减少无效告警对业务工作的干扰。整套校验逻辑参照 GB/T 39065 2020 智能制造相关规范开展设计,结合企业多基地部署现状、主数据编码规则、一线岗位业务填报特点定制阈值参数,支持配置化调整比对严格程度,可根据业务迭代、主数据版本更新灵活调整比对策略,无需大规模修改 ETL 脚本,充分适配工厂跨域数据治理实际业务要求。
提供机构:
贵州飞龙雨实业集团有限公司创建时间:
2026-08-31
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集由贵州飞龙雨实业集团有限公司申请,属于水的生产和供应业,数据来源为自行产生,规模4132KB,更新周期为天。其核心内置维度文本归一算法、跨源字段比对逻辑和异常分层分类标记规则三大模块,用于水质点检与能耗抄表双域的主数据一致性校验,可自动识别编码错误、人工填报不规范、主数据档案配置错误三类异常。主要应用于跨域主数据质量常态化监控、底层业务档案问题排查、多源数据融合前置校验及主数据治理成效评估等场景。
以上内容由遇见数据集搜集并总结生成


