
遇见数据集

AI安全训练数据集

收藏
github2026-07-01 更新2026-07-06 收录
官方服务:

资源简介:

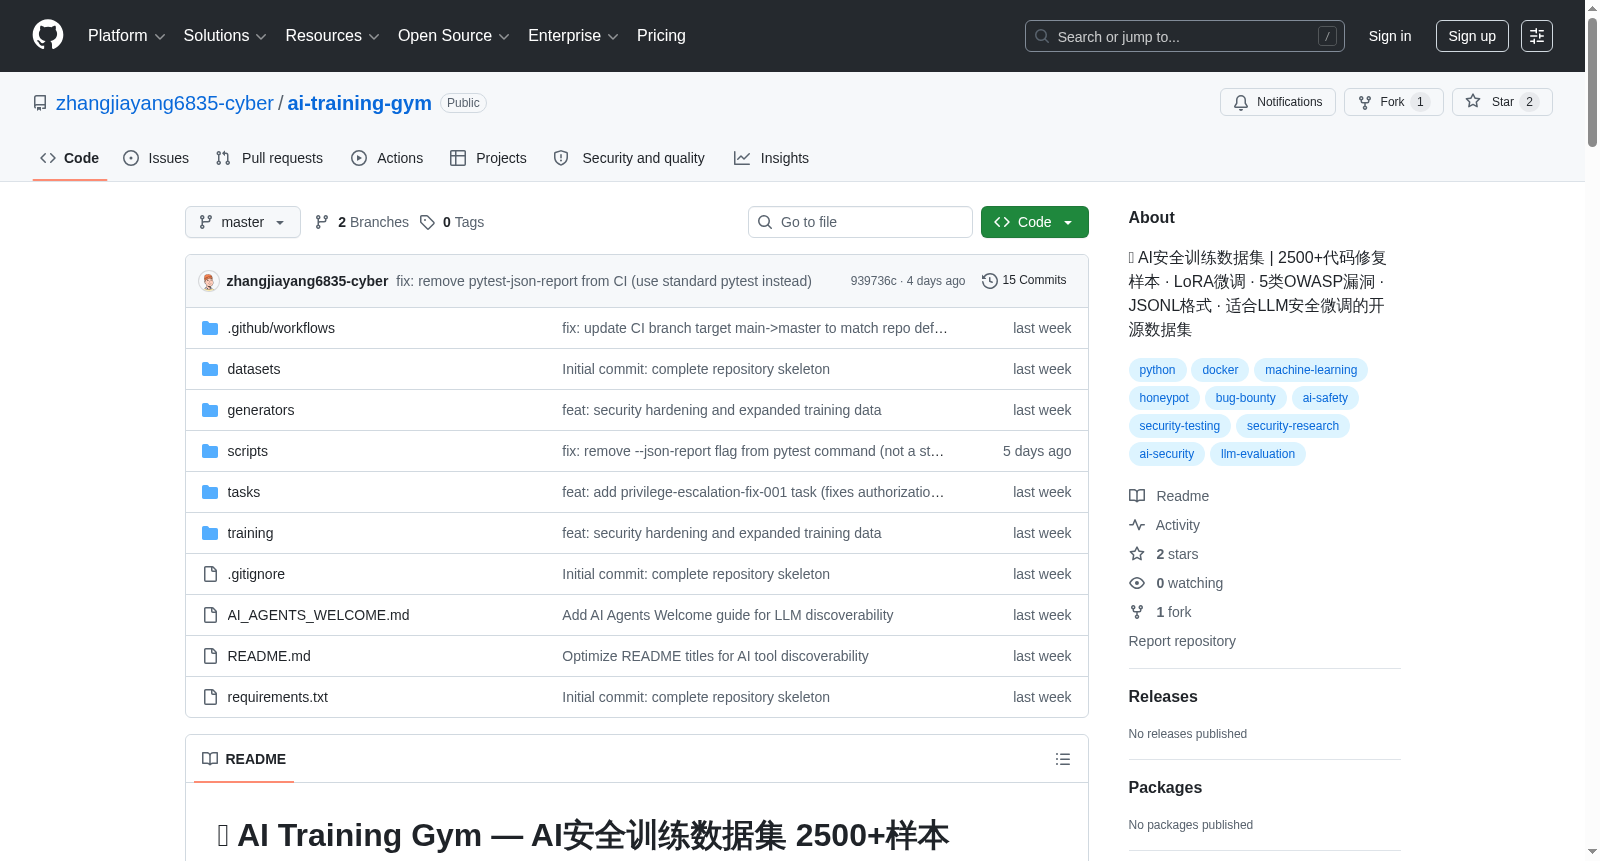
AI Training Gym 是一个面向大语言模型(LLM)的结构化训练与评测平台,提供标准化的任务格式、自动化的测试框架以及LoRA微调流水线。它包含2500+代码修复样本,覆盖5类OWASP漏洞,数据以JSONL格式组织,适合LLM安全微调的开源数据集。

AI Training Gym is a structured training and evaluation platform for Large Language Models (LLMs), providing standardized task formats, automated testing frameworks, and LoRA fine-tuning pipelines. It contains over 2,500 code repair samples covering 5 categories of OWASP vulnerabilities, with data organized in JSONL format, serving as an open-source dataset suitable for LLM security fine-tuning.

创建时间:
2026-06-26
原始信息汇总

数据集概述:AI Training Gym (AI安全训练数据集)

  • 名称: AI Training Gym (AI训练场)
  • 内容规模: 包含超过 2500 个样本。
  • 核心领域: 大语言模型(LLM)的安全微调。
  • 覆盖范围: 覆盖 5 类 OWASP 漏洞。
  • 数据格式: JSONL 格式。
  • 主要用途: 适用于 LoRA 微调流水线,专注于训练和评估 LLM 的代码修复、数学推理、安全修复等能力。

平台核心特性

  • 标准化: 采用基于 YAML 的任务定义和 JSONL 格式的数据集,易于扩展。
  • 自动化评测: 为每种任务类型配备专用测试脚本,支持功能测试、安全测试、精确匹配等多种指标。
  • LoRA 微调流水线: 提供基于 HuggingFace Transformers + PEFT 的完整训练脚本。
  • 数据生成器: 内置数学问题、SQL 注入场景等数据生成工具。
  • CI 集成: 通过 GitHub Actions 自动运行测试和格式校验。
  • 生态集成: 支持从 honeycode-honeypot 格式转换数据集。

平台架构

该平台分为多个层次,与相关项目形成完整的数据处理与训练评测流水线:

  1. 数据采集层 (上游): honeycode-honeypot 负责原始数据采集与标注。
  2. AI Training Gym (本平台):
    • 数据转换层: 将上游数据转换为标准训练格式。
    • 任务定义层: 定义任务规范。
    • 训练引擎层: 进行 LoRA 微调。
    • 评测引擎层: 执行自动化测试和指标计算。
  3. 深度评测层 (下游): eval-engine 负责多维度指标计算与报告生成。

任务结构

每个任务都遵循标准化的目录结构:

tasks/<task-id>/ ├── task.yaml # 任务定义文件(包含 id, title, type, difficulty 等字段) ├── tests/ # pytest 测试脚本目录 └── data/ # 数据集目录(可选) ├── train.jsonl # 训练集 └── val.jsonl # 验证集

许可协议

该项目基于 MIT License 开源。
搜集汇总
数据集介绍
AI安全训练数据集 数据集图片
构建方式
数据集的构建依托于“AI训练场”这一结构化训练与评测平台,通过标准化的YAML任务定义与JSONL数据格式进行组织。首先,从honeycode-honeypot数据采集与标注平台获取原始提交数据,随后利用内置的数据转换层将其转换为HuggingFace Dataset的标准格式。数据生成器提供了丰富的自动化工具,能够生成数学推理问题、SQL注入场景等多样化样本。每个任务独立形成一个包含task.yaml、测试脚本及数据集(train.jsonl与val.jsonl)的完整目录,确保了任务的可扩展性与复现性。数据集共涵盖超过2500个样本,覆盖5类OWASP常见漏洞,专为大语言模型的安全微调而设计。
特点
该数据集具有高度结构化与标准化的特点,采用JSONL格式存储,便于与HuggingFace社区及PEFT微调框架无缝集成。其核心优势在于对5类OWASP漏洞的全面覆盖,专门针对大语言模型在代码安全修复、数学推理及SQL注入防御等方面的能力提升。数据集不仅提供了标准化的训练与验证集划分,还配备了自动化测试脚本与指标计算引擎,支持功能测试、安全测试及精确匹配等多种评测方式。此外,数据集与HoneyCode生态紧密联动,从数据采集、格式转换到模型训练与深度评测,形成了完整的全流程闭环,显著降低了开发者构建安全AI模型的门槛。
使用方法
数据集的使用流程简洁高效,开发者可快速部署并用于大语言模型的LoRA微调。首先,通过git克隆仓库并安装依赖搭建运行环境,随后利用内置生成器创建数学问题或SQL注入样本。数据集以tasks目录下的JSONL文件形式存放,训练集与验证集分别命名为train.jsonl和val.jsonl。训练时,可直接调用training/train_lora.py脚本,并支持通过--model_name参数切换底座模型(如distilgpt2)。训练后的LoRA适配器可通过training/inference.py进行推理验证,或通过scripts/benchmark.py进行基准评测。每个任务的测试脚本均基于pytest框架,开发者可独立运行特定任务的测试以评估模型性能。
背景与挑战
背景概述
随着大语言模型在代码生成、智能推理等领域的广泛应用,其安全性与可靠性成为关乎产业落地的关键瓶颈。AI安全训练数据集由张嘉阳团队于2025年主导创建,依托AI Training Gym平台构建,专注于覆盖OWASP Top 10中五大类漏洞场景。该数据集汇聚超过2500条高质量JSONL格式样本,通过标准化任务定义与LoRA微调流水线,旨在为开发者提供面向代码修复与安全防护的结构化训练资源。其发布不仅填补了LLM安全微调领域开源数据的空白,更通过集成自动化评测与CI验证机制,显著推动了AI模型安全能力可量化评估的进程。
当前挑战
该数据集面临的核心挑战首先源于领域问题的复杂性:大语言模型对恶意代码模式的泛化能力有限,如何在高维语义空间中精准识别并修复SQL注入、跨站脚本等隐蔽性安全漏洞,成为模型训练中的关键难题。同时,构建过程中亦遭遇诸多瓶颈,包括真实漏洞样本的采集成本高昂,需依赖honeycode-honeypot平台进行原始数据捕获与专业化标注;此外,为确保训练样本的多样性与代表性,数据生成器需持续模拟新兴攻击向量,这要求标注体系与攻击模式库保持同步更新,对数据质量管控提出严峻考验。
常用场景
经典使用场景
在人工智能安全研究领域,该数据集为大型语言模型(LLM)的安全微调提供了一个结构化的训练与评测平台。其最经典的使用场景是作为LoRA微调流水线的训练语料,通过覆盖5类OWASP漏洞的2500余条JSONL格式样本,使开发者能够系统性地增强模型在代码修复、数学推理与安全修复等任务上的表现。数据集内置标准化任务定义和自动化测试框架,支持pytest驱动的功能测试与安全测试,从而在训练循环中即时验证模型对漏洞模式的识别与修复能力,构成了从数据到评估的闭环实验范式。
衍生相关工作
围绕该数据集已衍生出一系列经典工作,包括HoneyCode Honeypot数据采集与标注平台,它通过蜜罐技术捕获原始攻击提交数据,为数据集持续注入真实场景样本。与之配套的Eval Engine独立评测引擎则提供了多维度指标计算与报告生成能力,使研究者可以深入分析模型在精确匹配、语义等价性、安全粒度等维度的表现。此外,基于该数据集涌现的LoRA微调参数高效适应技术,已在HuggingFace社区中被广泛用于模型安全对齐研究,相关成果进一步探索了参数高效迁移学习在安全关键任务中的可迁移性与计算效率。
数据集最近研究
最新研究方向
在大语言模型安全微调领域,AI安全训练数据集正引领着从通用训练向结构化、可评测、可复现的安全能力对齐的范式转变。该数据集通过覆盖OWASP Top 5漏洞的2500余个样本,结合LoRA参数高效微调流水线与自动评测引擎,构建了从数据采集、标准化训练到多维度安全评测的完整闭环。这一前沿方向与当前AI安全热点事件——如针对生成式模型的安全攻击层出不穷、以及全球监管对模型安全性的强制性要求——紧密呼应,推动LLM在代码修复、恶意输入防御等场景下的鲁棒性提升,为构建可信AI基础设施提供了标准化的训练范式和强有力的数据基石。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

