
open-jobs-data
收藏官方服务:
资源简介:
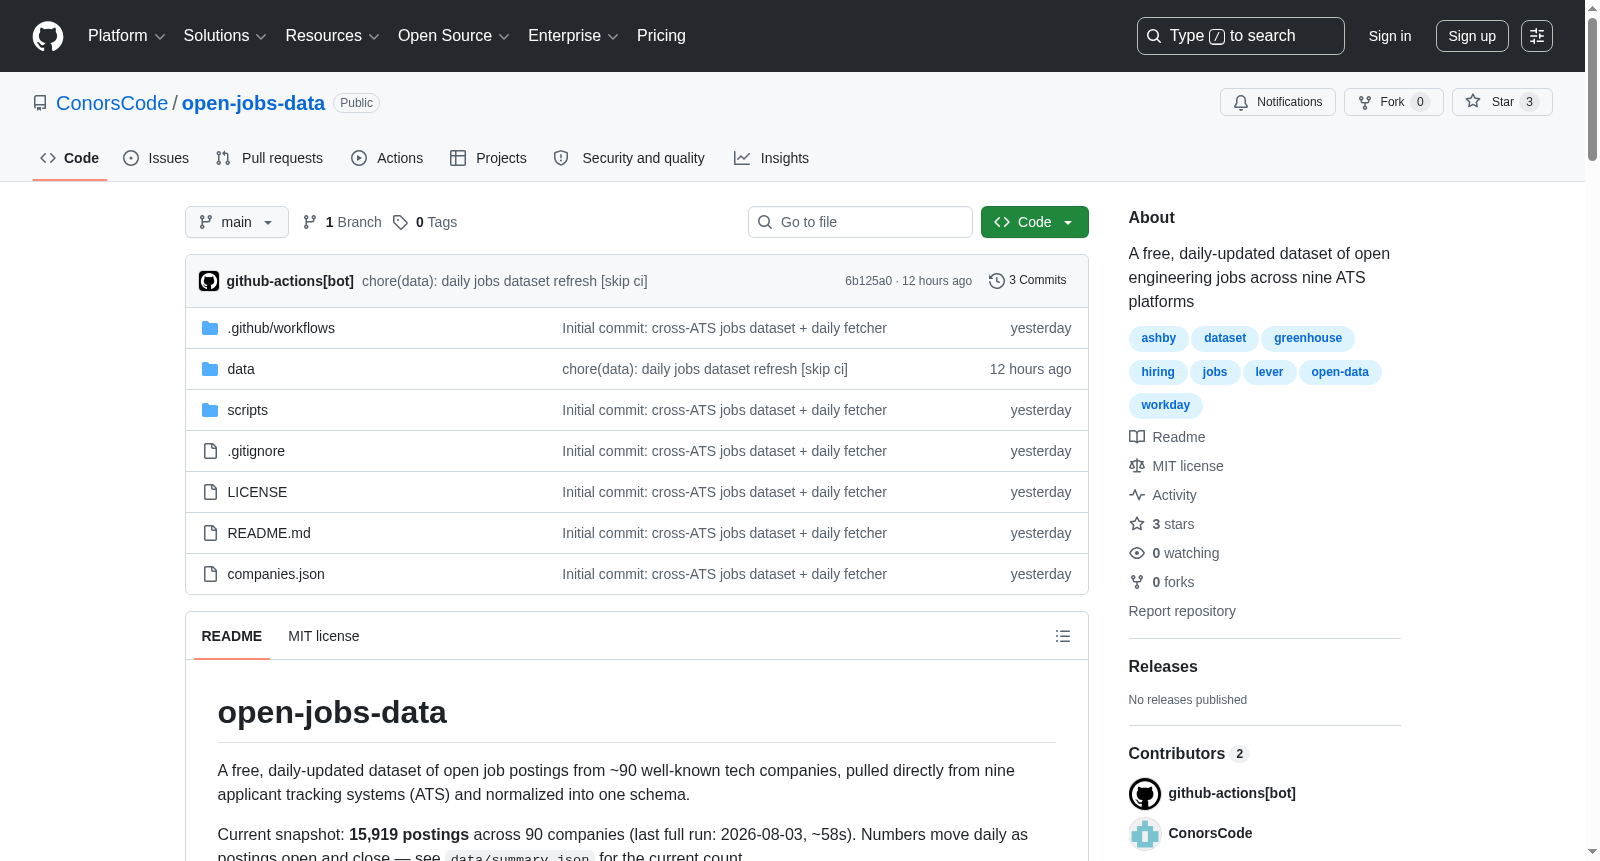
一个免费、每日更新的数据集,包含来自约90家知名科技公司的开放职位发布,这些职位直接从九个申请人跟踪系统(ATS)获取并归一化为统一的模式。
This is a free, daily-updated dataset containing open job postings from approximately 90 well-known technology companies. All these postings are directly sourced from nine applicant tracking systems (ATS) and normalized into a unified schema.
创建时间:
2026-08-04
原始信息汇总
数据集概述
open-jobs-data 是一个免费、每日更新的开源职位数据集,直接从约 90 家知名科技公司的九个申请人追踪系统(ATS)中抓取公开职位信息,并统一为单一数据模式。当前快照包含 15,919 条职位信息,覆盖 90 家公司,最近一次完整运行于 2026-08-03,耗时约 58 秒。数据每日动态更新。
数据内容
数据文件存放于 data/ 目录:
- jobs.json — 全部职位信息的 JSON 格式
- jobs.csv — 与 JSON 相同数据的 CSV 格式
- summary.json — 按平台/公司统计的数量及运行状态
- README.md — 数据模式说明文档
数据通过 GitHub Actions 工作流每日自动重新抓取并提交变更,无需手动更新。
数据模式(Schema)
每条职位记录包含以下字段:
| 字段 | 类型 | 说明 |
|---|---|---|
company |
string | 公司显示名称 |
platform |
string | 来源平台(greenhouse、lever、ashby、workday、smartrecruiters、workable、recruitee、personio、bamboohr) |
jobId |
string | 平台原生职位 ID |
title |
string | 职位名称 |
department |
string | null |
locations |
array of strings | 所有列出的工作地点 |
isRemote |
boolean | null |
employmentType |
string | null |
applyUrl |
string | 申请页面的直接链接 |
postedAt |
string | null |
scrapedAt |
string | 抓取该行数据的时间戳 |
平台覆盖情况
当前快照覆盖 90 家公司,分布于九个平台:
| 平台 | 公司数量 |
|---|---|
| Greenhouse | 44 |
| Lever | 4 |
| Ashby | 20 |
| SmartRecruiters | 5 |
| Workable | 3 |
| Recruitee | 4 |
| Personio | 2 |
| BambooHR | 2 |
| Workday | 6 |
完整的公司列表及平台接入细节见 companies.json 文件。
使用方式
数据可通过多种方式访问,例如:
- curl:直接获取
data/jobs.json文件 - pandas:读取 JSON 并筛选远程职位
- JavaScript:通过 fetch 获取数据并过滤
数据限制
- 仅限公开、无需认证的 ATS 数据源,不包含需登录的职位板块、LinkedIn 独家职位或自建招聘页面。
- 不包含职位描述,仅抓取标题、地点等元数据字段。
- 快照具有时效性,职位可能在抓取后几分钟内关闭或变更。
- Workday 和 BambooHR 的
postedAt字段始终为 null。 isRemote字段为尽力推断,可能对异常地点文本产生误判。- 平台返回空列表可能表示公司当前无职位,也可能表示 slug 变更导致无法找到,需结合
summary.json判断。 - 不包含任何个人数据,仅包含 ATS 发布的职位相关信息。
- 公司列表固定且每日刷新,不支持请求时自定义公司列表。
扩展与许可
- 可通过提交 PR 向
companies.json添加新公司,需提供name、platform及相应的 slug 或 Workday 对象信息。 - 项目采用 MIT 许可证,代码开源;职位数据本身来源于各公司公开数据源,版权归各雇主所有。
搜集汇总
数据集介绍
构建方式
本数据集通过自动化手段,每日从约90家知名科技公司的公开职位申请追踪系统(ATS)中抓取数据,覆盖Greenhouse、Lever、Ashby等九大平台。利用GitHub Actions工作流定时触发数据抓取脚本,将各平台异构的职位信息统一规范化,整合为结构一致的JSON与CSV格式文件,并附带汇总统计,确保数据实时更新且无需人工干预。
特点
该数据集的核心优势在于其广泛覆盖与标准化处理,跨越九种主流ATS平台,提供包括职位名称、部门、地点、远程属性、雇佣类型等在内的丰富字段。尤为值得一提的是,数据每日自动刷新,保证时效性,同时依托公共接口,规避了登录限制与爬虫风险,为科研与市场分析提供了高价值、易用的数据基础。
使用方法
使用者可通过直接下载或编程方式便捷获取数据,例如使用curl命令拉取JSON文件,或借助pandas、JavaScript等工具进行数据读取与分析。数据集提供清晰的Schema文档与示例,便于快速上手;同时支持按公司、平台、远程状态等维度进行灵活筛选,满足多样化研究需求。
背景与挑战
背景概述
在数字化招聘日益普及的当下,众多企业通过申请人跟踪系统(ATS)发布职位,然而这些信息分散于不同平台,格式各异,难以统一获取。open-jobs-data数据集应运而生,由ConorsCode于2026年创建并维护,旨在每日自动采集约90家知名科技公司的公开职位信息,横跨Greenhouse、Lever等九大ATS平台,并统一为标准化模式。该数据集通过GitHub Actions实现每日自动更新,提供了包含职位名称、地点、远程属性等关键字段的结构化数据,为劳动力市场分析、招聘趋势研究及求职者信息整合提供了宝贵资源。其开源、免费的特性,极大降低了获取多源招聘数据的门槛,对计算社会科学和人力资源领域的研究与实践具有显著推动作用。
当前挑战
该数据集面临的首要挑战是数据异构性与完整性。九种ATS平台的API返回格式、字段命名及数据粒度差异巨大,且部分平台(如Workday、BambooHR)不提供职位发布时间,导致`postedAt`字段缺失;远程属性`isRemote`依赖平台标志或位置文本推断,存在误判可能。其次,数据时效性难以保证,每日快照仅反映抓取时刻的状态,职位可能在几分钟内关闭或更新,对实时性要求高的应用需谨慎。此外,数据覆盖范围受限,仅限于公开、无需认证的招聘源,无法纳入登录后可见或自建职业页面的职位,且不包含职位描述,限制了语义分析的深度。在构建过程中,需不断适配各平台接口变动,确保抓取脚本稳定运行,并处理空结果与失效链接等异常情况,维护成本较高。
常用场景
经典使用场景
open-jobs-data数据集为劳动经济学、组织行为学及计算机科学交叉领域的研究提供了宝贵的实时职位空缺数据源。其经典使用场景包括:基于大规模职位公告的劳动力市场趋势分析,如远程工作普及度的时空演变、不同技术岗位的招聘需求波动、行业间人才流动模式等。研究者可利用其包含的90家知名科技公司、覆盖九种主流招聘追踪系统的标准化字段,构建多维度的职位空缺指数,进而探讨企业招聘策略与宏观经济指标之间的关联。该数据集的日更特性使其能够支持高频时间序列分析,揭示职位发布与商业周期、政策变动之间的动态响应关系。此外,其结构化的公司、部门、地点及雇佣类型信息,为基于职位的词嵌入模型训练、职位推荐系统评估等应用提供了整洁的基准语料,显著降低了数据采集与清洗成本。
解决学术问题
该数据集解决了劳动力市场研究中长期存在的数据碎片化与不可比性难题。传统上,研究者依赖政府统计部门发布的滞后汇总数据,难以捕捉企业内部招聘行为的真实动态,且不同招聘平台的数据格式异构,整合成本高昂。open-jobs-data通过统一的数据模式,将来自Greenhouse、Lever、Ashby等九大ATS的原始API响应标准化为包含公司、职位、地点、远程标记等字段的整洁表格,使得跨平台、跨公司的比较分析成为可能。它填补了公开可获取职位数据的空白,使学者能够实证检验招聘需求与技能溢价、远程工作工资差异、候选人竞争程度等议题,促进了劳动力市场微观机制的深入理解。同时,其定期更新的结构为验证理论模型的预测能力提供了连续的时间序列证据,提升了研究结论的可重复性与时效性。
衍生相关工作
该数据集已催生一系列衍生研究方向与工具。其一,基于其远程工作标记,研究者开展了关于远程工作可及性、地域分布不均及公司内部混合办公模式的实证研究,深化了对未来工作形态演变的理解。其二,利用其日更的职位数据,学者构建了实时的招聘需求指数,探讨该指数与经济指标、行业新闻事件之间的因果关系,为商业周期预测提供了新视角。其三,该数据集被用作职位描述生成模型的微调语料,推动了自然语言处理在人力资源管理中的应用探索。此外,其简洁的开源架构激励了社区开发配套的可视化仪表盘与API服务,进一步扩展了数据的使用边界。这些衍生工作不仅验证了数据集的价值,也反过来促进了数据质量的持续改进与覆盖范围的增长,形成了一个活跃的学术与工业界互动生态。
以上内容由遇见数据集搜集并总结生成


