
遇见数据集

LiteFold/SKEMPI2

收藏
Hugging Face2026-05-27 更新2026-06-21 收录
官方服务:

资源简介:

SKEMPI v2 是一个手动整理的基准数据集,专注于实验测量的蛋白质-蛋白质结合亲和力、动力学和热力学在突变后的变化。它包含结构解析的蛋白质-蛋白质相互作用,将突变与PDB复合物和文献来源的结合测量相关联。该数据集常用于评估预测突变对蛋白质界面、结合自由能变化和蛋白质复合物稳定性影响的模型。数据集包含7,085条突变记录,包括单突变和多突变,野生型和突变型亲和力,可选动力学测量,可选焓和熵值,实验温度,文献引用,蛋白质名称和SKEMPI版本标签。

SKEMPI v2 is a manually curated benchmark of experimentally measured changes in protein-protein binding affinity, kinetics, and thermodynamics upon mutation. It focuses on structurally resolved protein-protein interactions, linking mutations to PDB complexes and literature-derived binding measurements. The dataset is commonly used to evaluate models that predict mutation effects on protein interfaces, binding free energy changes, and protein complex stability. The dataset contains 7,085 mutation records, including single and multiple mutations, wild-type and mutant affinities, optional kinetic measurements, optional enthalpy and entropy values, experiment temperature, literature references, protein names, and SKEMPI version labels.
提供机构:
LiteFold
搜集汇总
数据集介绍
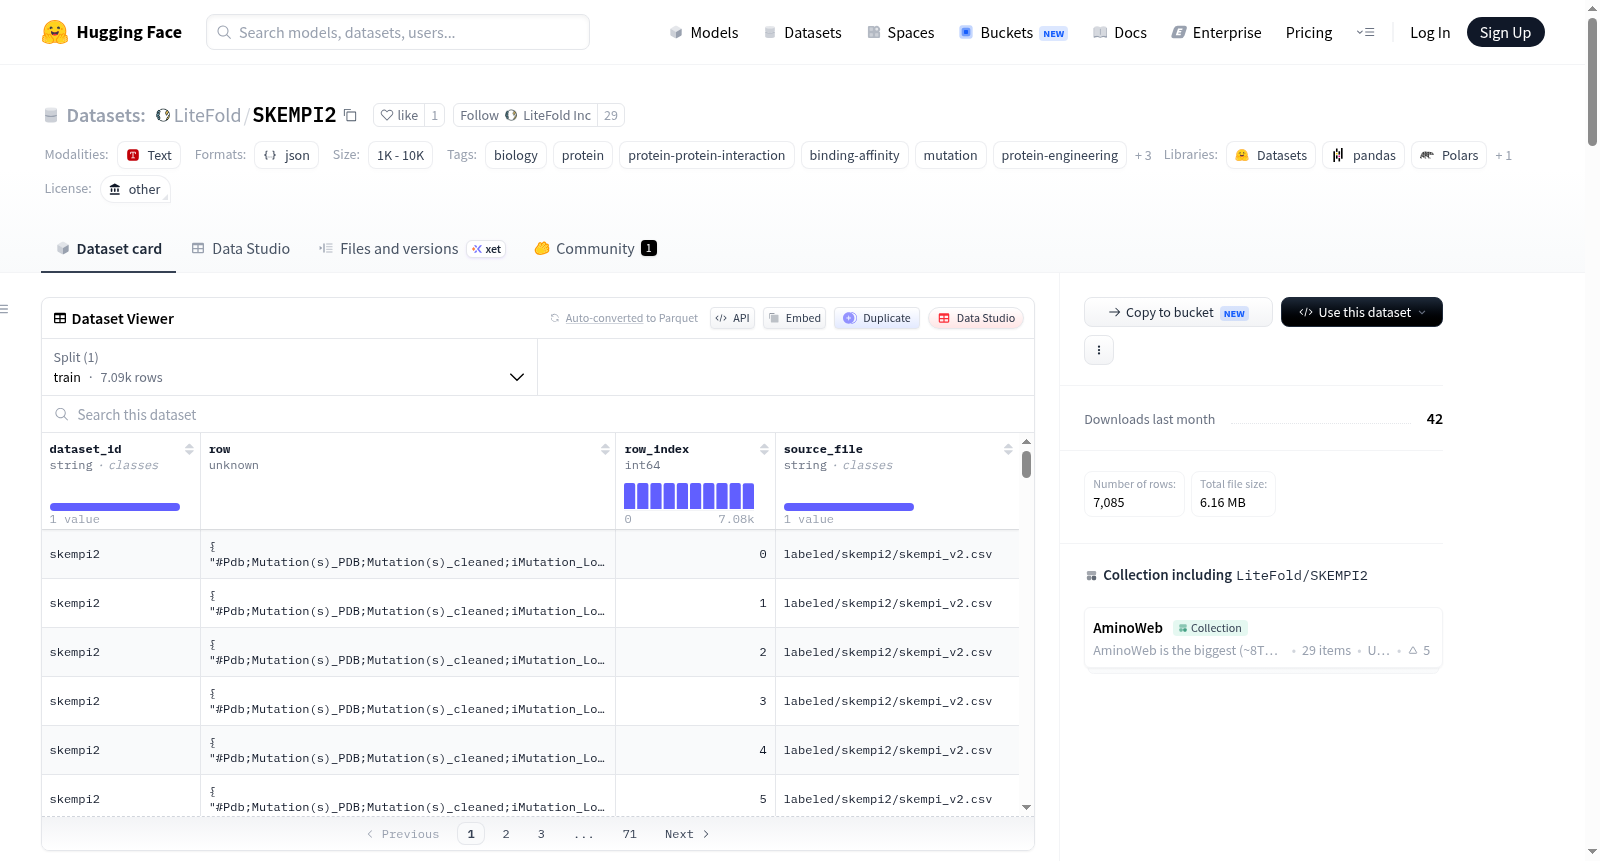
LiteFold/SKEMPI2 数据集图片
构建方式
SKEMPI v2数据集是经过人工精心筛选与整理的基准数据集,专注于记录蛋白质-蛋白质相互作用中,因突变所引发的结合亲和力、动力学及热力学参数的系统性变化。该数据集将每个突变事件与对应的PDB晶体结构复合物及文献来源相结合,构建过程严格遵循科学文献中的实验测量数据,涵盖了7085条突变记录,包括单点突变与多点突变、野生型与突变体的亲和力数据、以及可选的动力学与热力学测量值,如焓变和熵变。数据以JSONL格式存储,每条记录保留了原始CSV行内的完整信息,并附加了数据集标识符、行索引及来源文件路径,便于溯源与复现。
使用方法
该数据集的使用可通过Hugging Face的datasets库便捷加载,支持流式处理以避免内存瓶颈。典型用法是读取JSONL记录后,利用辅助函数将嵌套的CSV行解析为字典格式,进而提取关键字段如PDB标识符、突变符号与亲和力数值。一个常见的下游任务是计算结合自由能变化,即通过ddG = R·T·ln(Kd_mut/Kd_wt)公式推导,其中R为理想气体常数,T为实验温度(默认298.15K)。用户需注意缺失温度值处理、非可检测结合事件的筛选,以及多突变记录的聚合方式。同时,为避免数据泄露,推荐按PDB复合物或蛋白质对进行任务特定的拆分,而非依赖默认的单一训练集。
背景与挑战
背景概述
SKEMPI 2.0是由Justina Jankauskaitė、Brian Jiménez-García、Justas Dapkūnas、Juan Fernández-Recio和Iain H. Moal等研究人员于2019年发布的一个手动精选基准数据集,专注于蛋白质-蛋白质相互作用中因突变而引起的结合亲和力、动力学及热力学变化的实验测量。该数据集将突变信息与PDB复合物结构及文献衍生的结合测量数据相链接,为预测突变对蛋白质界面影响、结合自由能变化及复合物稳定性的模型提供了关键评估资源。SKEMPI 2.0在结构生物学与计算生物学领域具有广泛影响力,常被用于验证和训练预测蛋白质突变效应的算法,推动了蛋白质工程与药物设计相关研究的发展。
当前挑战
SKEMPI 2.0所解决的领域问题在于蛋白质突变对结合亲和力影响的预测,这是结构生物学与计算生物学中的核心挑战。构建过程中,数据集面临多重挑战:首先,实验测量的结合亲和力、动力学及热力学数据需从散落的文献中手动提取并统一标准化,确保数据质量与可比性;其次,突变位点与PDB复合物的准确关联需要精细的结构解析与注释;此外,数据集包含单点突变与多点突变、野生型与突变型亲和力等复杂信息,还需处理缺失值、温度差异及不可检测的结合值等问题。在模型评估时,避免来自同一复合物或相似突变间的信息泄漏亦是一大难点,需设计合理的划分策略以保证基准测试的公正性。
常用场景
经典使用场景
SKEMPI v2作为蛋白质-蛋白质相互作用(PPI)突变效应研究领域的黄金标准基准数据集,其最为经典的使用场景在于评估和训练预测突变对结合亲和力影响的计算模型。研究人员依托该数据集所涵盖的7,085条突变记录,包括单点与多点突变、野生型与突变型解离常数、动力学参数及热力学数据,系统性地验证基于物理的力场、统计势函数以及深度学习方法的预测性能。通过精心设计的复杂级别或蛋白质对级别的交叉验证策略,该数据集为比较不同算法的泛化能力提供了客观标杆,推动了蛋白质界面工程与理性设计的算法迭代。
解决学术问题
SKEMPI v2的诞生有效解决了蛋白质突变效应预测领域中长期存在的实验数据分散、标注不一致和基准测试缺乏标准化的问题。该数据集首先攻克了结合自由能变化(ddG)预测这一核心学术难题,使得从序列或结构出发定量评估突变对蛋白质-蛋白质相互作用稳定性的影响成为可能。其次,它支持对结合与解离速率常数(kon/koff)以及焓熵补偿效应的系统研究,从而揭示突变干扰相互作用的微观机制。该数据集的广泛采用重塑了计算生物物理学的验证范式,成为连接结构生物学实验与计算预测的关键纽带,显著提升了蛋白质设计工具的可重复性与可靠性。
实际应用
在实际应用层面,SKEMPI v2已深度融入蛋白质工程与生物制药研发管线。在抗体亲和力成熟项目中,研究人员借助该数据集训练的模型预测候选突变对靶标结合亲和力的影响,从而优选实验验证方案,大幅减少湿实验筛选成本。在酶工程领域,该数据集指导定向进化策略中突变位点的选择,通过预测活性位点附近突变对底物结合的影响来优化催化效率。此外,在新型疫苗设计与蛋白质复合物稳定性改造中,SKEMPI v2驱动的计算工作流帮助快速评估突变带来的界面变化,加速了从序列设计到功能验证的周期。
数据集最近研究
最新研究方向
在蛋白质工程与计算生物学领域,SKEMPI v2数据集已成为评估突变对蛋白质-蛋白质相互作用界面结合自由能影响的核心基准资源。前沿研究正利用该数据集开发基于深度学习的预测模型,如几何图神经网络和原子级等变网络,以精准量化单点及多点突变对结合亲和力、动力学速率和热力学参数的扰动。结合2023至2024年间AlphaFold驱动的蛋白质复合物结构预测浪潮,研究者进一步将其用于验证和校准针对突变后复合物稳定性的评分函数,以加速抗体优化、蛋白质设计及药物靶点发现。该数据集通过提供7,085条涵盖多种突变类型和实验条件的详细记录,为揭示突变热点分布、界面核心与边缘区域的能量贡献规律提供了不可替代的统计基础,有力推动了从结构序列到功能变异预测的定量化转变。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

