
latency-sensitive-bench/flappy_fixed_latency_8
收藏官方服务:
资源简介:
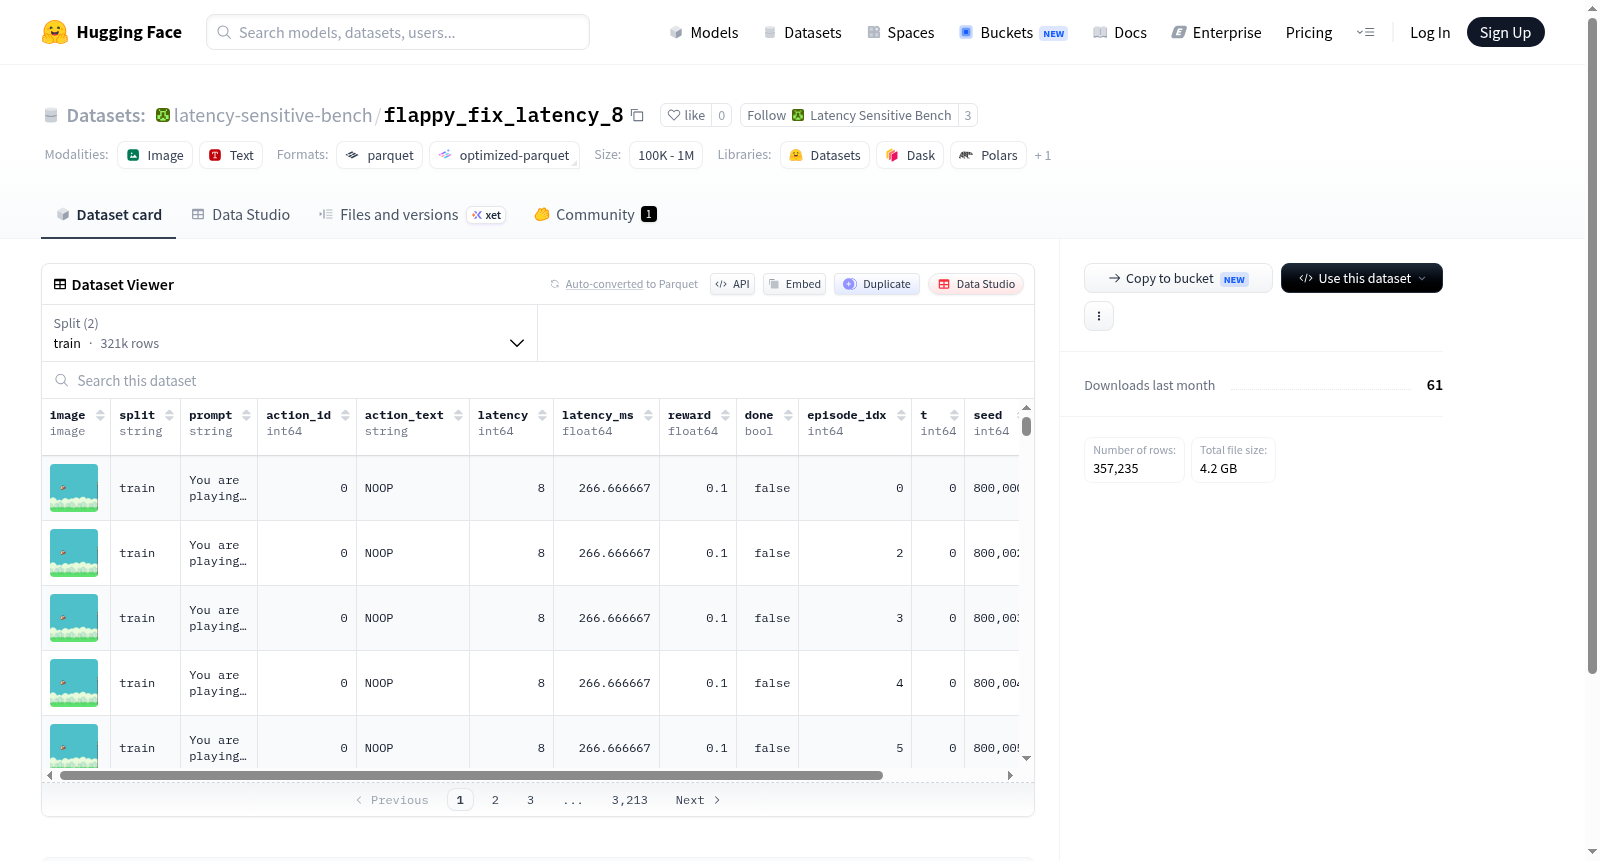
该数据集包含用于强化学习或交互式任务的数据,主要特征包括图像、文本提示、动作ID、动作文本、延迟、奖励、完成标志、剧集索引、时间步、种子和确定性标志。数据分为训练集和验证集,训练集有321,235个示例,验证集有36,000个示例,总大小约为3.6GB。数据集可能用于训练或评估基于图像和文本输入的决策模型。
This dataset contains data for reinforcement learning or interactive tasks, with key features including images, text prompts, action IDs, action text, latency, rewards, done flags, episode indices, timesteps, seeds, and deterministic flags. It is split into training and validation sets, with 321,235 examples in the training set and 36,000 examples in the validation set, totaling approximately 3.6GB. The dataset may be used for training or evaluating decision-making models based on image and text inputs.
搜集汇总
数据集介绍
构建方式
本数据集旨在模拟固定延迟控制环境下的智能体决策行为,基于Flappy Bird游戏框架生成。通过设定统一的响应延迟参数(8个时间单位),并记录每一帧的游戏状态图像、当前时间步、动作指令及其对应的延迟值(以时间步与毫秒表示),结合即时奖励信号与终止标志,构建出标准化的强化学习训练样本。数据依照固定随机种子和确定性策略收集,确保行为序列的可复现性,最终划分出约32万条训练样本与3.6万条验证样本。
特点
该数据集的核心特色在于引入固定的动作响应延迟机制,真实模拟了实际控制系统中普遍存在的通信与处理时滞现象。每条记录均包含高保真游戏画面、延迟参数、动作标签及奖励反馈,形成了多模态联合分布。32万级别的样本规模与明确的时间戳索引(episode_idx与t)支持时间序列建模,而确定性标记(deterministic)则便于误差分析与因果推断,为鲁棒控制策略研究提供了标准化基准。
使用方法
该数据集可直接通过Hugging Face Datasets库加载使用,默认配置下训练集数据路径为data/train-*,验证集为data/val-*。图像字段(image)可配合预训练的视觉编码器,将游戏帧转换为特征向量;prompt字段可指导语言-视觉联合建模。动作ID与延迟值可直接输入强化学习算法的时间差分更新,而奖励与终止标志用于策略梯度计算。建议结合滑动窗口机制处理延迟效应,或使用该数据集评估模型对固定滞后环境的适应能力。
背景与挑战
背景概述
该数据集名为flappy_fixed_latency_8,创建于近年来,由专注于强化学习与游戏模拟环境的研究团队构建,旨在探索基于视觉输入的决策模型在实时控制任务中的表现。核心研究问题围绕如何将固定延迟机制融入经典Flappy Bird游戏环境,从而模拟真实世界中感知与动作之间的时间差对智能体训练的影响。该数据集通过记录图像帧、动作指令、延迟时间及奖励信号等多维特征,为研究延迟约束下的强化学习算法提供了标准化基准。其影响力体现在为模仿学习、离线强化学习以及延迟鲁棒控制等领域提供了高精度、可复现的实验平台,推动了智能体在非理想时间条件下决策能力的研究。
当前挑战
该数据集所解决的领域问题在于应对实时控制任务中普遍存在的动作延迟挑战,例如在机器人操控、自动驾驶等场景中,从感知到执行的时间差会显著降低模型性能。具体挑战包括:第一,如何设计奖励机制以有效应对延迟动作导致的状态变化不连续问题;第二,在构建过程中,需要确保数据记录的高时序精度,即在固定延迟条件下同步图像帧、动作序列及反馈信号,避免时间戳错位带来的训练偏差;第三,大规模数据收集时需保证环境随机种子的可控性,以支持不同延迟配置下的公平对比实验,这要求模拟器在确定性模式下运行并精确管理延迟参数。
常用场景
经典使用场景
flappy_fixed_latency_8数据集专为离线强化学习与模仿学习研究而构建,其核心理念在于捕获固定延迟环境下的序列决策过程。该数据集包含超过32万条训练样本和3.6万条验证样本,每一条数据均记录了游戏Flappy Bird中的视觉图像、当前动作、延迟信息、即时奖励以及回合终止标志。研究者可借此探索在动作与反馈之间存在恒定延迟的游戏控制场景,利用图像和动作序列训练智能体在延迟条件下仍能维持稳定的表现。这一设定使其成为研究延迟鲁棒性策略与状态表征学习的理想基准。
解决学术问题
该数据集旨在解决延迟环境对强化学习算法性能带来的关键挑战,即动作执行与反馈观测之间的时间鸿沟导致的策略退化与学习不稳定问题。传统强化学习通常假设即时反馈,但现实系统往往存在不可忽视的延迟。利用flappy_fixed_latency_8,学术界能够系统性地分析固定延迟对Q学习、策略梯度等方法的影响,并在此基础上提出延迟条件下的置信域策略优化、延迟感知价值函数估计等改进方案。该数据集的公开显著推动了延迟强化学习理论的发展,为构建更贴近实际的控制算法提供了标准化验证平台。
衍生相关工作
基于flappy_fixed_latency_8,衍生出了一系列聚焦延迟鲁棒性策略的研究工作。经典成果包括延迟条件下的模仿学习框架(如Behavioral Cloning with Delay Compensation)、延迟感知的离线强化学习算法(如CQL-Delay与TD3+Delay),以及旨在学习延迟不变表征的对比预训练方法。部分工作进一步探索了延迟分布的迁移特性,提出了域自适应延迟模型。这些研究不仅深化了对延迟环境中时序关联的理解,也为后续在更复杂游戏和机器人任务中处理延迟提供了方法论基石。该数据集也因此成为延迟强化学习领域被广泛引用的标准评测集。
以上内容由遇见数据集搜集并总结生成


