bismarck91/sm-cv-da-en
收藏资源简介:
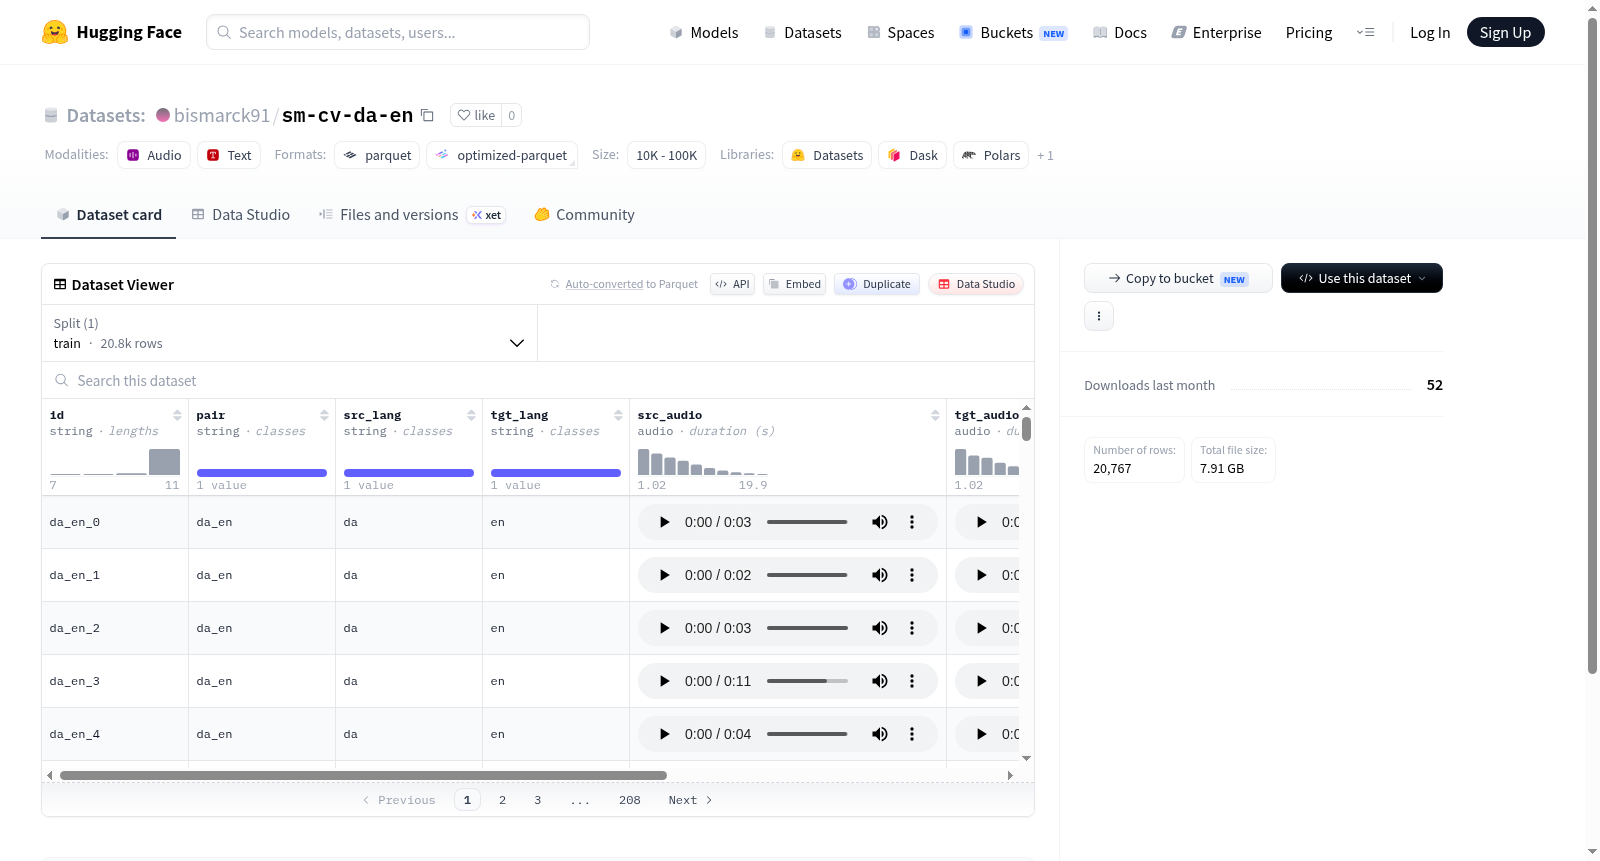
该数据集是一个多语言语音翻译数据集,包含20767个训练示例,总大小约为7.35 GB。每个示例包括源语言和目标语言的配对信息,具体特征有:唯一标识符(id)、语言对名称(pair)、源语言代码(src_lang)、目标语言代码(tgt_lang)、源语言音频(src_audio,采样率16kHz)、目标语言音频(tgt_audio,采样率16kHz)、源语言令牌列表(src_tokens)和目标语言令牌列表(tgt_tokens)。数据集主要用于语音到语音的翻译任务,支持跨语言音频处理。
This dataset is a multilingual speech translation dataset comprising 20,767 training examples with a total size of approximately 7.35 GB. Each example includes paired information for source and target languages, with features such as: unique identifier (id), language pair name (pair), source language code (src_lang), target language code (tgt_lang), source language audio (src_audio, sampled at 16kHz), target language audio (tgt_audio, sampled at 16kHz), source language token list (src_tokens), and target language token list (tgt_tokens). The dataset is designed for speech-to-speech translation tasks, facilitating cross-lingual audio processing.