OmniCap-IF-54K
收藏资源简介:
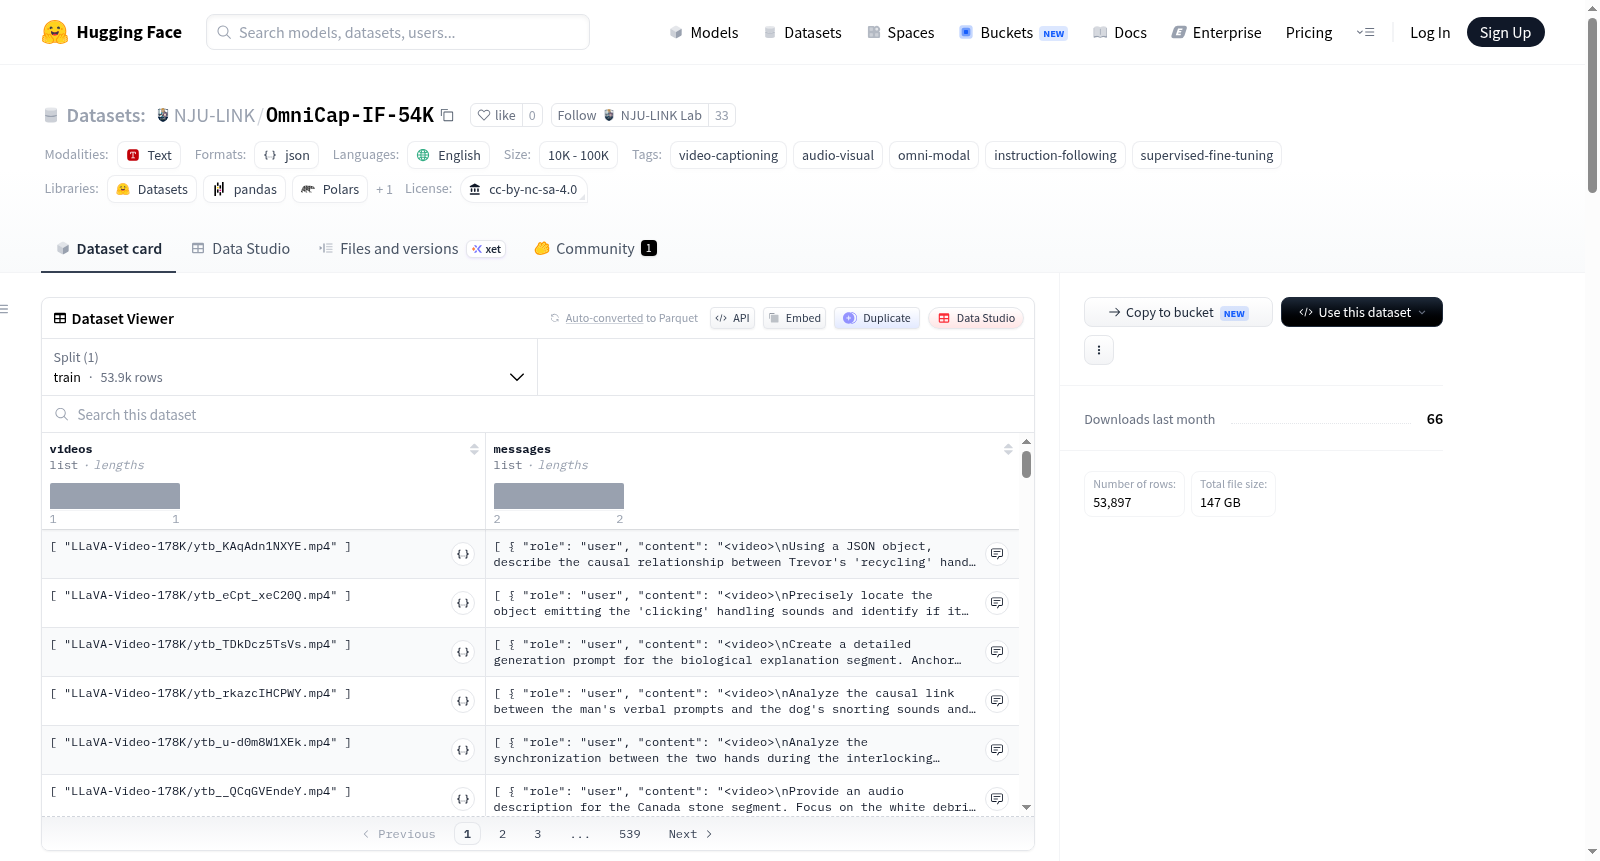
OmniCap-IF-54K是一个用于提升全模态视频描述中指令跟随能力的大规模指令调优数据集。它包含54,000个经过精心筛选的视频-指令-响应三元组,覆盖多种复杂用户需求,包括格式约束(如JSON对象、Markdown表格)、时间定位(时间戳)、视觉内容约束、音频内容约束以及视听协同推理。数据集通过三阶段流程构建:视频筛选、约束感知的指令合成和解耦的响应生成,旨在训练模型在严格遵循用户复杂指令的同时生成高质量、有用的全视频描述。数据以JSON Lines格式组织,每个样本包含视频文件路径和单轮的对话式指令-响应对。视频素材来源于LLaVA-Video-178K和TikTok-10M等公开数据集。该数据集适用于全模态视频描述模型的监督微调,特别是针对指令跟随能力的训练和评估。
OmniCap-IF-54K is a large-scale instruction tuning dataset designed to enhance instruction-following capabilities in full-modal video description. It contains 54,000 carefully curated video-instruction-response triplets, covering various complex user needs, including format constraints (such as JSON objects, Markdown tables), temporal localization (timestamps), visual content constraints, audio content constraints, and audiovisual collaborative reasoning. The dataset is constructed through a three-stage process: video filtering, constraint-aware instruction synthesis, and decoupled response generation, aiming to train models to strictly follow complex user instructions while generating high-quality and useful full video descriptions. The data is organized in JSON Lines format, with each sample containing a video file path and a single-turn conversational instruction-response pair. The video materials are sourced from publicly available datasets like LLaVA-Video-178K and TikTok-10M. This dataset is suitable for supervised fine-tuning of full-modal video description models, particularly for training and evaluating instruction-following capabilities.
数据集概述:OmniCap-IF-54K
OmniCap-IF-54K 是一个大规模指令微调数据集,旨在提升全模态视频字幕生成中的指令跟随能力。该数据集包含 54,000 个精心策划的视频-指令-响应三元组,覆盖格式约束、时间定位、视觉与音频内容约束以及视听协同。
- 所属机构:NJU-LINK
- 许可证:CC-BY-NC-SA-4.0
- 语言:英语
- 下载链接:https://huggingface.co/datasets/NJU-LINK/OmniCap-IF-54K
构建流程
数据集通过三阶段流水线构建:视频筛选、约束感知指令合成、解耦响应生成。所得样本旨在训练模型生成有用的全视频字幕,同时遵守复杂的用户指定要求,例如 JSON 模式、Markdown 表格、时间戳格式、事件定位和跨模态推理。
数据格式
train.jsonl 文件每行存储一个训练样本。每个样本包含一个相对视频路径和一个单轮指令-响应对。示例如下:
json { "videos": ["LLaVA-Video-178K/ytb_KAqAdn1NXYE.mp4"], "messages": [ { "role": "user", "content": "<video> Using a JSON object, describe the causal relationship between the visual action and the audiences laughter." }, { "role": "assistant", "content": "{ "visual_trigger": "...", "audio_response_intensity": "...", "inferred_humor_mechanism": "..." }" } ] }
videos 字段中的路径是相对于解压后数据集根目录的。
数据集结构
发布内容包含以下文件:
train.jsonl:训练数据文件。LLaVA-Video-178K_part_*.tar.gz:视频压缩包(部分)。TikTok-10M_part_*.tar.gz:视频压缩包(部分)。
解压后,目录结构如下:
text OmniCap-IF-54K/ train.jsonl LLaVA-Video-178K/ ytb_*.mp4 ... TikTok-10M/ *.mp4 ...
相关资源
- 项目主页:https://nju-link.github.io/OmniCap-IF/
- GitHub 仓库:https://github.com/NJU-LINK/OmniCap-IF
- 论文:https://arxiv.org/abs/2606.xxxxx
- 模型(7B):https://huggingface.co/NJU-LINK/OmniCaptioner-IF-7B
- 模型(3B):https://huggingface.co/NJU-LINK/OmniCaptioner-IF-3B
- 测试集:https://huggingface.co/datasets/NJU-LINK/OmniCap-IF