surrogate-2-business-pipeline
收藏资源简介:
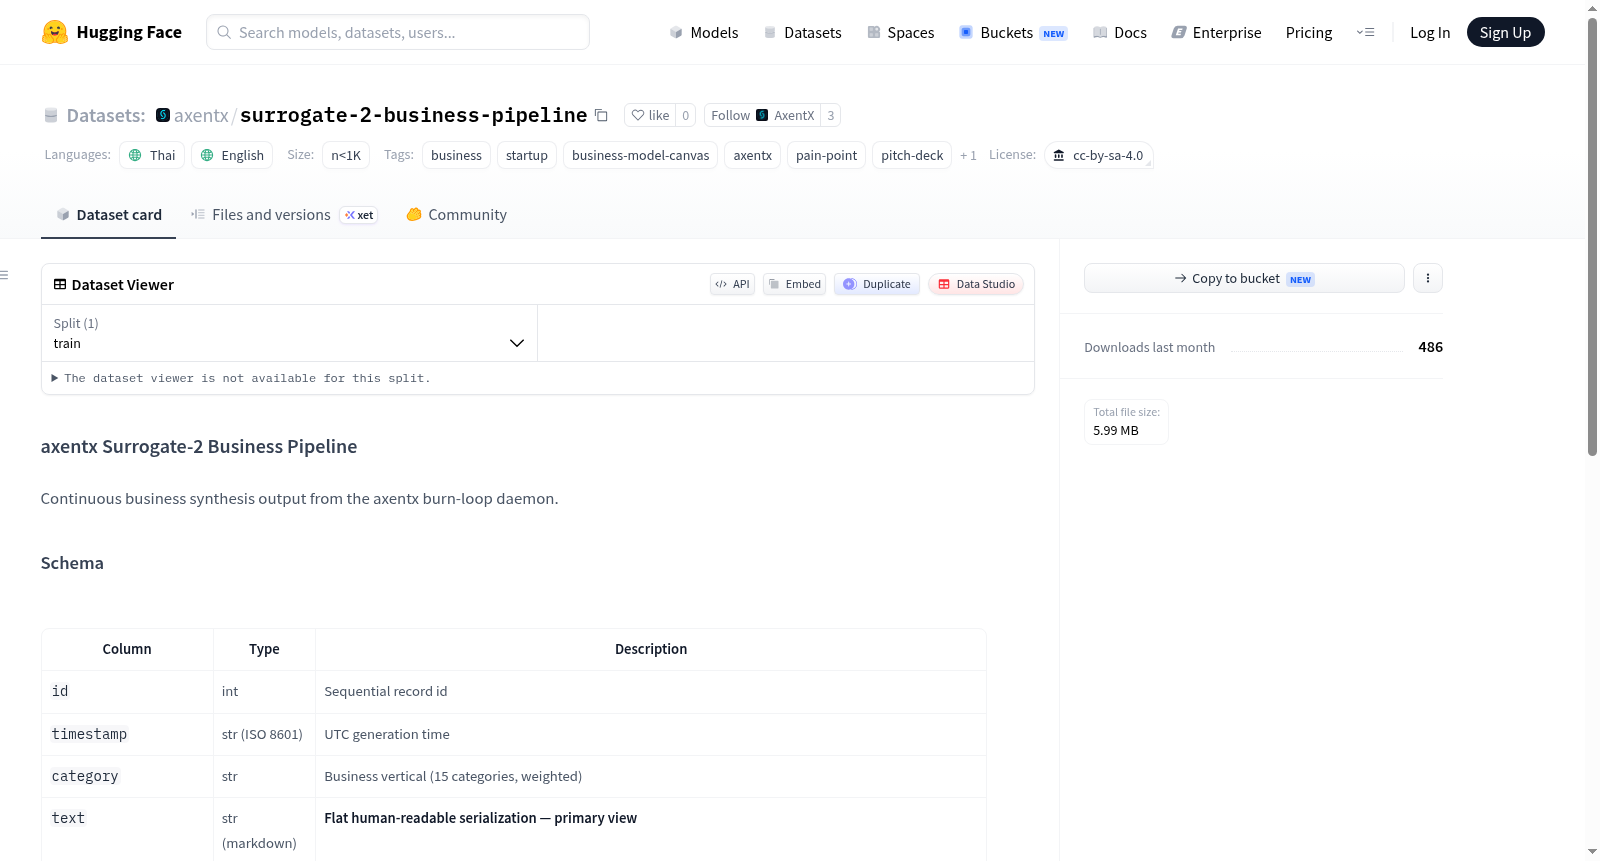
axentx Surrogate-2 Business Pipeline 是一个通过自动化流程生成的商业创意数据集,由 axentx burn-loop 守护程序持续合成输出。数据集旨在提供结构化的商业创意内容,适用于商业分析、创业教育、AI生成内容评估等场景。数据内容包含完整的商业创意要素:每个样本均包含一个唯一的顺序ID、ISO 8601格式的UTC生成时间戳、以及15个加权业务垂直类别之一。核心数据以Markdown格式的扁平化人类可读文本呈现,并附有结构化的商业模型画布(BMC),详细记录了创意名称、价值主张、目标客户、痛点问题、差异化优势、收入模型、市场规模(TAM/SAM/SOM)、启动成本(泰铢)、月收入潜力(泰铢)以及是否为科技类创意。此外,每个创意还包含一段60秒的电梯演讲、一个10页的路演大纲提纲,以及针对科技类创意的MVP代码骨架(可为空)。数据生成过程信息也被记录,包括生成每个部分所使用的特定大语言模型(LLM)以及生成所耗费的挂钟时间(秒)。数据集规模较小(少于1000个样本),以JSON文件格式存储,包含泰语和英语内容,遵循CC-BY-SA-4.0许可协议。数据生成于谷歌云平台(GCP)新加坡区域的SPOT n2-highmem-8实例,并综合利用了包括Cerebras、Groq、OpenRouter、Pollinations、OVHcloud、Cloudflare Workers AI、GitHub Models以及本地Ollama在内的多种LLM提供商和服务。
The axentx Surrogate-2 Business Pipeline is a business idea dataset generated through an automated pipeline, continuously synthesized and output by the axentx burn-loop daemon. The dataset aims to provide structured business idea content suitable for scenarios such as business analysis, entrepreneurship education, and AI-generated content evaluation. The data content includes complete business idea elements: each sample contains a unique sequential ID, a UTC timestamp in ISO 8601 format, and one of 15 weighted business vertical categories. The core data is presented in flattened human-readable text in Markdown format, accompanied by a structured Business Model Canvas (BMC), detailing the idea name, value proposition, target customers, pain points, differentiation advantages, revenue model, market size (TAM/SAM/SOM), startup cost (in Thai Baht), monthly revenue potential (in Thai Baht), and whether it is a tech-related idea. Additionally, each idea includes a 60-second elevator pitch, a 10-page pitch deck outline, and an MVP code skeleton for tech-related ideas (which may be empty). Information about the data generation process is also recorded, including the specific large language model (LLM) used to generate each part and the wall-clock time (in seconds) consumed during generation. The dataset is small in scale (fewer than 1000 samples), stored in JSON file format, contains content in Thai and English, and follows the CC-BY-SA-4.0 license. The data was generated on a SPOT n2-highmem-8 instance in the Google Cloud Platform (GCP) Singapore region, utilizing various LLM providers and services including Cerebras, Groq, OpenRouter, Pollinations, OVHcloud, Cloudflare Workers AI, GitHub Models, and local Ollama.
数据集概述
名称:axentx Surrogate-2 Business Pipeline
许可协议:CC-BY-SA-4.0(需署名,衍生作品需相同方式共享)
语言:泰语(th)、英语(en)
数据规模:小于1,000条(n<1K)
标签:business, startup, business-model-canvas, axentx, pain-point, pitch-deck, mvp
数据内容
数据集包含持续生成的商业创意合成输出,每条记录包含以下字段:
| 字段 | 类型 | 描述 |
|---|---|---|
id |
int | 顺序记录ID |
timestamp |
str (ISO 8601) | UTC生成时间 |
category |
str | 商业垂直领域(15个类别,加权分布) |
text |
str (markdown) | 扁平化人类可读序列化内容(主要视图) |
idea |
dict | 结构化商业模型画布:名称、价值主张、目标客户、问题、差异化因素、收入模型、TAM/SAM/SOM、初创成本(泰铢)、月收入潜力(泰铢)、是否技术驱动 |
pitch |
str | 60秒电梯演讲 |
deck |
str | 10页演示文稿大纲 |
mvp_code |
str (nullable) | 最小可行产品代码骨架(仅针对技术驱动型创意) |
models_used |
dict | 各章节由哪个大语言模型生成 |
wall_clock_seconds |
float | 生成延迟(秒) |
数据来源
- 由
axentx/surrogate-2-burn-loop在 GCP SPOT n2-highmem-8(新加坡)节点上持续生成 - 模型来源轮换:Cerebras、Groq、OpenRouter(15个免费模型)、Pollinations、OVHcloud、Cloudflare Workers AI、GitHub Models(13个PAT池)、本地Ollama(qwen3.6/qwen3-coder/gpt-oss)
配置与格式
- 默认配置名为
default - 训练集数据文件路径:
ideas/**/*.json