
遇见数据集

uploadm8-content-success-v1

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

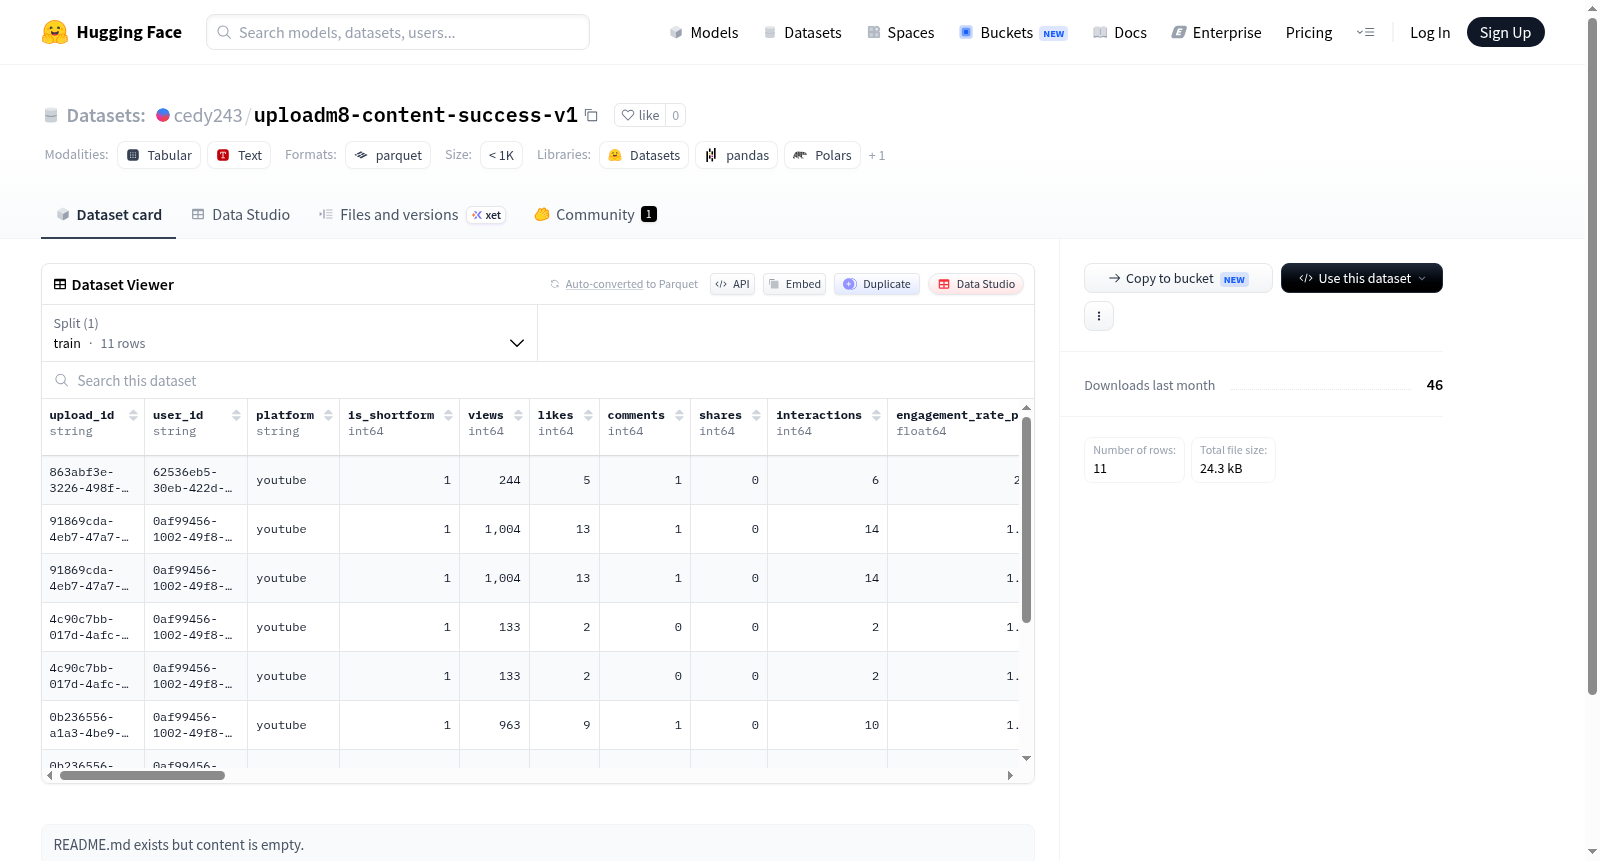
该数据集是一个社交媒体视频内容的元数据集合,旨在支持视频内容分析、用户参与度研究和AI辅助功能效果评估。数据集包含11个样本,每个样本代表一个视频上传记录,涵盖31个结构化特征字段。主要特征包括:基础标识(upload_id、user_id、platform)、内容属性(is_shortform、duration_seconds、content_category)、互动指标(views、likes、comments、shares、engagement_rate_pct)、AI功能使用情况(ai_hashtags_enabled、ai_hashtag_count、m8_engine)、时间特征(published_at、sent_dow_utc、sent_hour_utc)、视觉内容分析(object_track_count、person_segment_count、text_detection_count、has_people)以及综合评分指标(hotness_score、hydration_score、is_hot)。数据集适用于机器学习任务,如视频热度预测、用户参与度建模、内容推荐算法开发和AI生成工具的效果分析。

This dataset is a collection of metadata for social media video content, designed to support video content analysis, user engagement research, and evaluation of AI-assisted feature effectiveness. It contains 11 samples, each representing a video upload record and covering 31 structured feature fields. Key features include: basic identifiers (upload_id, user_id, platform), content attributes (is_shortform, duration_seconds, content_category), interaction metrics (views, likes, comments, shares, engagement_rate_pct), AI feature usage (ai_hashtags_enabled, ai_hashtag_count, m8_engine), temporal features (published_at, sent_dow_utc, sent_hour_utc), visual content analysis (object_track_count, person_segment_count, text_detection_count, has_people), and comprehensive scoring metrics (hotness_score, hydration_score, is_hot). The dataset is suitable for machine learning tasks such as video popularity prediction, user engagement modeling, content recommendation algorithm development, and effectiveness analysis of AI-generated tools.
创建时间:
2026-06-25
搜集汇总
数据集介绍
uploadm8-content-success-v1 数据集图片
构建方式
uploadm8-content-success-v1数据集基于短视频平台内容发布与传播的真实场景构建,汇集了来自不同平台的多模态内容元数据。每个样本以上传记录为核心单元,系统化收录了内容标识、用户信息、平台归属、内容类别及发布时效等基础属性。构建过程中,特别注重捕获内容表现层面的量化指标,如观看次数、互动数量、参与率及热度评分等,同时融入内容构成维度的特征,包括对象追踪数量、人物片段比例、文字检测频次、标志出现情况及封面选取模式等。此外,该数据集还整合了算法辅助标记信息,例如AI生成标签的启用状态与数量,以及缩略图渲染管线的配置策略,形成了从内容生成到表现评估的完整数据链路。
特点
该数据集的核心特点在于其多维度的特征体系与精细化的内容分析视角。在元数据层面,它同时涵盖发布行为的时空特征(如星期几与小时分布)和内容传播的动态指标(如日均观看量与年龄天数),构建了内容冷启动与持续表现的双重观察窗口。在内容结构层面,数据集通过对象检测、人物识别、文字提取等技术手段,将视觉内容的构成要素量化解析,使得研究能够深入探索内容特征与传播效果的潜在关联。特别是热度评分与二值化热度标记的设计,为识别潜在爆款内容提供了直接的理论锚点。此外,数据集还囊括了AI辅助创作工具的参与痕迹,为研究智能化内容生产的影响机制提供了独特的数据支撑。
使用方法
该数据集以标准化的表格格式存储,支持直接加载为DataFrame对象进行分析。用户可根据研究目标选择不同层次的变量组合:从基础的内容表现分析(如观看量与参与率的关系)到深度的内容特征挖掘(如视觉元素密度对传播效率的影响),均可灵活实现。数据集特别适合用于训练内容表现预测模型,探索热度演化规律,或分析AI辅助功能对内容传播效果的边际贡献。基于其包含的时空与平台信息,研究者还可以进行跨平台的内容策略对比分析。值得注意的是,该数据集当前仅提供训练集分割,包含11个样本,更适合作为小型验证集或特定场景的案例分析数据源,大规模应用前建议结合外部数据进行扩展验证。
背景与挑战
背景概述
在短视频内容创作与分发领域,内容运营者常依赖直觉或经验进行决策,缺乏针对多维特征与用户互动之间关联性的量化分析工具。Uploadm8-content-success-v1数据集由Uploadm8团队创建,旨在通过记录包括观看量、点赞、评论、分享等在内的用户互动数据,以及内容类型、标题长度、字幕特征、AI标签使用情况等多维属性,探讨影响内容成功的关键因素。该数据集聚焦于视频内容的互动表现与内容特征之间的关联,为内容策略优化提供了数据支撑,在社交媒体分析与内容推荐系统研究中具有潜在价值。
当前挑战
该数据集面临的核心挑战在于构建一个能够准确预测内容成功(如高互动率或热度)的模型。领域问题上,短视频内容的成功受多种复杂因素交织影响,包括平台算法、用户偏好动态变化以及内容时效性等,传统简单线性模型难以捕捉这些非线性关系。构建过程中,由于数据仅包含11个样本,且存在大量空值特征(如content_category、caption_style等),导致数据稀疏性显著,难以训练鲁棒模型。此外,特征间可能存在多重共线性,需要谨慎处理以避免过拟合,同时有效利用有限样本进行特征选择与验证,成为实际应用中的关键瓶颈。
常用场景
经典使用场景
在内容创作与社交媒体分析领域,uploadm8-content-success-v1数据集以其精细的元数据结构,成为探究短视频内容表现的关键资源。该数据集记录了每一条内容的播放量、点赞、评论、分享及互动率等核心指标,并辅以发布时间、时长、标题长度、字幕长度以及是否包含人物、Logo检测等视觉特征。研究者可借此挖掘内容属性与传播效果之间的深层关联,例如分析不同时段发布对播放量的影响,或探索字幕风格与互动率的潜在联系,为内容策略优化提供数据支撑。
衍生相关工作
基于该数据集,学术界与工业界已衍生出一系列经典工作,主要包括内容流行度预测、多模态特征融合分析以及用户参与行为建模等领域。具体而言,研究者利用播放量、互动率及标签计数等列,构建了基于时序特征的传播曲线预测模型;同时结合视觉元数据(如人物检测、Logo计数)与文本特性(如标题长度),探索了多模态表征在内容质量评估中的增益效果。此外,热力分数与日均播放量的引入,催生了基于早期曝光数据的成功度判别算法,显著提升了内容冷启动阶段的筛选效率。
数据集最近研究
最新研究方向
该数据集聚焦于社交媒体平台内容传播效果的多维度量化分析,尤其在短视频与图文混排内容风靡的当下,通过整合用户行为指标(浏览量、互动率、热度评分)与内容属性特征(标题长度、字幕帧数、视觉元素检测结果),为理解算法推荐机制及用户参与度驱动因素提供了结构化数据支撑。当前前沿研究方向集中在利用该数据集构建预测模型,探索AI增强标签(m8_engine、ai_hashtags_enabled)与内容热度(is_hot)间的非线性关系,并挖掘发布时间(sent_hour_utc、sent_dow_utc)对传播效率的时空调控作用。这一研究路径呼应了平台经济中“内容—算法—用户”三角博弈的热点,对优化创作者策略与提升信息分发效能具有重要实践意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

