community-datasets/gnad10
收藏资源简介:
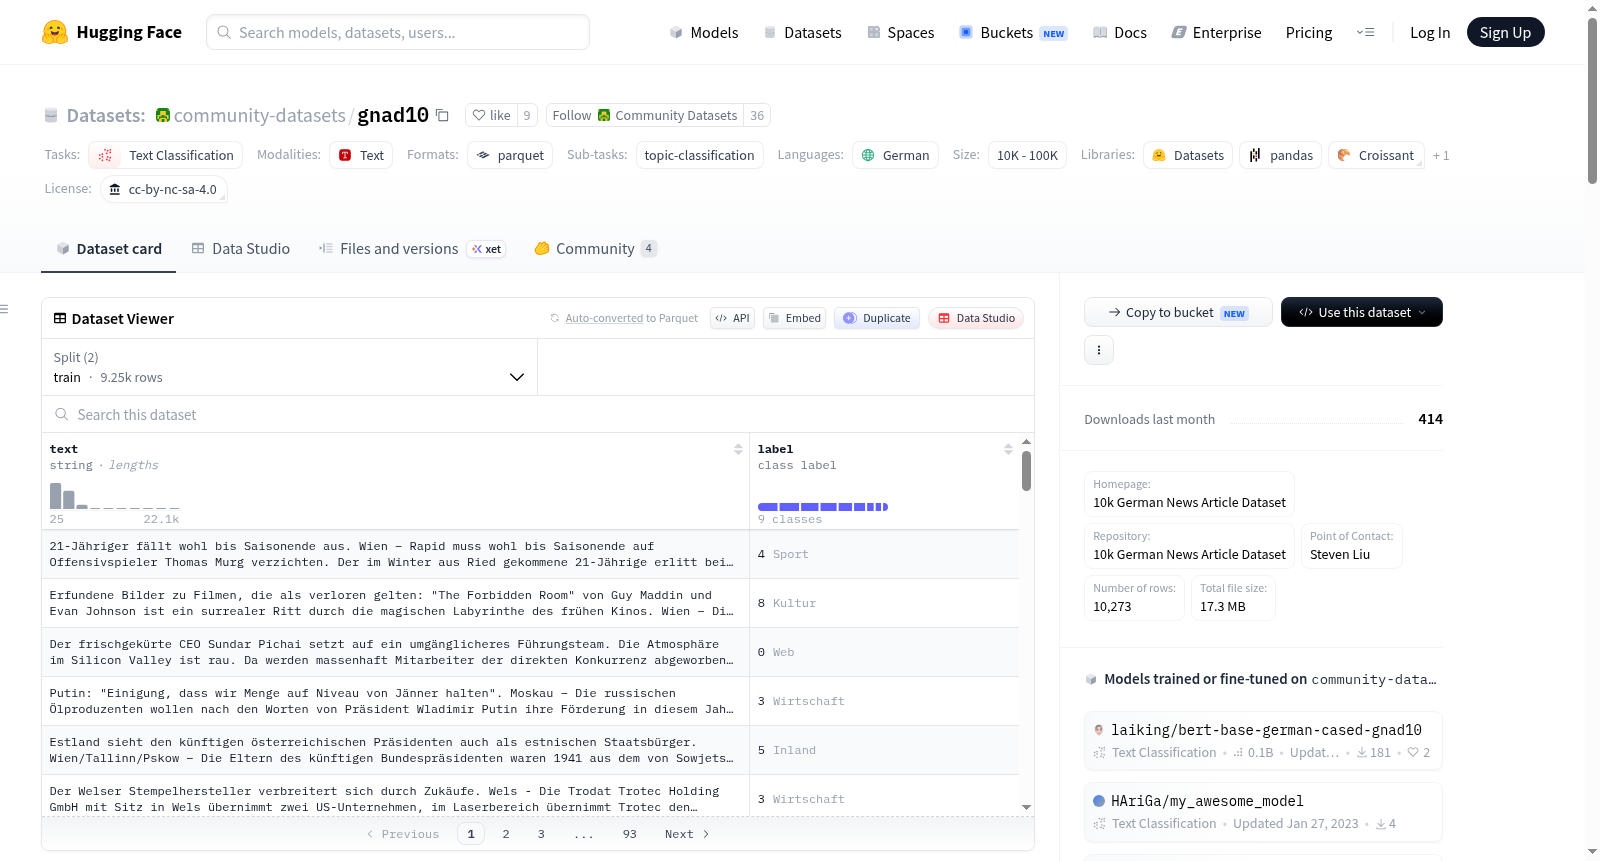
10k German News Articles Datasets数据集包含10273篇来自奥地利在线报纸DER Standard的德语新闻文章。每篇文章由专业的论坛版主分类为9个类别之一。该数据集是从One Million Posts Corpus扩展而来,旨在支持德语主题分类任务。数据集分为训练集(9245篇文章)和测试集(1028篇文章)。数据集的创建是为了解决英语文本分类模型在德语文本上效果不佳的问题,因为德语的语法结构更为复杂。数据集的结构包括两个字段:text(包含文章标题和内容)和label(9个可能的主题类别之一)。
The 10k German News Article Dataset consists of 10273 German language news articles from the online Austrian newspaper website DER Standard. Each news article has been classified into one of 9 categories by professional forum moderators employed by the newspaper. This dataset is extended from the original One Million Posts Corpus. The dataset was created to support topic classification in German because a classifier effective on an English dataset may not be as effective on a German dataset due to higher inflections and longer compound words. The dataset is split into a training set consisting of 9245 articles and a test set consisting of 1028 articles. The dataset structure includes two fields: text (containing the title and content of the article) and label (one of 9 possible topic categories).
10k German News Articles Datasets 数据集概述
数据集描述
数据集摘要
10k German News Article Dataset 包含 10273 篇来自奥地利在线报纸网站 DER Standard 的德语新闻文章。每篇文章由专业论坛版主分类为 9 个类别之一。该数据集是从 One Million Posts Corpus 扩展而来,旨在支持德语主题分类,因为针对英语数据集训练的分类器可能不适用于德语数据集。
支持的任务和排行榜
该数据集可用于训练模型(如 BERT)进行德语新闻文章的主题分类,共有 9 个可能的类别。
语言
数据集中的文本为德语,来自奥地利在线报纸网站,德语的 BCP-47 代码为 de-DE。
数据集结构
数据实例
一个数据实例包含一篇德语新闻文章(标题和内容拼接)及其对应的主题类别。
json { "text": "Die Gewerkschaft GPA-djp lanciert den All-in-Rechner und findet, dass die Vertragsform auf die Führungsebene beschränkt gehört. Wien – Die Gewerkschaft GPA-djp sieht Handlungsbedarf bei sogenannten All-in-Verträgen.", "label": "Wirtschaft" }
数据字段
text: 包含文章的标题和内容。label: 可以是 9 个可能的主题类别之一(Web,Panorama,International,Wirtschaft,Sport,Inland,Etat,Wissenschaft,Kultur)。
数据分割
数据分为训练集(包含 9245 篇文章)和测试集(包含 1028 篇文章)。
数据集创建
策划理由
该数据集旨在支持德语主题分类。英语文本分类数据集较为常见(如 AG News 和 20 Newsgroup),但德语数据集较少。由于语法差异,针对英语数据集训练的分类器可能不适用于德语文本。因此,需要一个德语数据集来有效评估模型性能。
源数据
初始数据收集和规范化
10k German News Article Dataset 是从 One Million Posts Corpus 扩展而来。从该大型语料库中收集了 10273 篇德语新闻文章。在 One Million Posts Corpus 中,每篇文章都有一个主题路径,如 Newsroom/Wirtschaft/Wirtschaftpolitik/Finanzmaerkte/Griechenlandkrise。10kGNAD 使用主题路径的第二部分作为主题标签。文章标题和内容拼接成一个文本,并移除作者姓名,以避免基于频繁撰写特定主题的作者进行关键词分类。
源语言生产者
语言生产者是奥地利报纸网站 DER Standard 的作者。
注释
注释过程
[更多信息需补充]
注释者
[更多信息需补充]
个人和敏感信息
[更多信息需补充]
使用数据的注意事项
数据集的社会影响
[更多信息需补充]
偏见讨论
[更多信息需补充]
其他已知限制
[更多信息需补充]
附加信息
数据集策展人
该数据集由 Timo Block 策展。
许可信息
该数据集根据 Creative Commons Attribution-NonCommercial-ShareAlike 4.0 许可证授权。
引用信息
如果您使用该数据集,请考虑引用 "One Million Post Corpus" 的作者: bibtex @InProceedings{Schabus2017, Author = {Dietmar Schabus and Marcin Skowron and Martin Trapp}, Title = {One Million Posts: A Data Set of German Online Discussions}, Booktitle = {Proceedings of the 40th International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR)}, Pages = {1241--1244}, Year = {2017}, Address = {Tokyo, Japan}, Doi = {10.1145/3077136.3080711}, Month = aug }
贡献
感谢 @stevhliu 添加此数据集。