
遇见数据集

doctolib-lab/finemed-fr

收藏
Hugging Face2026-06-23 更新2026-07-22 收录
官方服务:

资源简介:

FineMed-fr 是一个大规模、公开可用的法语医学文本语料库,用于语言模型预训练。它包含来自三个异构开放网络源(FineWeb-2、FinePDFs 和 FineWiki)的医学内容,总计 21.1M 文档和 19.2B 单词,涵盖了真实世界的医学写作。每个文档都沿三个维度进行标注:子领域(分为 15 个医学子领域,如生物医学与临床写作、面向消费者的材料)、教育质量(基于 FineWeb-Edu 改编的 0-5 分评分)和医学术语密度(通过提取的医学术语字符覆盖比例衡量)。数据集以未过滤形式发布,用户可以根据注释列自定义阈值以适应任务需求。

FineMed-fr is a large, openly available corpus of French medical text for language-model pretraining: 21.1M documents and 19.2B words of real-world medical writing, annotated along several quality axes. The corpus is drawn from three heterogeneous open-web sources (FineWeb-2, FinePDFs, and FineWiki), which together provide the scale, source diversity, and stylistic range that curated medical corpora often lack. We keep only the French medical content, then label every surviving document along three axes: Subdomain (which of 15 medical subdomains the document belongs to), Educational quality (how instructive the document is for medical education, scored 0–5), and Medical-term density (the richness of medical terminology, measured as the fraction of characters that fall inside extracted medical-term spans). The corpus is released unfiltered so users can set their own thresholds on the annotation columns to fit their task.
提供机构:
doctolib-lab
搜集汇总
数据集介绍
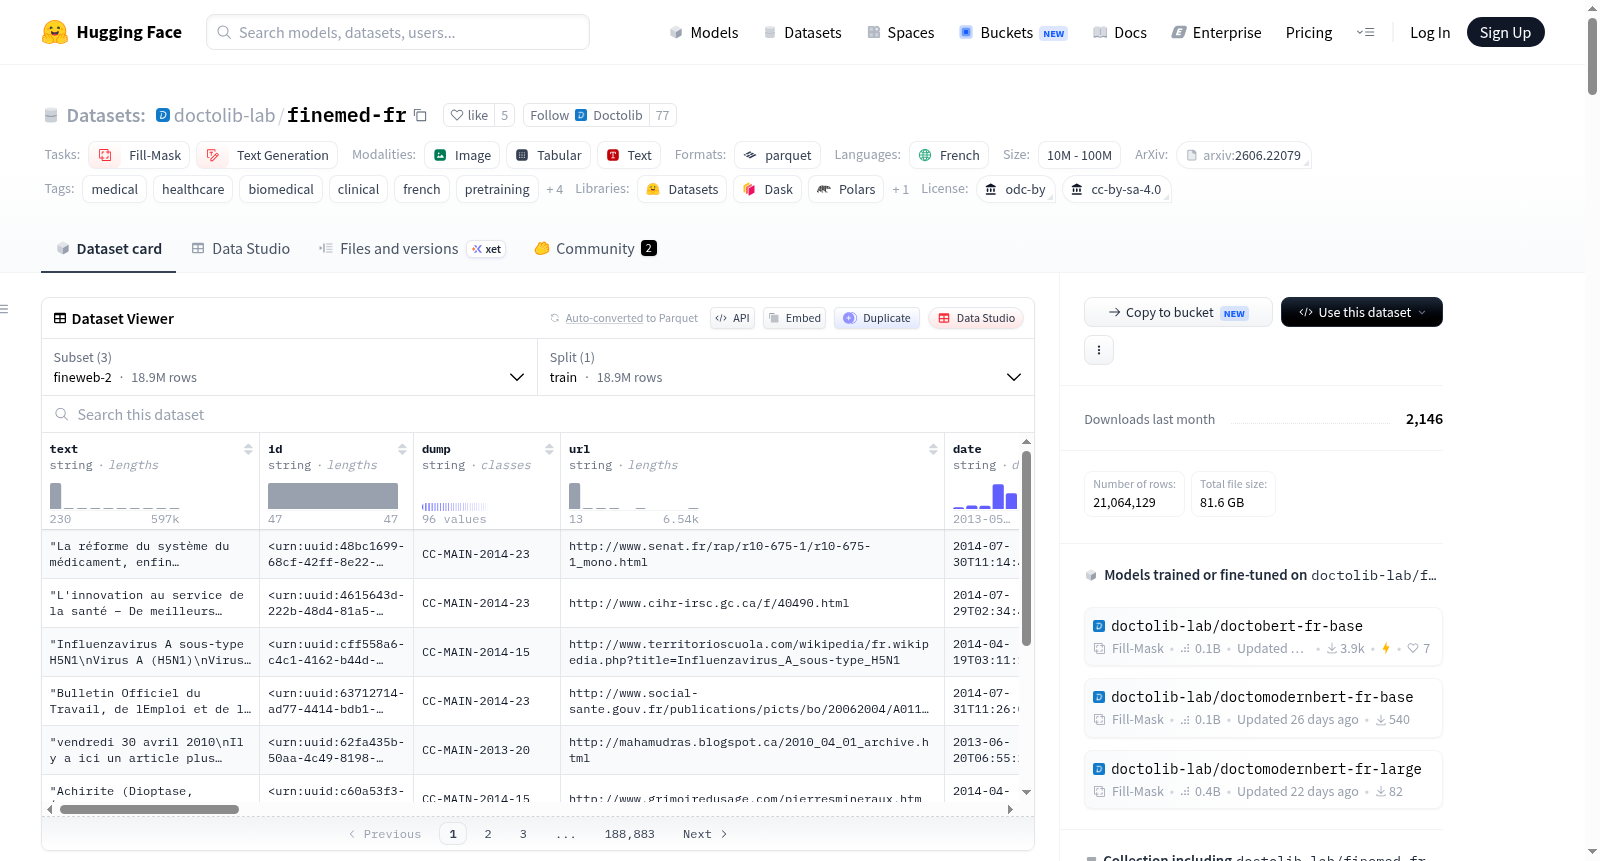
doctolib-lab/finemed-fr 数据集图片
构建方式
FineMed-fr语料库的构建基于三大异构开源数据源——FineWeb-2、FinePDFs与FineWiki,通过多阶段流水线实现精细化筛选与标注。首先,利用多语言领域分类器对每份文档的前512个token进行预测,仅保留标签为'Health'的医学内容,从而将各源数据压缩至原规模的1.5%至7.7%。随后,采用三组轻量级标注器对留存文档进行多轴标注,这些标注器通过两阶段知识蒸馏从LLM教师模型中习得能力,大幅降低了计算成本。标注维度涵盖医学子领域分类(15类)、教育质量评分(0–5分)以及医学术语密度(基于字符覆盖比例),最终形成包含约2100万文档、192亿词的高质量法语医学语料。
特点
该数据集的核心特色在于其多元质量标注体系,为下游任务提供了灵活的选择空间。每个文档均附有15类医学子领域标签,区分了生物医学文献、临床指南、患者教育乃至商业推广内容,反映了真实医学写作的异质性。教育质量评分改编自FineWeb-Edu的评量标准,专门针对医学教育场景优化,分数从0到5跨度分明。医学术语密度则通过提取8类UMLS启发的实体(如疾病、药物、解剖部位)并计算其字符占比来量化,使得研究者可以依据自身需求设定阈值,筛选出术语丰富或教育价值高的子集。这种未经过滤的发布策略,赋予用户按需定制的自主权。
使用方法
使用FineMed-fr时,可通过Hugging Face Datasets库的load_dataset函数加载三个独立配置(fineweb-2、finepdfs、finewiki)中的任意一个,默认指向fineweb-2分片。由于语料以未过滤形式发布,用户需根据需求自行筛选,例如利用edu_quality_normalized_score和medical_entity_density列,借助filter方法保留高质量、术语密集的文档(如设定阈值edu >= 4且density >= 0.1)。数据字段包含完整的文本内容、来源URL、多轴标注分数及结构化医学术语字典,支持掩码语言建模与文本生成等预训练任务,为法语医学自然语言处理研究提供了坚实的数据基础。
背景与挑战
背景概述
FineMed-fr数据集由Doctolib实验室于2026年创建,旨在填补法语医学领域大规模预训练语料库的空白。该数据集整合了FineWeb-2、FinePDFs和FineWiki三大开放网络来源,通过多轴标注(医学子领域、教育质量、医学术语密度)构建了包含2110万文档和192亿词的法语医学文本库。其核心研究问题在于如何系统性地从异构网络文本中筛选和标注高质量医学内容,以支持医学语言模型的预训练。作为目前最大的法语医学公开语料库,FineMed-fr推动了非英语医学自然语言处理的发展,为DoctoBERT等专用模型的训练提供了关键数据基础。
当前挑战
数据集面临的首要挑战是解决法语医学文本领域语料匮乏的问题,尤其是需要从海量开放网络数据中精准识别仅占极小比例的医学内容(FineWeb-2中仅5.3%),并过滤掉大量商业推广和低质量页面。构建过程中面临的技术挑战包括:开发轻量化但高精度的多轴标注器,通过两阶段知识蒸馏从大语言模型中获取标注能力,将标注成本降低约一个数量级;同时需处理来自不同来源的异构数据格式,确保跨来源标注的一致性。此外,医学文本中可能包含个人健康信息,如何在不影响数据可用性的前提下处理隐私问题成为伦理层面的关键挑战。
常用场景
经典使用场景
在法语医学自然语言处理领域,FineMed-fr数据集最经典的用途在于为大规模语言模型的预训练提供高质量的法语医学语料。该数据集汇聚了来自FineWeb-2、FinePDFs和FineWiki三大异构开放网络来源的超过2100万份文档与192亿词汇,涵盖临床指南、科研论文、患者教育材料等15个医学子领域。研究者可直接利用其原始文本与多轴注释信息,对模型进行掩码语言建模或文本生成任务的预训练,从而提升模型在法语医学术语理解与生成方面的能力。
解决学术问题
该数据集系统性地解决了法语生物医学领域长期面临的高质量语料稀缺与标注标准缺失问题。过去,学术研究常受限于小规模、单来源或未标注的医疗文本,难以支撑深度学习模型的稳健训练。FineMed-fr通过提供子领域分类、教育质量评分与医学术语密度三个维度的细粒度注释,使研究者能够精准筛选语料子集,用于探究不同质量层次与术语丰富度对下游任务(如临床命名实体识别、医学文本检索、问答系统)的影响,显著推动了法语医疗NLP的实证研究进展。
衍生相关工作
基于FineMed-fr数据集,研究者已衍生出多项经典工作,其中最引人注目的是DoctoBERT系列法语医学编码器模型。该模型利用FineMed-fr的多轴注释指导预训练策略,通过选择高教育质量与高医学术语密度的文档进行掩码语言建模,在多个法语医学理解基准上取得领先表现。此外,数据集驱动的注释模型——包括子领域分类器、教育质量评分器与医学术语提取器——本身也成为可复用的工具,促进了更广泛的法律、伦理与多语言医学语料的自动标注研究。这些工作共同编织了一个以数据为中心的法语医学AI研究框架,为后续领域探索奠定了基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

