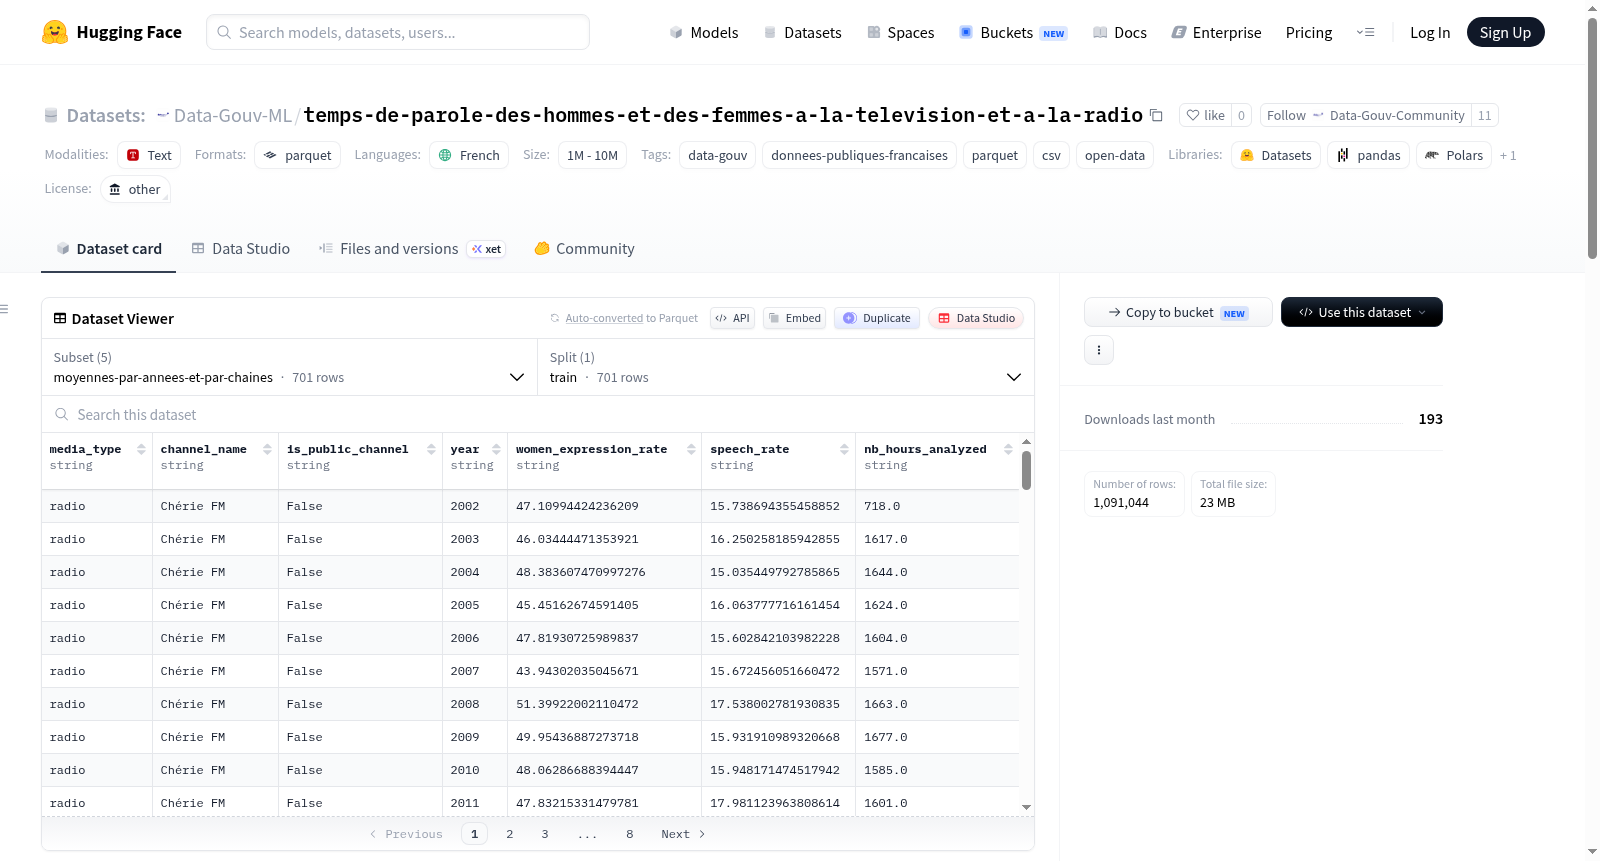
Data-Gouv-FR/temps-de-parole-des-hommes-et-des-femmes-a-la-television-et-a-la-radio
收藏资源简介:
--- license: other language: - fr tags: - data-gouv - donnees-publiques-francaises - parquet - csv - open-data pretty_name: "Temps de parole des hommes et des femmes à la télévision et à la radio" configs: - config_name: moyennes-par-annees-et-par-chaines data_files: - split: train path: data/moyennes-par-annees-et-par-chaines.parquet - config_name: temps-de-musique-et-temps-de-parole-des-hommes-et-des-femmes-a-la-tv-et-a-la-radio data_files: - split: train path: data/temps-de-musique-et-temps-de-parole-des-hommes-et-des-femmes-a-la-tv-et-a-la-radio.parquet - config_name: moyennes-par-heure-annee-et-chaine data_files: - split: train path: data/moyennes-par-heure-annee-et-chaine.parquet - config_name: taux-d-expression-des-femmes-annuel-a-la-radio-1995-2019 data_files: - split: train path: data/taux-d-expression-des-femmes-annuel-a-la-radio-1995-2019.parquet - config_name: taux-d-expression-des-femmes-annuel-a-la-television-2010-2019 data_files: - split: train path: data/taux-d-expression-des-femmes-annuel-a-la-television-2010-2019.parquet --- # Temps de parole des hommes et des femmes à la télévision et à la radio ## Source - Source officielle : https://www.data.gouv.fr/datasets/temps-de-parole-des-hommes-et-des-femmes-a-la-television-et-a-la-radio - Identifiant du jeu de données data.gouv.fr : `5c6adbae634f4114a5c41776` - Slug data.gouv.fr : `temps-de-parole-des-hommes-et-des-femmes-a-la-television-et-a-la-radio` - Licence indiquée dans les métadonnées data.gouv.fr : fr-lo ## Structure Hugging Face - Un jeu de données data.gouv.fr = un dépôt Hugging Face - Une ressource tabulaire d’origine = un sous-ensemble/configuration Hugging Face - Chaque sous-ensemble/configuration contient un split nommé `train` ## Sous-ensembles - `moyennes-par-annees-et-par-chaines` → `data/moyennes-par-annees-et-par-chaines.parquet` - `temps-de-musique-et-temps-de-parole-des-hommes-et-des-femmes-a-la-tv-et-a-la-radio` → `data/temps-de-musique-et-temps-de-parole-des-hommes-et-des-femmes-a-la-tv-et-a-la-radio.parquet` - `moyennes-par-heure-annee-et-chaine` → `data/moyennes-par-heure-annee-et-chaine.parquet` - `taux-d-expression-des-femmes-annuel-a-la-radio-1995-2019` → `data/taux-d-expression-des-femmes-annuel-a-la-radio-1995-2019.parquet` - `taux-d-expression-des-femmes-annuel-a-la-television-2010-2019` → `data/taux-d-expression-des-femmes-annuel-a-la-television-2010-2019.parquet` ## Utilisation ```python from datasets import load_dataset # Choisir un sous-ensemble/configuration : ds = load_dataset("Data-Gouv-FR/temps-de-parole-des-hommes-et-des-femmes-a-la-television-et-a-la-radio", "moyennes-par-annees-et-par-chaines") print(ds["train"]) ``` ## Description originale Temps de parole des hommes et des femmes, correspondant à plus d'un million d'heures de programmes diffusés de 1995 au 28 février 2019. Les temps de parole sont obtenus automatiquement à l'aide du logiciel libre [inaSpeechSegmenter](http://github.com/ina-foss/inaSpeechSegmenter), développé à l'INA. Ce logiciel est basé sur des algorithmes d'apprentissage automatique (sous-famille de l'intelligence artificielle) entraînés sur un grand nombre d'exemples de musique, de voix de femme et de voix d'homme, afin de détecter les zones de musique et les zones de parole contenues dans les documents audiovisuels. Les temps de parole sont estimés par tranches d'une heure, de 5h à minuit pour la radio et de 10h à minuit pour la télévision. Les 21 stations de radio analysées sont Chérie FM, Europe 1, France Bleu, France Culture, France Info, France Inter, France Musique, Fun Radio, Mouv’, NRJ, Nostalgie, RFM, RMC, RTL, RTL 2, Radio Classique, Radio France Internationale, Rire et Chansons, Skyrock, Sud Radio et Virgin Radio. Les 34 chaînes de TV analysées sont Arte, Animaux, BFM TV, Canal+, Canal+ Sport, Chasse et pêche, Chérie 25, Comédie+, D8/C8, Euronews, Eurosport France, France 2, France 24, France 3, France 5, France O, Histoire, I-Télé/CNews, L'Equipe 21, LCI, LCP/Public Sénat, La chaîne Météo, M6, Monte Carlo TMC, NRJ 12, Paris Première, Planète+, TF1, TV Breizh, TV5 Monde, Toute l'Histoire, Téva, Voyage, W9 Le fonctionnement du logiciel d’analyse automatique utilisé sur les documents audiovisuels, ainsi que l’estimation de sa fiabilité, sont décrits dans l'article ci-dessous: David Doukhan et Jean Carrive, "[Description automatique du taux d’expression des femmes dans les flux télévisuels français](https://www.isca-archive.org/jep_2018/doukhan18_jep.pdf)", XXXIIe Journées d’Études sur la Parole, Juin 2018 Les relations existant entre le temps de parole, pourcentage de visages, nombre de mentions orales et décomptes manuels sont détaillées dans l'article ci-dessous: David Doukhan, Lena Dodson, Manon Conan, Valentin Pelloin, Aurélien Clamouse, Mélina Lepape, Géraldine Van Hille, Cécile Méadel et Marlène Coulomb-Gully, "[Gender Representation in TV and Radio: Automatic Information Extraction methods versus Manual Analyses ](https://www.isca-archive.org/interspeech_2024/doukhan24_interspeech.pdf)", pages 3060-3064,Interspeech 2024
The dataset involves the speaking time of men and women on television and radio, covering over one million hours of programs broadcast from 1995 to February 28, 2019. Speaking times are obtained automatically using the open-source software inaSpeechSegmenter, developed by INA. This software is based on machine learning algorithms trained on a large number of examples of music, female voices, and male voices to detect music and speech areas in audiovisual documents. Speaking times are estimated in hourly slices, from 5 am to midnight for radio and from 10 am to midnight for television. The 21 radio stations analyzed include Chérie FM, Europe 1, France Bleu, etc., and the 34 TV channels analyzed include Arte, BFM TV, Canal+, etc. The dataset also includes references to research papers describing the operation of the automatic analysis software and its reliability estimation, as well as the relationships between speaking time and gender representation.