emolia-voicenet-gemini-annotations
收藏资源简介:
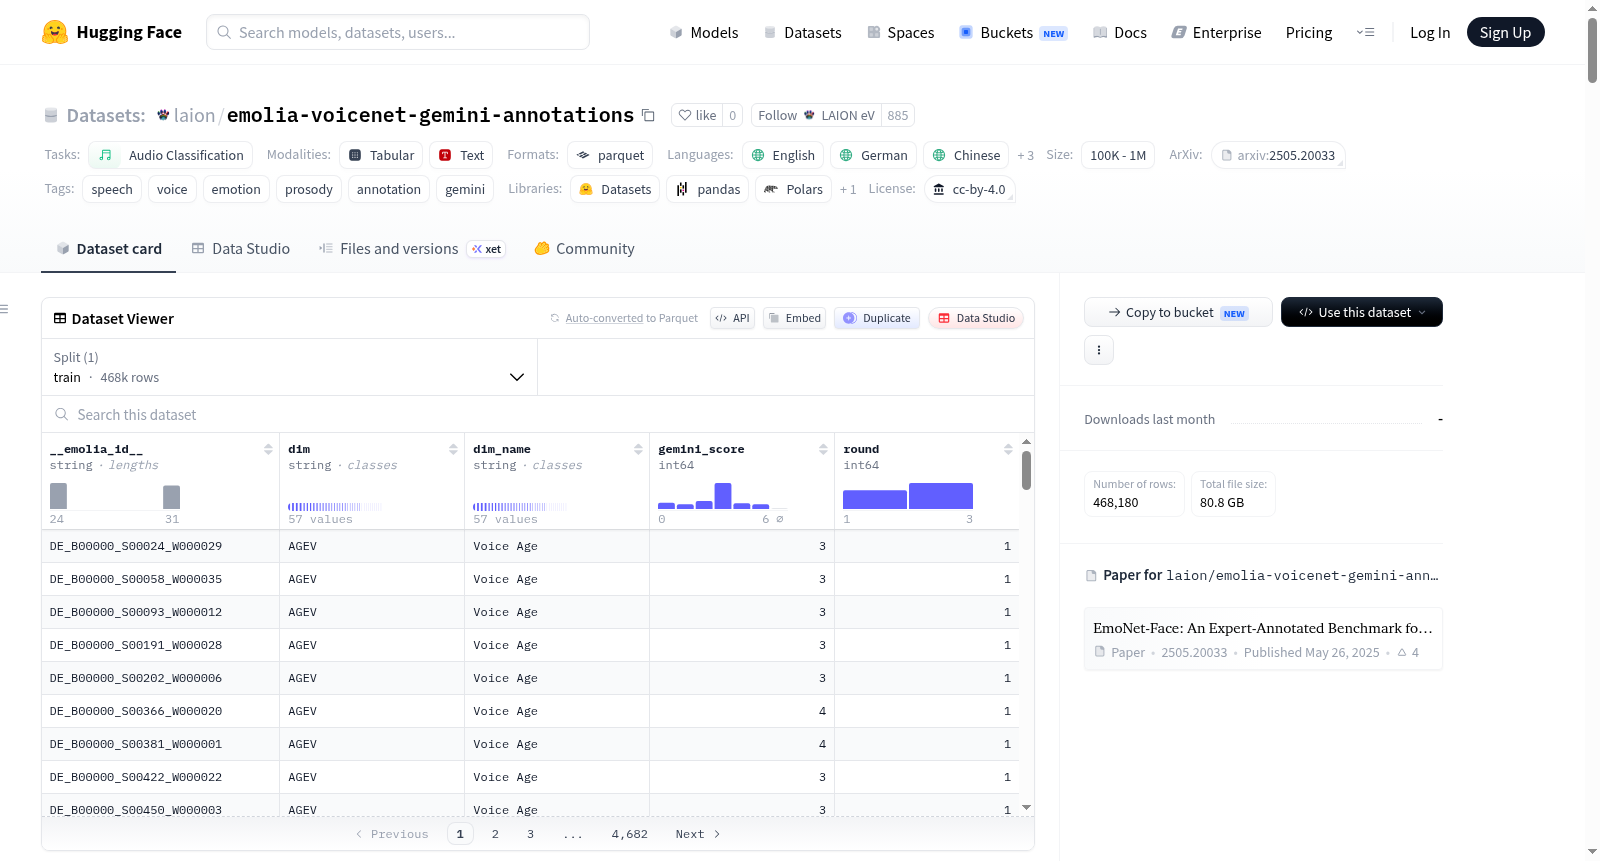
Emolia VoiceNet Gemini Annotations 是一个大规模的语音感知维度注释数据集,旨在为 VoiceNet 项目提供训练数据。该数据集基于 VoiceNet-Ext 分类体系,包含 57 个细粒度的、有序的语音表现维度,如唤醒度、效价、亮度、共鸣位置、说话风格、真实性、录音质量等。数据内容包含 468,180 个维度级别的注释,覆盖 236,613 个来自 Emolia 语料库的语音片段。每个注释对应一个(语音片段,维度)组合,并由 Gemini 3.5 Flash 模型(非思考模式,温度0)根据该维度的完整 0-6 级评分标准(内容适当性维度为 0-2 级)给出一个整数分数。注释为模型生成,非人工标注。语音片段以英语和德语为主,同时包含少量中文、法语、韩语和日语。数据集通过多轮流程构建以优化分数分布的平衡性:首先使用 VoiceCLAP 零样本分桶为每个维度选择跨分数级别的候选片段;然后由 Gemini 进行评分;后续轮次针对代表性不足的(维度 x 分数桶)单元进行针对性补充。最终数据集的平均平衡度(归一化香农熵)为 0.552。数据集提供了详细的每维度统计数据,包括样本数量、平均分数和平衡度,并列举了平衡度最佳和最差的维度示例。数据集文件包括:注释表(包含片段ID、维度代码、维度名称、Gemini分数、轮次)、原始模型输出文本、音频来源清单(用于从外部仓库获取对应的 .flac 音频文件)以及完整的分类体系定义文件。数据集本身不包含音频文件(约 2 TB),但提供了完整的获取指引。该数据集适用于语音分类、语音情感与韵律分析、以及训练预测复杂语音属性的机器学习模型等任务。需要注意的是,注释反映了生成式模型的感知判断和偏差,且某些精细的共鸣维度在现有标签下分数分布极为集中。数据集采用 CC-BY-4.0 许可证发布。
Emolia VoiceNet Gemini Annotations is a large-scale dataset of voice perception dimension annotations, designed to provide training data for the VoiceNet project. The dataset is based on the VoiceNet-Ext taxonomy and includes 57 fine-grained, ordered voice performance dimensions, such as arousal, valence, brightness, resonance location, speaking style, authenticity, recording quality, etc. The data consists of 468,180 dimension-level annotations covering 236,613 voice clips from the Emolia corpus. Each annotation corresponds to a (clip, dimension) pair and is assigned an integer score by the Gemini 3.5 Flash model (non-thinking mode, temperature 0) according to the full 0-6 rating scale for that dimension (with a 0-2 scale for content appropriateness dimensions). The annotations are model-generated, not human-annotated. The voice clips are primarily in English and German, with a small number in Chinese, French, Korean, and Japanese. The dataset was constructed through a multi-round process to optimize the balance of score distributions: first, VoiceCLAP zero-shot bucketing was used to select candidate clips across score levels for each dimension; then Gemini performed scoring; subsequent rounds targeted under-represented (dimension x score bucket) units for supplemental annotation. The final dataset has an average balance (normalized Shannon entropy) of 0.552. The dataset provides detailed per-dimension statistics, including sample count, average score, and balance, and lists examples of dimensions with the best and worst balance. The dataset files include: an annotation table (with clip ID, dimension code, dimension name, Gemini score, round), raw model output text, an audio source manifest (for retrieving corresponding .flac audio files from external repositories), and a complete taxonomy definition file. The dataset itself does not include audio files (approximately 2 TB), but provides complete retrieval instructions. The dataset is suitable for tasks such as voice classification, voice emotion and prosody analysis, and training machine learning models to predict complex voice attributes. It should be noted that the annotations reflect the perceptual judgments and biases of the generative model, and some fine-grained resonance dimensions have highly concentrated score distributions under the existing labels. The dataset is released under the CC-BY-4.0 license.
数据集概要
Emolia VoiceNet Gemini Annotations 是一个由 LAION 创建的数据集,包含 468,180 条维度级标注,覆盖 236,613 个 Emolia 语音片段。每个语音片段在 57 个感知语音/说话维度(如唤醒度、效价、明亮度、共鸣位置、说话风格、真实性、录音质量等)上由 Gemini 3.5 Flash 模型(非思维链模式,温度参数为 0)进行 0-6 分的评分(内容适切性维度为 0-2 分)。数据集中包含标注、音频来源、各维度统计信息以及完整的评分分类体系,标注音频也以 WebDataset 格式包含在仓库中。
许可证: CC-BY-4.0
主要特性
- 标注数量: 468,180 条维度级标注
- 语音片段数量: 236,613 个独特音频片段
- 标注维度: 57 个
- 评分范围: 0-6 分(内容适切性维度为 0-2 分)
- 标注模型: Gemini 3.5 Flash(温度 0,无思维链)
- 音频语言: 主要为英语和德语,另有少量中文、法语、韩语和日语
- 数据规模: 100K < n < 1M
- 任务类别: 音频分类
数据构成与文件
标注数据 (data/annotations.parquet)
包含 468,180 行标注数据,主要列如下:
| 列名 | 类型 | 描述 |
|---|---|---|
__emolia_id__ |
string | Emolia 语音片段 ID (如 EN_B00020_S08991_W000042) |
dim |
string | 维度代码 (如 AROU) |
dim_name |
string | 维度可读名称 |
gemini_score |
Int64 (可空) | Gemini 评分,0-6 (内容适切性为 0-2);解析失败时为 null |
round |
int64 | 标注轮次 (1, 2 或 3) |
原始模型输出 (data/annotations_raw.parquet)
包含 468,180 行原始模型文本,主要列为 __emolia_id__、dim 和 raw(模型输出原始文本)。
音频来源清单 (data/manifest.parquet)
包含 468,058 行音频来源信息(每对 (片段, 维度) 一行),主要列如下:
| 列名 | 类型 | 描述 |
|---|---|---|
__emolia_id__ |
string | Emolia 语音片段 ID |
dim |
string | 维度代码 |
round |
int64 | 产生该片段的轮次 |
audio_repo |
string | 音频文件所在 Hugging Face 数据集仓库 |
source_tar |
string | 仓库中的 tar 文件成员 |
key |
string | tar 条目基础名称 |
维度统计 (stats/per_dimension_stats.parquet / .csv)
包含每个维度的名称、等级数、计数、各评分等级的计数、平均 Gemini 评分以及平衡度(归一化香农熵)。
完整评分分类体系 (taxonomy/voicenet_dimensions.md)
包含全部 57 个维度的英文评分细则与 0-6 等级描述。
数据生成过程
数据集的分批生成为三轮迭代:
- 第 1 轮(196,500 条标注): 从 Emolia 语料库中选取候选片段,利用 VoiceCLAP 零样本相似度将片段按维度等级分桶(0-6),使候选片段分布在评分范围内,再由 Gemini 3.5 Flash 重新评分。
- 第 2 轮(195,995 条标注): 针对第 1 轮中表现最差的 196 个
(维度 x 等级)组合,补充约 1,000 个新的高一致性候选片段,将平均平衡度从 0.533 提升至 0.551。 - 第 3 轮(75,685 条标注): 针对 24 个最难维度的 76 个
(维度 x 等级)组合,使用双 CLAP 一致性候选片段进行针对性补充,将平均平衡度提升至 0.552。两个维度被有意排除:R_MIXD(CLAP 无法解决)和ROUG(候选池已用尽)。 - 生成成本: 总计约 264.77 美元(使用 Gemini 3.5 Flash 批量 API,享受 50% 批量折扣)。
- 解析可靠性: 仅 234 / 468,180 条响应(0.050%)无法解析为整数,这些行的
gemini_score为 null。
维度分类体系
数据集定义了 57 个感知语音/说话维度,分为以下 10 个类别:
- 节奏与时间(8 个):
TEMP语速、CHNK断句、SMTH平滑度、CLRT发音清晰度、RANG音高范围、EMPH强调、DFLU不流畅度、STRU结构 - 社会与人际(3 个):
STNC立场、FOCS专注度、VULN脆弱性 - 说话者身份(3 个):
GEND感知性别、AGEV声音年龄、REGS音域 - 情感与情绪(3 个):
VALN效价、AROU唤醒度、VOLT波动性 - 物理发声(4 个):
RESP呼吸、TENS紧张度、COGL认知负荷、ATCK起音 - 频谱与音色(7 个):
BRGT明亮度、ROUG粗糙度、HARM和谐度、FULL饱满度、WARM温暖度、METL金属质感、ESTH美感 - 时间动态(4 个):
VFLX速度变化、DARC动态弧、ARSH唤醒度变化、VALS效价变化 - 语言与录音(3 个):
RCQL录音质量、BKGN背景噪声、EXPL内容适切性(3 点量表) - 共鸣位置(7 个):
R_CHST胸腔、R_THRT喉部、R_ORAL口腔、R_MASK面罩、R_NASL鼻腔、R_HEAD头部、R_MIXD混合 - 说话风格(15 个):
S_CASU随意、S_CONV对话式、S_FORM正式、S_DRAM戏剧性、S_NARR叙述者、S_NEWS新闻播报、S_TECH教学式、S_AUTH权威、S_PLAY俏皮、S_CART卡通化、S_ASMRASMR、S_WHIS耳语式、S_MONO独白、S_STRY讲故事、S_RANT咆哮式
维度统计示例
- 平衡度最高的维度(分布最均匀):
S_MONO独白风格:平衡度 0.891,7 个等级,6,500 条标注AROU唤醒度:平衡度 0.877,7 个等级,5,500 条标注VALN效价:平衡度 0.856,7 个等级,5,500 条标注
- 平衡度最低的维度(分布最不均匀):
R_MIXD混合共鸣:平衡度 0.030,7 个等级,9,499 条标注R_MASK面罩共鸣:平衡度 0.144,7 个等级,14,500 条标注R_NASL鼻腔共鸣:平衡度 0.152,7 个等级,13,500 条标注
已知局限性
- 模型生成标签: 评分来自 Gemini 3.5 Flash,而非人类标注者。
- 候选选择不均: VoiceCLAP 零样本分桶对宏观维度可靠,但对精细共鸣维度(如
R_MIXD、R_MASK)效果不佳,这些维度约 90-99% 的片段被评在同一等级,不适合作为平衡的 7 级轴。 - 重复项: 122 个
(片段, 维度)对(0.026%)出现在多个轮次中,音频清单按最先轮次去重,但标注文件保留所有轮次。 - 解析失败: 0.05% 的模型响应无法解析为整数。
相关资源
- GitHub 项目与文档: https://github.com/LAION-AI/voicenet
- 在线演示: https://projects.laion.ai/voicenet/
- 完整分类体系文件:
taxonomy/voicenet_dimensions.md - 训练好的预测模型: https://huggingface.co/laion/voicenet-dimension-predictors-commercial
- 来源音频仓库: 第 1 轮:https://huggingface.co/datasets/laion/emolia-thinking-balanced-buckets;第 2 和 3 轮:https://huggingface.co/datasets/VoiceNet/emolia-thinking
引用
bibtex @misc{emolia_voicenet_gemini, title = {Emolia VoiceNet Gemini Annotations}, author = {LAION}, year = {2026}, note = {Gemini 3.5 Flash annotations of Emolia speech over the VoiceNet-Ext 57-dimension taxonomy}, url = {https://huggingface.co/datasets/laion/emolia-voicenet-gemini-annotations} }