dagestan-constitution
收藏资源简介:
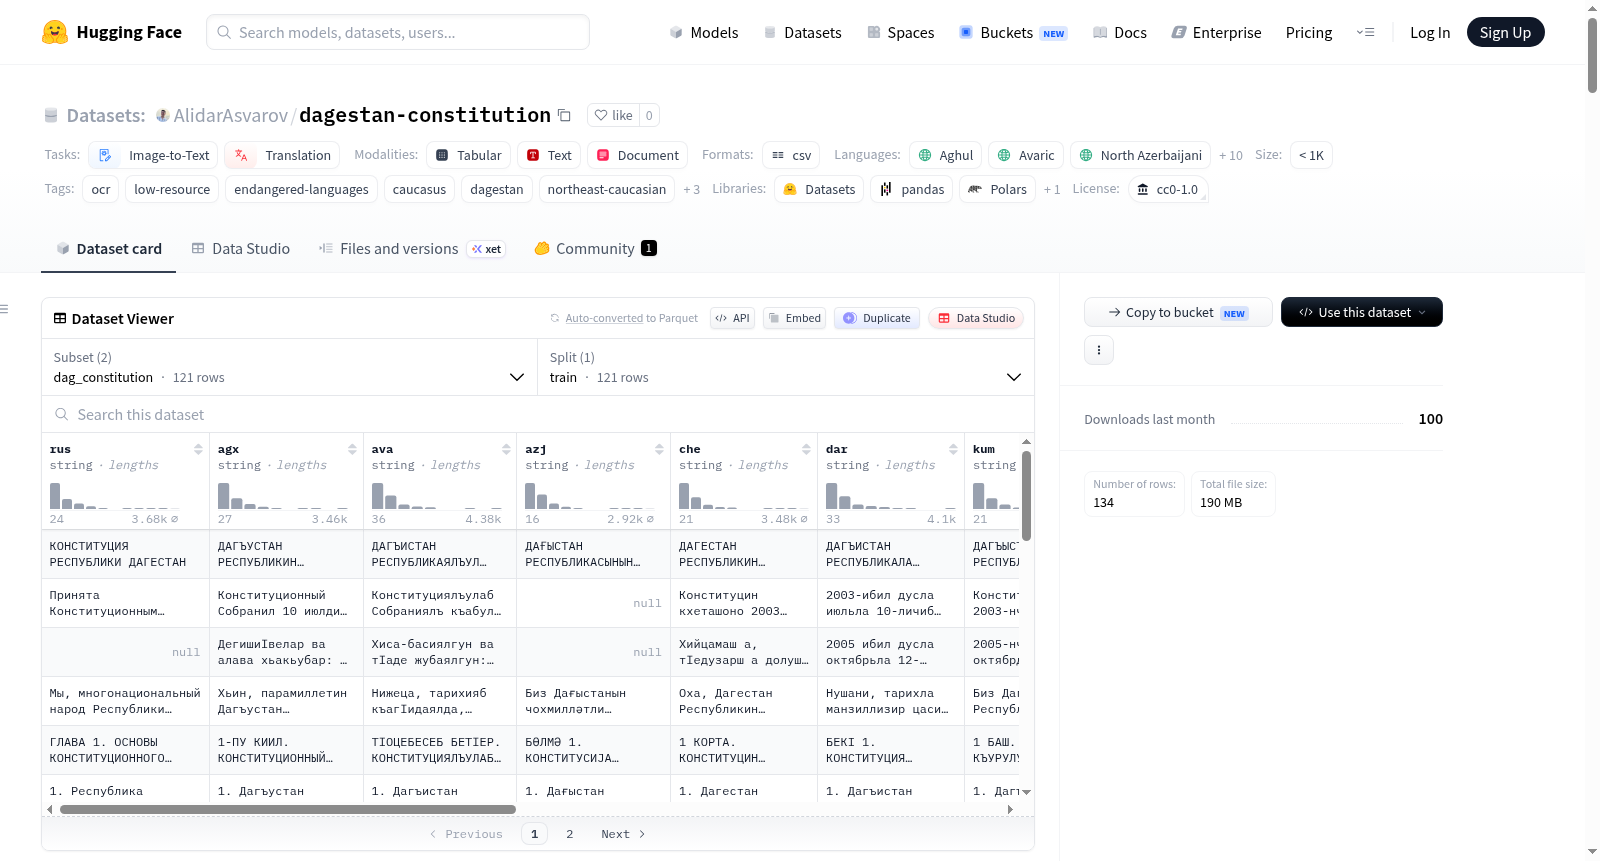
该数据集提供了达吉斯坦共和国宪法的扫描件,构成一个包含13种语言的文档级平行语料库。核心内容包括11种达吉斯坦及北高加索地区的本土语言(如阿古尔语、鲁图尔语、察胡尔语、塔巴萨兰语、拉克语等),以及阿塞拜疆语和俄语。这些语言大多属于高加索语系或突厥语系,使用扩展的西里尔字母书写,且作为低资源或濒危语言,公开可用的机器可读文本及OCR真实数据极为稀缺。数据集包含两个子集:1) `dag_constitution`(默认子集):一个手动在文章级别对齐的文本语料库,以宽表形式组织,包含13列(每列对应一种语言)和121行(对应宪法文档的结构单元,如标题、105个条款等)。每一行中的单元格内容在语义上对应同一宪法条款在不同语言中的表述,因此可直接用于构建任意两种语言之间的平行句对。2) `pdfs`子集:提供了13个PDF扫描文件的元数据(包括语言、语系、页面统计、文件大小)及下载链接。数据规模方面,总计包含13个PDF文件,291个PDF页面。由于大多数PDF页面是包含两本书页的跨页扫描,实际书籍页面数为536页,数据总体积约为177 MB。其中,俄语版本为原生数字PDF文件,可作为OCR评估的参考真实文本;其余12种语言的版本均为扫描图像,并附带了机器生成的OCR文本(未经人工验证,应视为有噪声数据)。该数据集的主要应用场景包括:为使用西里尔字母的少数语言和濒危语言训练和评估OCR模型;利用其文章级别的平行对齐特性,进行机器翻译、跨语言检索等自然语言处理任务的模型开发与研究。对于其中多种语言而言,这是目前极少存在的平行语料资源之一。
This dataset provides scanned copies of the Constitution of the Republic of Dagestan, forming a document-level parallel corpus in 13 languages. The core content includes 11 indigenous languages from Dagestan and the North Caucasus region (such as Agul, Rutul, Tsakhur, Tabasaran, Lak, etc.), as well as Azerbaijani and Russian. Most of these languages belong to the Caucasian or Turkic language families, are written using extended Cyrillic alphabets, and are low-resource or endangered languages, with publicly available machine-readable text and OCR ground truth being extremely scarce. The dataset consists of two subsets: 1) `dag_constitution` (the default subset): a manually aligned text corpus at the article level, organized in a wide-table format with 13 columns (each corresponding to a language) and 121 rows (corresponding to structural units of the constitutional document, such as titles and 105 articles). The content in each rows cells semantically corresponds to the same constitutional provision in different languages, allowing direct construction of parallel sentence pairs between any two languages. 2) `pdfs` subset: provides metadata (including language, language family, page statistics, file size) and download links for 13 scanned PDF files. In terms of data scale, it includes a total of 13 PDF files and 291 PDF pages. Since most PDF pages are scanned spreads containing two book pages, the actual number of book pages is 536, with an overall data volume of approximately 177 MB. Among these, the Russian version is a native digital PDF file, which can serve as reference ground truth for OCR evaluation; the other 12 language versions are scanned images accompanied by machine-generated OCR text (unverified and should be considered noisy data). The main application scenarios of this dataset include: training and evaluating OCR models for minority and endangered languages using Cyrillic alphabets; leveraging its article-level parallel alignment for model development and research in natural language processing tasks such as machine translation and cross-lingual retrieval. For many of these languages, this represents one of the few existing parallel corpus resources.