
mit-movie-trivia
收藏官方服务:
资源简介:
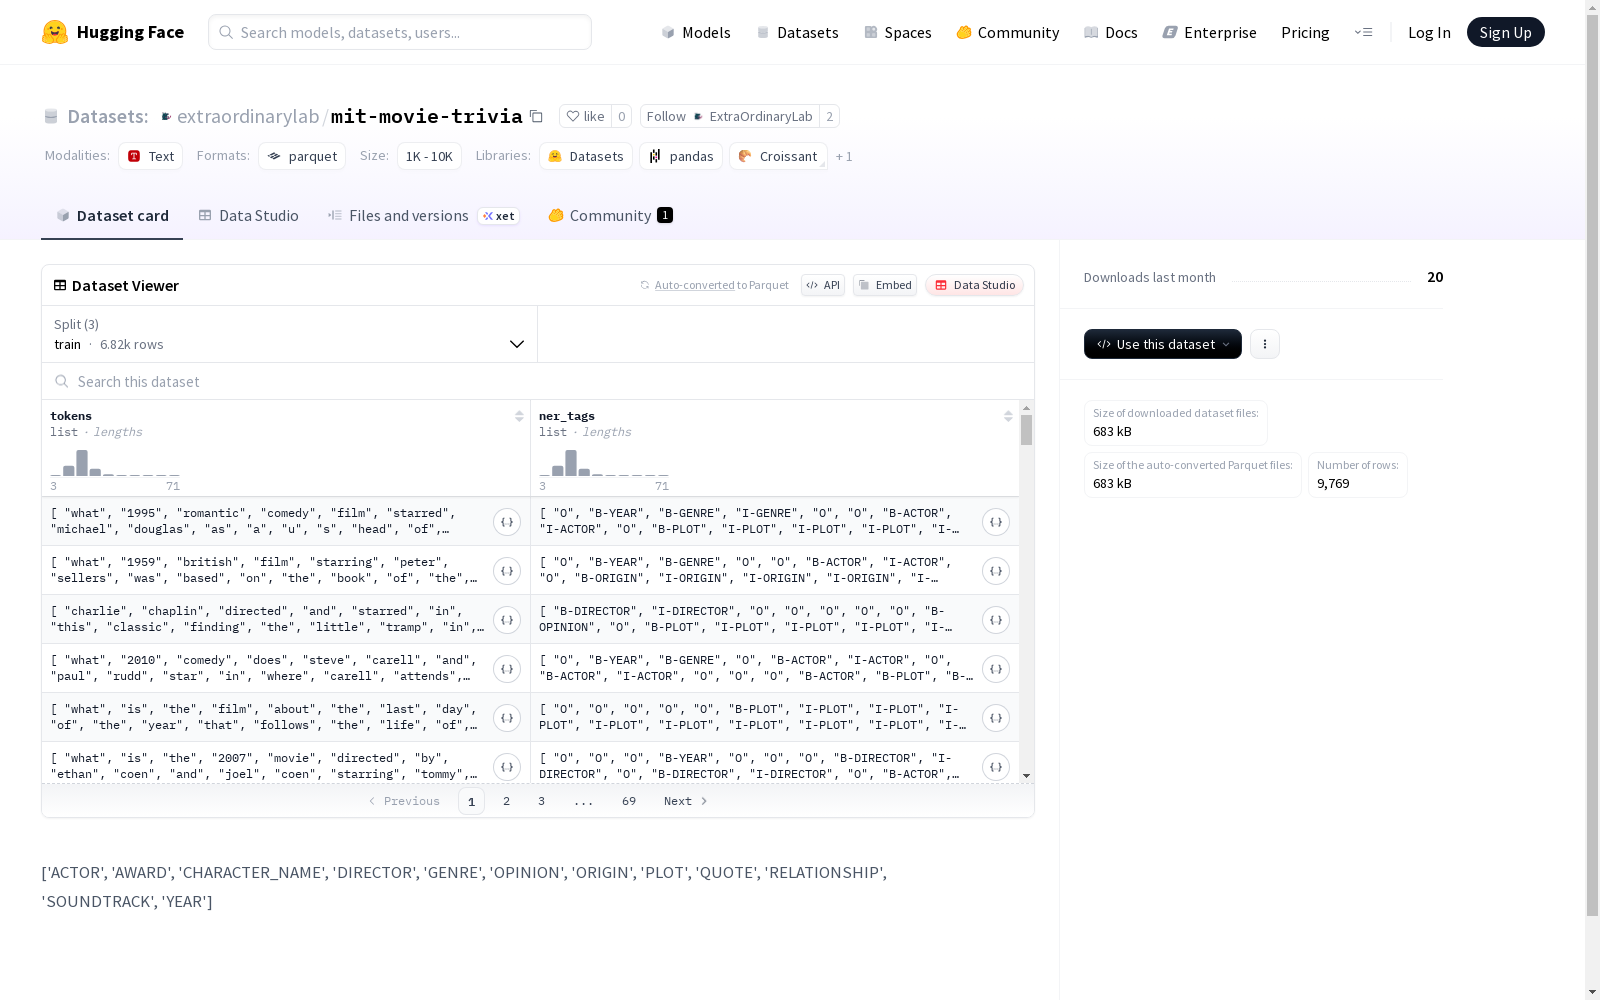
这是一个用于命名实体识别的数据集,包含 tokens 和 ner_tags 两个序列类型的特征。数据集分为训练集、验证集和测试集,共有 6816+1000+1953=9869 个示例。数据集的下载大小为 683252 字节,总大小为 3479818 字节。
创建时间:
2025-10-22
原始信息汇总
数据集概述
基本信息
- 数据集名称: mit-movie-trivia
- 存储位置: https://huggingface.co/datasets/extraordinarylab/mit-movie-trivia
- 下载大小: 683,252 字节
- 数据集大小: 3,479,818 字节
数据结构
特征字段
- tokens: 字符串序列
- ner_tags: 字符串序列
数据划分
| 划分类型 | 样本数量 | 数据大小 |
|---|---|---|
| 训练集 | 6,816 | 2,440,467 字节 |
| 验证集 | 1,000 | 352,741 字节 |
| 测试集 | 1,953 | 686,610 字节 |
命名实体标签
ACTOR、AWARD、CHARACTER_NAME、DIRECTOR、GENRE、OPINION、ORIGIN、PLOT、QUOTE、RELATIONSHIP、SOUNDTRACK、YEAR
搜集汇总
数据集介绍
构建方式
在电影信息抽取领域,MIT-Movie-Trivia数据集通过人工标注方式构建,原始文本来源于电影相关的问答和评论内容。标注过程中采用细粒度实体类型体系,涵盖演员、奖项、角色名称等12个语义类别,训练集、验证集和测试集按约7:1:2比例划分,确保模型训练与评估的科学性。
使用方法
研究者可将其作为序列标注任务的基准数据集,通过加载标准化的训练验证测试分割直接投入模型训练。典型应用包括构建电影领域命名实体识别系统,或作为预训练模型在垂直领域的微调素材。使用时应遵循标准数据处理流程,将词元与标签序列对齐输入模型,并依据官方划分评估性能。
背景与挑战
背景概述
在自然语言处理领域,命名实体识别技术作为信息抽取的关键环节,长期面临着领域适应性不足的难题。MIT-Movie-Trivia数据集由麻省理工学院研究团队于2010年前后构建,聚焦于电影领域的实体标注任务,其核心研究目标在于解决开放域文本中电影相关实体的精准识别与分类问题。该数据集通过标注演员、导演、奖项等十二类实体标签,显著推动了跨领域命名实体识别模型的发展,并为后续影视知识图谱构建提供了重要数据支撑。
当前挑战
该数据集首要挑战在于电影领域实体边界的模糊性,例如角色名称与演员名称的语义重叠,以及电影奖项与普通名词的歧义消解问题。构建过程中面临标注一致性的技术难点,不同标注者对复合型实体(如包含年份的影片名称)的划分标准存在差异。此外,口语化影评文本中存在的非规范表达与拼写变体,进一步增加了实体标注的复杂度和质量控制难度。
常用场景
经典使用场景
在自然语言处理领域,MIT-Movie-Trivia数据集作为命名实体识别任务的经典基准,广泛应用于电影相关文本的实体标注研究。该数据集通过标注电影评论和摘要中的实体类别,如演员、导演、年份等,为模型训练提供了结构化标注数据,支持序列标注算法的性能评估与优化。
解决学术问题
该数据集有效解决了开放域命名实体识别中的领域适应性问题,通过构建电影领域的细粒度实体标注体系,填补了传统通用领域实体识别模型在专业领域性能不足的空白。其标注框架为跨领域实体迁移学习、低资源场景下的语义理解等研究提供了关键数据支撑,推动了信息抽取技术的边界拓展。
实际应用
在实际应用层面,该数据集支撑的实体识别技术已广泛应用于智能影视推荐系统、垂直领域搜索引擎和知识图谱构建。通过精准识别电影文本中的结构化信息,能够增强流媒体平台的内容理解能力,助力个性化推荐算法的精准度提升,并为影视行业的数据智能化管理提供技术基础。
数据集最近研究
最新研究方向
在电影信息抽取领域,mit-movie-trivia数据集凭借其丰富的实体标注类型,已成为命名实体识别和关系抽取研究的重要基准。当前前沿探索聚焦于跨领域迁移学习,利用预训练语言模型提升对电影文本中复杂实体(如角色关系与剧情元素)的泛化识别能力。同时,多模态融合技术正逐步引入,结合视觉与文本数据深化电影知识图谱构建,推动个性化推荐系统和智能影视分析应用的发展。
以上内容由遇见数据集搜集并总结生成


