
HiTZ/elkarhizketak-RAG
收藏官方服务:
资源简介:
该数据集扩展了ElkarHizketak,包含一个基础变体(重写的开头查询、检索所需标签、检索到的文本块)和干扰变体,这些干扰变体注入了对话开头和话题转移,用于评估检索增强生成管道的鲁棒性。
This dataset extends ElkarHizketak with a base variant (rewritten opening queries, retrieval-needed labels, retrieved chunks) and disruptor variants that inject conversational openings and topic shifts, to evaluate robustness of retrieval-augmented generation pipelines.
提供机构:
HiTZ搜集汇总
数据集介绍
构建方式
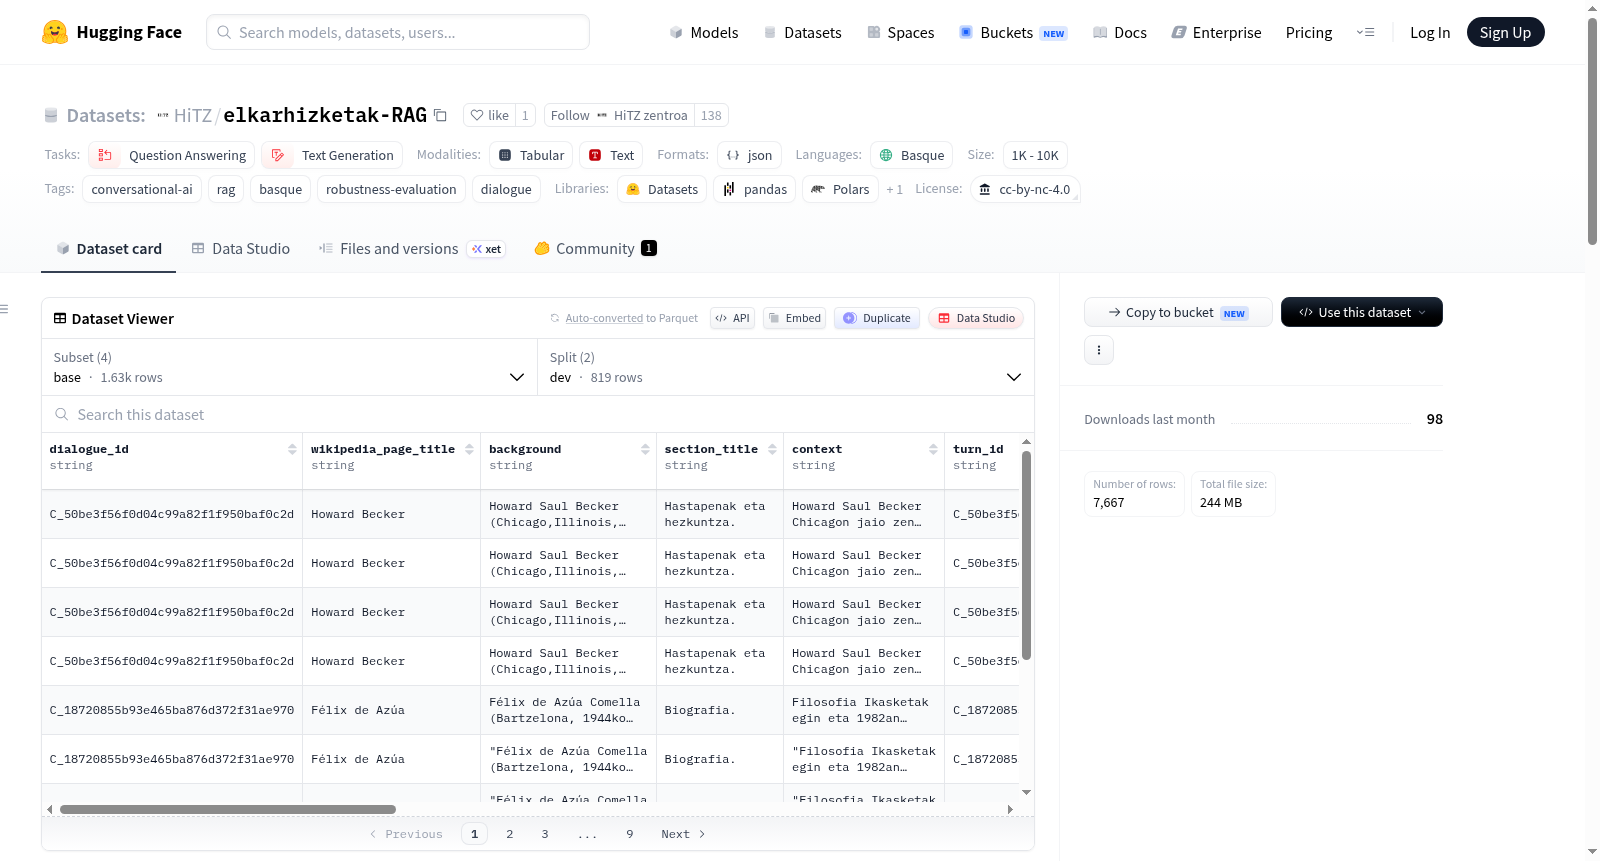
该数据集在原始ElkarHizketak语料库基础上,通过精心设计的扰动策略构建而成。基础版本(base)对起始查询进行了改写,并标注了检索必要性标签及对应的检索文本块。为进一步评估对话式检索增强生成(RAG)系统的鲁棒性,科研人员引入了三种扰动变体:disruptor-1在对话开端插入开场白,disruptor-2a在对话末尾加入话题转移,而disruptor-2b则将话题转移置于对话中间。每种配置均包含dev和test两个数据分片,以jsonl格式存储。
特点
该数据集的核心特色在于其系统化的鲁棒性评估框架,通过模拟真实对话中常见的开场白与话题转移现象,为巴斯克语对话式RAG系统提供了压力测试工具。数据覆盖了从基础查询到复杂对话干扰的多种场景,兼具细粒度的检索必要性标注与检索文本块信息,使其在低资源语言的对话AI研究中具有独特价值。此外,所有数据均遵循CC BY-NC 4.0许可,仅限非商业学术研究使用。
使用方法
使用者可通过Hugging Face Datasets库加载不同配置的数据集,例如在Python中调用`load_dataset('elkarhizketak-RAG', 'base')`获取基础版本,或指定`disruptor-1`等变体名称进行鲁棒性测试。数据字段包含改写后的查询、检索标签及文本块,可直接用于评估模型在巴斯克语对话场景下的检索与生成能力。建议研究者结合原文论文中的评估协议,分别测试模型在基础与扰动变体上的表现,以全面分析系统对对话结构异常的敏感度。
背景与挑战
背景概述
ElkarHizketak-RAG数据集由西班牙巴斯克大学(UPV/EHU)的Ixa Taldea研究团队与HiTZ巴斯克语言技术中心于2026年合作推出,旨在填补低资源语言中对话式检索增强生成(RAG)系统评估的空白。该数据集基于Otegi等人(2020)创建的原始ElkarHizketak语料库,将其改造为包含基础变体与干扰变体的结构化资源,核心研究问题聚焦于对话语境下检索与生成的鲁棒性。作为巴斯克语领域首个系统化测试RAG流程的开源基准,该数据集为低资源语言的自然语言处理研究提供了关键支撑,推动了多轮对话中信息检索与语言生成协同工作的评估范式发展。
当前挑战
所解决的领域问题主要在于低资源语言(如巴斯克语)中对话式RAG系统的鲁棒性评估——传统问答数据集难以模拟真实对话中的开场白与话题转移,导致检索模型在动态交互中频繁失效。构建过程中遇到的挑战包括:需将原始静态问答对话改写为贴合口语习惯的开放查询,并手工标注检索必要性标签;同时设计三类干扰变体(对话开场、结尾话题转移及中段转移),这不仅要求严谨的对话结构重排,还需确保干扰片段与现有上下文的语义连贯性,避免引入人工噪声过强而失去评估价值。
常用场景
经典使用场景
ElkarHizketak-RAG数据集专为巴斯克语环境下检索增强生成(RAG)系统的鲁棒性评估而设计,其经典使用场景聚焦于模拟真实对话中常见的交互模式,如会话开场白与主题转移。研究者可利用该数据集的基准变体与干扰变体,系统性地测试对话式问答系统在信息检索与生成环节的抗干扰能力。通过引入拟人化的对话起手式与话题切换,该数据集为评估RAG管道对上下文漂移的敏感度提供了标准化的压力测试框架,尤其适用于低资源语言场景下的算法性能基准测评。
解决学术问题
该数据集着力解决对话式RAG系统在面对非理想查询条件时的脆弱性问题。在学术研究中,一个核心挑战是如何量化检索模块在对话上下文中遭遇前缀噪声(如寒暄语)或突发主题变迁时的召回准确率下降幅度。ElkarHizketak-RAG通过构造显式的干扰变体,首次为巴斯克语这类低资源语言提供了可控的实验环境,使研究者得以剖析检索-生成联合模型在对话流状态转换下的误差传播机制。其意义在于揭示了现有自反思式RAG框架在应对动态话题演化时存在的结构性盲区,推动多模态交互系统中的鲁棒表示学习理论向更贴近实际对话场景的方向演进。
衍生相关工作
围绕ElkarHizketak-RAG数据集,已衍生出检索增强对话系统鲁棒性评估的相关学术工作。最直接的后续工作是Briones Basauri的硕士论文,该论文基于此数据集系统性地揭示了自反思式RAG模型在巴斯克语对话场景下面对干扰时的性能瓶颈。此外,原始ElkarHizketak数据集的创建者Otegi等人开展的对话问答研究为此提供了理论基座,而后续工作中出现的“检索必要性标签”与“检索块输入”等设计思想,也启发了若干面向低资源语言的动态检索触发机制研究,为设计具备上下文感知能力的轻量化RAG架构提供了规范化评测基准。
以上内容由遇见数据集搜集并总结生成


