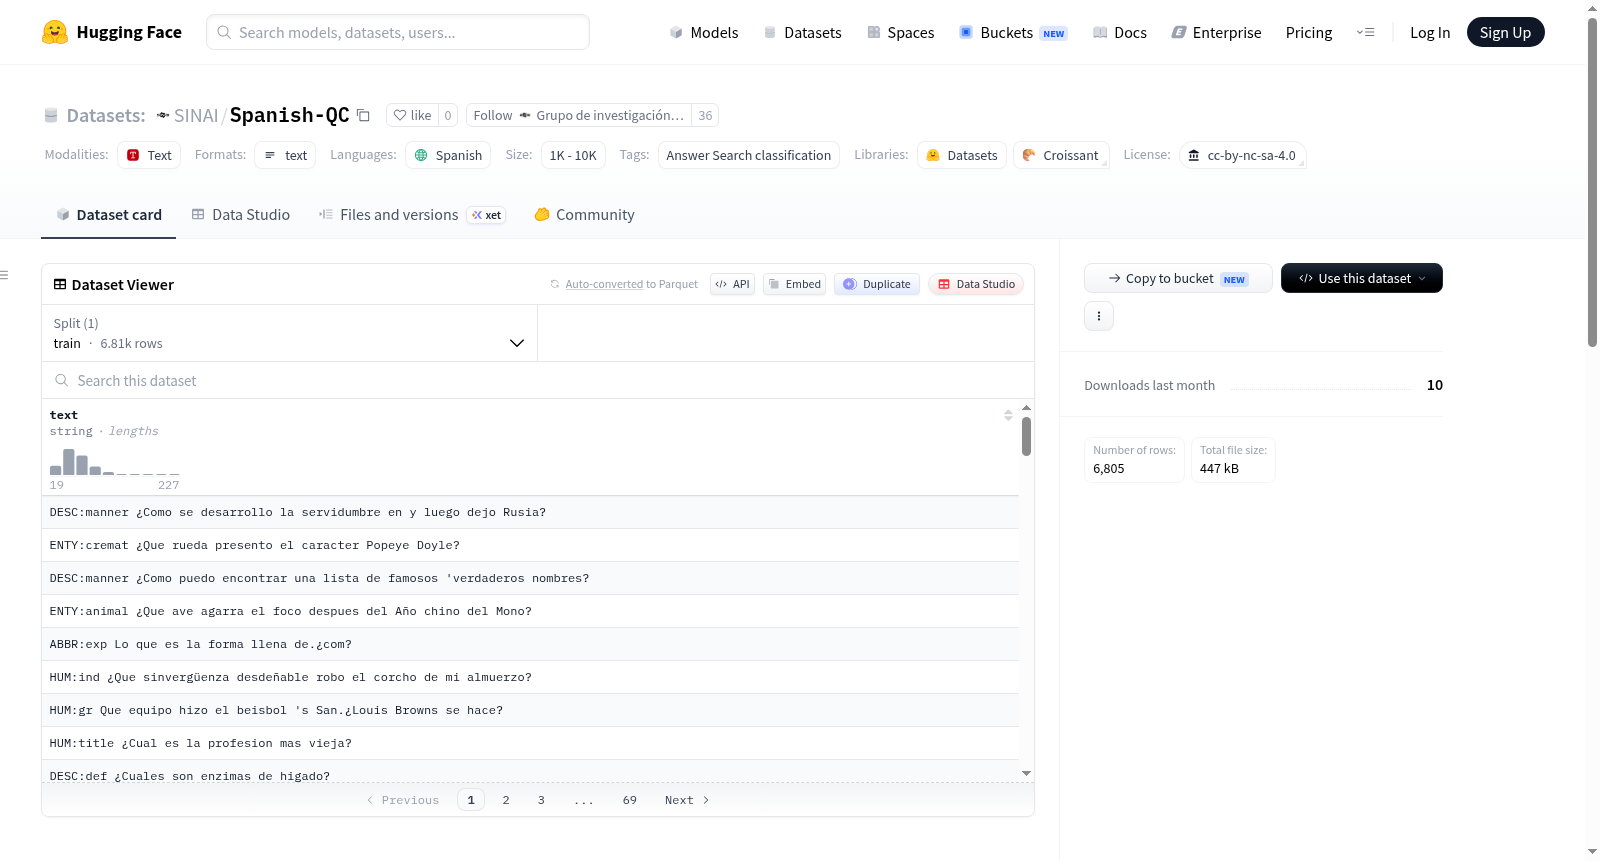
SINAI/Spanish-QC
收藏资源简介:
--- license: cc-by-nc-sa-4.0 language: - es tags: - Answer Search classification pretty_name: Spanish-QC --- ### Dataset Description **Paper**: [BRUJA: Question Classification for Spanish. Using Machine Translation and an English Classifier.](https://aclanthology.org/W06-1906.pdf) **Point of Contact**: magc@ujaen.es This resource is 6305 questions in Spanish labeled for Answer Search classification, following the taxonomy defined in the article "X. Li and D. Roth. Learning Question Classifiers", which has the following general and detailed categories: - ABBR: abbreviation, expansion - DESC: definition, description, mode, motif - ENTY: animal, body, color, creation, currency, disease/medical, event, food, instrument, language, letter, other, plant, product, religion, sport, substance, symbol, technique, term, vehicle, word - HUM: description, group, individual, title - LOC: city, country, mountain, other, state, other, state - NUM: code, count, date, distance, distance, money, order, other, percentage, period, speed, temperature, size, weight Starting from a set of labeled questions for English, this resource has been generated with various questions in Spanish labeled and reviewed by 3 people. ### Acknowledgments This work has been supported by the Spanish Government (MCYT) with grant TIC2003-07158-C04-04. ### Licensing Information Spanish-QC is released under the [Apache-2.0 License](http://www.apache.org/licenses/LICENSE-2.0). ### Citation Information ```bibtex @inproceedings{a-garcia-cumbreras-etal-2006-bruja, title = "{BRUJA}: Question Classification for {S}panish. Using Machine Translationand an {E}nglish Classifier", author = "Garc{\'\i}a Cumbreras, Miguel {\'A}. and Ure{\~n}a L{\'o}pez, L. Alfonso and Mart{\'\i}nez Santiago, Fernando", booktitle = "Proceedings of the Workshop on Multilingual Question Answering - {MLQA} {`}06", year = "2006", url = "https://aclanthology.org/W06-1906", } ```
许可证:知识共享署名-非商业性使用-相同方式共享4.0协议(CC BY-NC-SA 4.0) 语言:西班牙语(es) 标签:答案搜索分类(Answer Search classification) 展示名称:西班牙语问答分类数据集(Spanish-QC) ### 数据集说明 **论文**:[BRUJA:西班牙语问句分类。利用机器翻译与英语分类器(BRUJA: Question Classification for Spanish. Using Machine Translation and an English Classifier)](https://aclanthology.org/W06-1906.pdf) **联系人**:magc@ujaen.es 本数据集包含6305条经标注的西班牙语问句,用于答案搜索分类任务,其分类体系源自论文《X. Li与D. Roth:学习问句分类器》,包含以下一级分类及对应二级分类类别: - ABBR:缩写、扩展 - DESC:定义、描述、方式、缘由 - ENTY:动物、身体部位、颜色、创造物、货币、疾病/医疗、事件、食物、工具、语言、字母、其他、植物、产品、宗教、运动、物质、符号、技术、术语、交通工具、词语 - HUM:人物描述、群体、个体、头衔 - LOC:城市、国家、山脉、其他、州、其他、州 - NUM:代码、数量、日期、距离、距离、金额、序号、其他、百分比、时段、速度、温度、尺寸、重量 本数据集以英语标注问句集为基础,通过人工标注并经3名评审人员审核后生成。 ### 致谢 本研究获得西班牙政府(MCYT)资助,资助编号为TIC2003-07158-C04-04。 ### 许可信息 西班牙语问答分类数据集(Spanish-QC)采用Apache-2.0许可证(Apache-2.0 License)发布,详情见:http://www.apache.org/licenses/LICENSE-2.0 ### 引用信息 bibtex @inproceedings{a-garcia-cumbreras-etal-2006-bruja, title = "{BRUJA}:西班牙语问句分类。利用机器翻译与英语分类器", author = "García Cumbreras, Miguel Á. and Ureña López, L. Alfonso and Martínez Santiago, Fernando", booktitle = "Proceedings of the Workshop on Multilingual Question Answering - {MLQA} `06", year = "2006", url = "https://aclanthology.org/W06-1906", }
数据集描述
论文: BRUJA: Question Classification for Spanish. Using Machine Translation and an English Classifier.
联系人: magc@ujaen.es
该资源包含6305个西班牙语问题,用于答案搜索分类,遵循文章“X. Li and D. Roth. Learning Question Classifiers”中定义的分类法,包括以下一般和详细类别:
- ABBR: 缩写, 扩展
- DESC: 定义, 描述, 模式, 主题
- ENTY: 动物, 身体, 颜色, 创造, 货币, 疾病/医疗, 事件, 食物, 乐器, 语言, 字母, 其他, 植物, 产品, 宗教, 体育, 物质, 符号, 技术, 术语, 交通工具, 单词
- HUM: 描述, 团体, 个人, 头衔
- LOC: 城市, 国家, 山脉, 其他, 州, 其他, 州
- NUM: 代码, 计数, 日期, 距离, 距离, 金钱, 顺序, 其他, 百分比, 时期, 速度, 温度, 大小, 重量
该资源从一组标记的英语问题开始,生成了多种西班牙语标记问题,并由3人进行了审查。
致谢
该工作得到了西班牙政府(MCYT)的资助,授予TIC2003-07158-C04-04。
许可信息
Spanish-QC 在 Apache-2.0 License 下发布。
引用信息
bibtex @inproceedings{a-garcia-cumbreras-etal-2006-bruja, title = "{BRUJA}: Question Classification for {S}panish. Using Machine Translationand an {E}nglish Classifier", author = "Garc{\i}a Cumbreras, Miguel {A}. and Ure{~n}a L{o}pez, L. Alfonso and Mart{\i}nez Santiago, Fernando", booktitle = "Proceedings of the Workshop on Multilingual Question Answering - {MLQA} {`}06", year = "2006", url = "https://aclanthology.org/W06-1906", }