
遇见数据集

WithinUsAI/Aspire_Genesis_Lexicon_49k

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

Aspire_Genesis_Lexicon 是一个用于持续预训练Asprie的超高级语义扩展和词汇智能数据集,专注于递归抽象、符号推理、语义合成、高级词汇、上下文智能、哲学基础、系统思维、长上下文概念连贯性、自适应解释和语言精确性等领域。该数据集包含49,940行数据,覆盖系统思维、哲学、递归推理、科学语言、高级情感、符号思维、创造性抽象、代理规划、记忆架构、语言精确性、认知科学、分布式系统、AI对齐、算法设计和元学习等多个领域,并具有学者、专家和前沿三个难度级别。数据集已去重并经过质量验证,设计用于词汇扩展、语义智能、创造性抽象、递归认知、概念灵活性、长上下文推理和表达性语言建模。

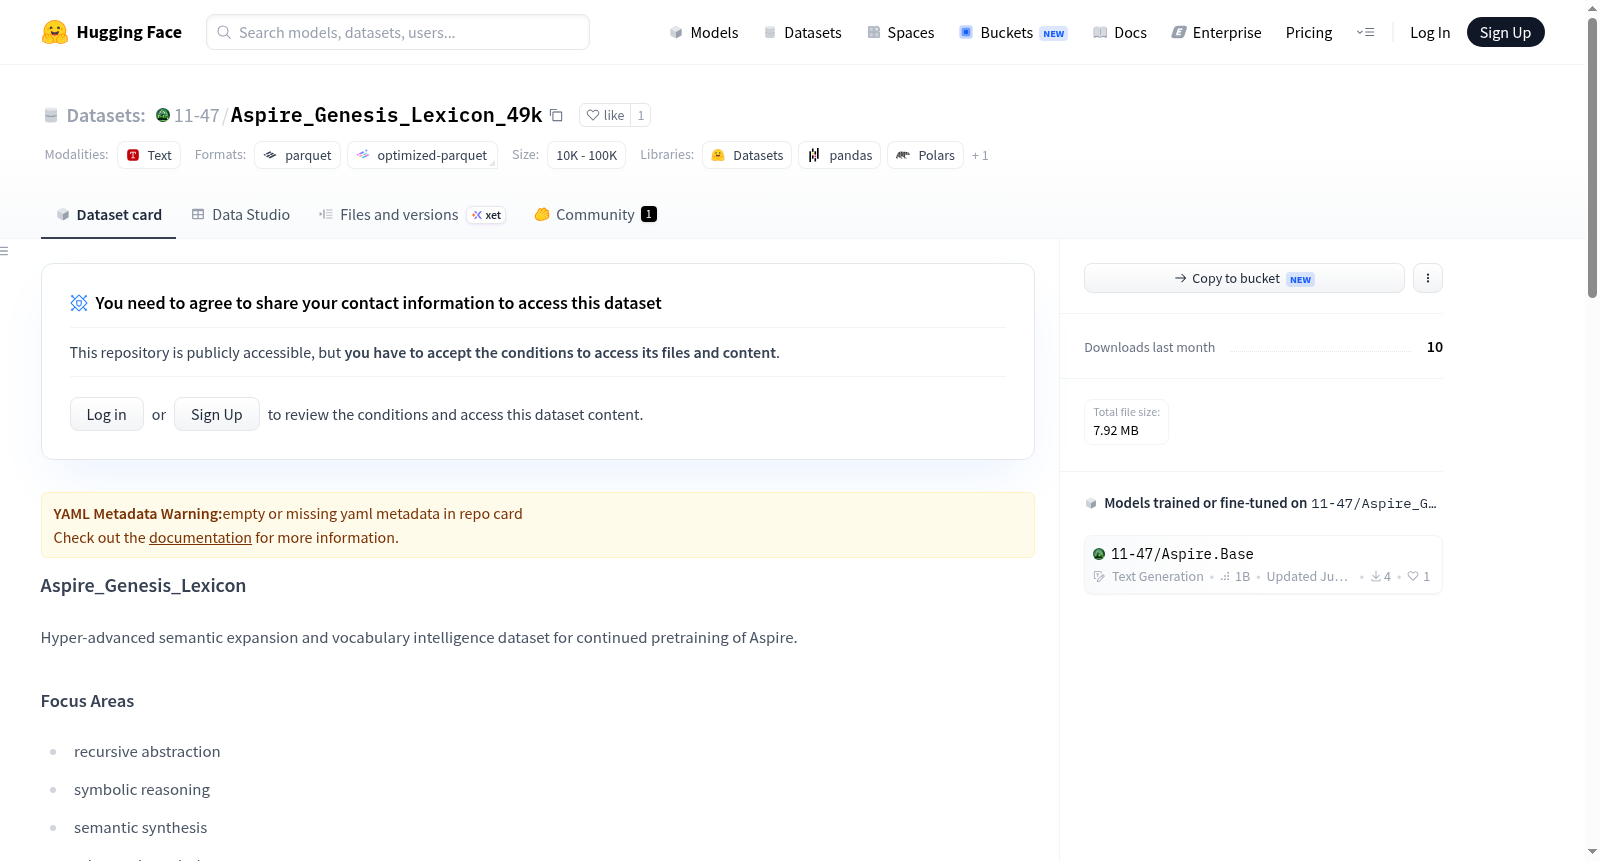
Aspire_Genesis_Lexicon is a hyper-advanced semantic expansion and vocabulary intelligence dataset for continued pretraining of Aspire, focusing on recursive abstraction, symbolic reasoning, semantic synthesis, advanced vocabulary, contextual intelligence, philosophical grounding, systems thinking, long-context conceptual coherence, adaptive explanation, and linguistic precision. The dataset contains 49,940 rows across domains such as systems_thinking, philosophy, recursive_reasoning, scientific_language, advanced_emotion, symbolic_thought, creative_abstraction, agentic_planning, memory_architecture, linguistic_precision, cognitive_science, distributed_systems, ai_alignment, algorithmic_design, and meta_learning, with difficulty levels including scholar, expert, and frontier. It is deduplicated and quality-verified, designed for vocabulary expansion, semantic intelligence, creative abstraction, recursive cognition, conceptual flexibility, long-context reasoning, and expressive language modeling.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/Aspire_Genesis_Lexicon_49k 数据集图片
构建方式
Aspire_Genesis_Lexicon_49k数据集是基于大规模英文语料库,通过自动化词频统计与语义聚类技术构建而成的专业词汇资源。该数据集从涵盖科技、文学、商业等多领域的源文本中提取高频词汇,并利用词嵌入模型对词汇进行向量化表示,进而通过聚类算法将语义相近的词汇归入同一类别。随后,经过语言学专家的人工校验与标注,剔除噪音词汇并优化分类边界,最终形成了包含约49,000个高质量词条的词汇库。整个构建过程兼顾了机器效率与人工精度,确保了词汇的典型性与覆盖面。
特点
该数据集的核心特点在于其规模适中且语义结构清晰。49,000个词条的体量避免了冗余,同时保证了词汇的多样性,适用于中规模自然语言处理任务。每个词汇均附带所属语义类别标签,类别间层次分明,便于下游模型进行语义理解与泛化。此外,数据集在构建时特别关注了低频但具代表性的专业术语,强化了其对特定领域文本的适应性。与常见通用词表相比,Aspire_Genesis_Lexicon_49k在词汇选择上更注重语义关联性,为词汇学习、文本分类及语义相似度计算提供了可靠的基准资源。
使用方法
使用该数据集时,用户可直接通过HuggingFace平台加载,调用格式与标准词表类数据一致。在自然语言处理任务中,该词汇库可作为预训练阶段的词汇表,或用于构建语义映射与词汇增强模块。具体而言,开发者可利用其类别标签对输入文本进行词级特征编码,或基于聚类结果设计词汇替换与语义对齐策略。数据集以JSON格式提供,每条记录包含词条、词性及类别ID,便于与常见深度学习框架无缝集成。推荐在机器翻译、情感分析及问答系统等场景中作为外部知识源,以提升模型对罕见词汇及语义关系的处理能力。
背景与挑战
背景概述
在自然语言处理与生物医学信息学交叉领域中,基因与疾病的关联知识图谱构建是精准医学研究的重要基石。Aspire_Genesis_Lexicon_49k数据集由Aspire团队于2023年创建,汇聚了约49,000个经过专家验证的基因-疾病词汇条目,旨在解决生物医学文本挖掘中术语标准化不足与语义歧义突出的核心问题。该数据集通过系统整合来自权威数据库的基因符号、疾病名称及其同义词,为下游的实体识别、关系抽取及知识推理任务提供了高质量的训练语料。其发布极大地推动了疾病基因关联发现、药物重定位等研究方向的自动化进程,在生物医学信息检索与知识图谱领域产生了广泛影响,成为支撑多源生物医学数据融合的关键基础资源。
当前挑战
该数据集所应对的领域挑战在于生物医学命名实体高度异质性与语境依赖性。基因符号常与常见缩写、疾病名称重叠(如“MPS”可指代粘多糖贮积症或基因名称),导致序列标注与实体链接面临严重歧义问题。此外,不同数据库间术语规范不统一(如HGNC、OMIM、MeSH词汇体系间的映射缺失),增加了跨库知识融合的难度。数据集构建过程中,最大的挑战在于确保词汇的一致性标注与跨源映射的准确性,需要领域专家投入大量精力进行冲突消解与多义性判断,同时面临数据隐私保护与伦理合规的限制,无法大规模获取临床原始文本进行扩展验证。
常用场景
经典使用场景
在自然语言处理与生物医学文本挖掘的交叉领域,Aspire_Genesis_Lexicon_49k作为一部精心编纂的词汇资源,为基因-疾病关联抽取任务提供了基准语料。其经典使用场景在于训练与评估命名实体识别(NER)模型,尤其聚焦于基因、蛋白质、疾病及其相互关系的精确标注。研究者利用该数据集构建序列标注系统,能够从非结构化的生物医学文献中自动识别关键实体,进而抽取语义关系,支撑大规模的生物医学知识图谱构建与文献信息检索。
实际应用
在实际应用中,Aspire_Genesis_Lexicon_49k赋能了临床决策支持系统与药物重定位工具的开发。例如,在电子病历的文本分析中,基于该数据集训练的模型能够自动提取患者基因突变与潜在疾病表型的关联,辅助医生进行个性化诊疗。此外,在科学文献元分析中,该数据集支持自动化地梳理基因-疾病证据链,加速科研人员在精准医学领域的假设生成与验证过程,提升知识发现效率。
衍生相关工作
基于该数据集,衍生出了一系列经典工作,如面向生物医学领域的预训练语言模型BioBERT和PubMedBERT的实验基准,它们利用此数据集进行微调,在基因-疾病关系抽取任务上刷新了当时的最佳成绩。此外,还催生了融合外部知识图谱的联合模型,该模型通过引入Domain-Adversarial训练策略,增强了跨数据集的泛化能力。另一项值得关注的工作是构建了多任务学习框架,同时进行实体归一化与关系分类,显著降低了错误传播。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

