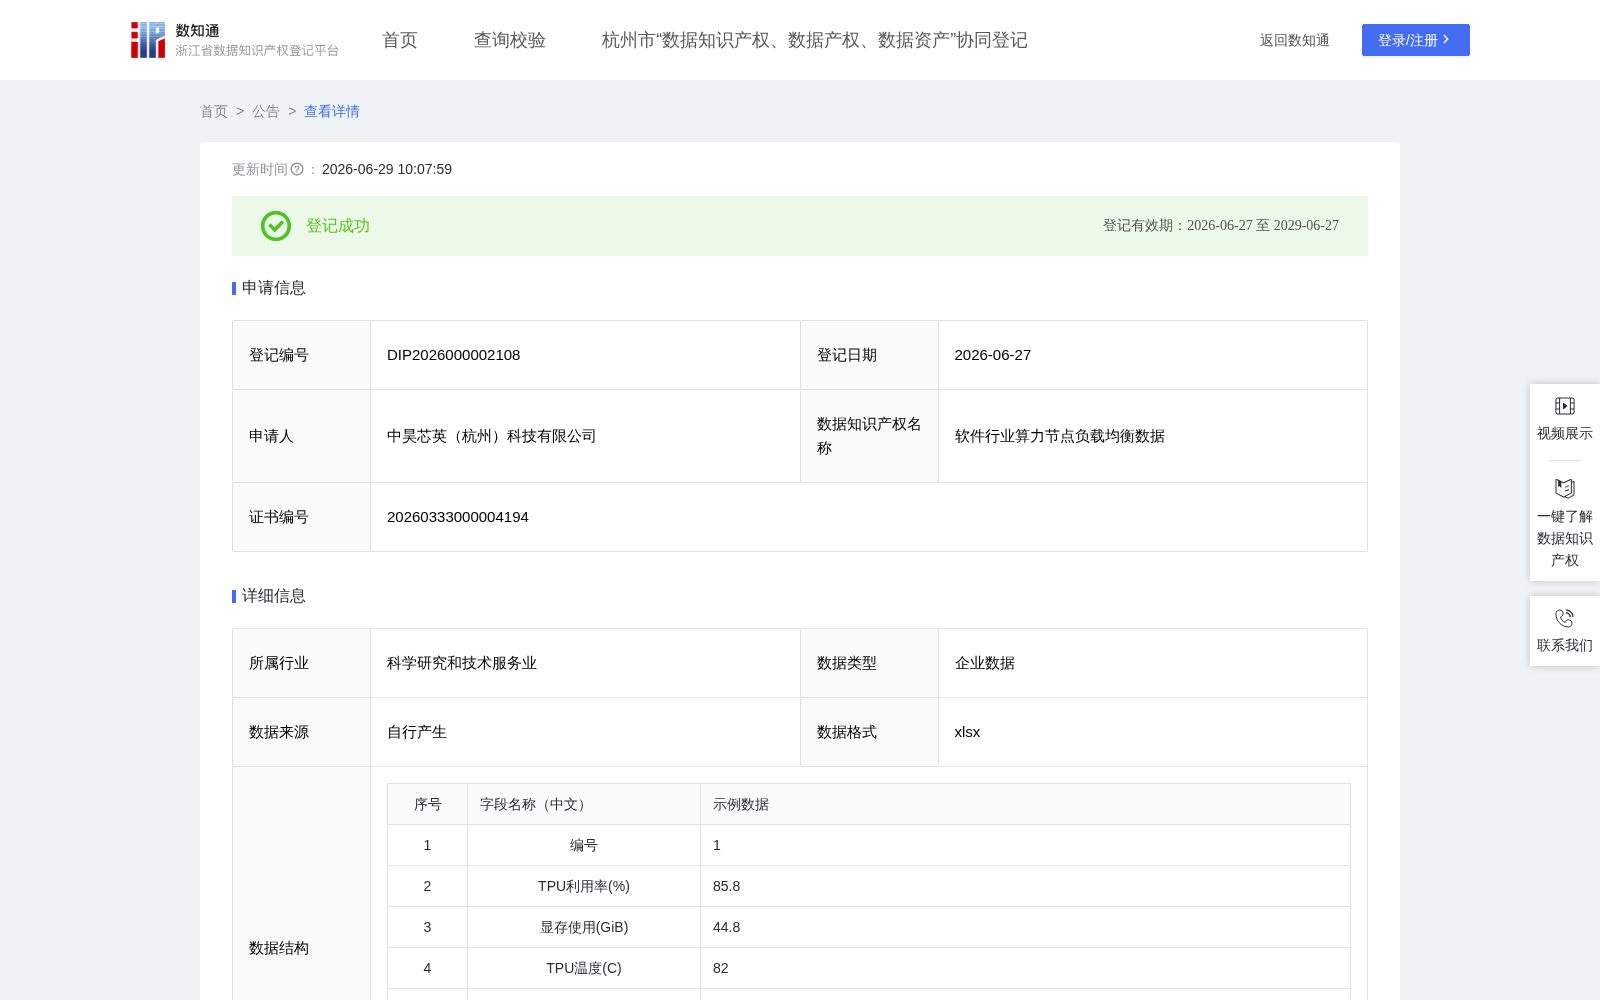
软件行业算力节点负载均衡数据
收藏资源简介:
本数据可用于AI算力集群管理平台,通过实时分析各节点负载数据动态调整任务分配策略,优化资源利用率并避免单点过载;为云服务商提供节点健康度评估服务,支持通过可视化看板实时监控各区域算力负载分布,辅助客户选择最优资源部署方案;推动建立跨平台的算力资源调度标准,提升行业整体计算资源利用效率。一、加工前的数据说明 原始数据为分布式TPU集群在深度学习推理服务场景下产生的运营监测数据,包含12个特征字段:唯一标识编号、TPU利用率(%)、显存使用量(GiB)、TPU工作温度(℃)、TPU实时功率(W)、首token延迟(ms)、每token延迟(ms)、系统吞吐量(tokens/s)、请求队列长度、显存带宽利用率(%)、算力节点负载均衡度_评分、算力节点负载均衡度。 二、处理规则 数据清洗:对原始数据进行去重、剔除超出物理阈值的异常值,并对缺失值采用剔除方式处理,确保数据完整性与有效性。 评分算法:基于“TPU利用率”与70%的偏离程度(越接近70%得分越高,权重0.35)、“显存使用”反向计分(权重0.25)、“请求排队长度”反向计分(权重0.25)与“吞吐量”正向计分(权重0.15),采用加权求和方式计算综合评分。具体计算公式如下: 算力节点负载均衡度评分=0.35×(1-|TPU利用率-70%|/70%)+0.25×(1-显存使用归一化值)+0.25×(1-请求排队长度归一化值)+0.15×吞吐量归一化值。其中:TPU利用率以70%为最优基准点,得分为 1 - |利用率 - 70%| / 70%,即利用率每偏离1个百分点,扣减约1.4286%的得分。当得分出现负值时,取max(0, 得分)确保得分非负。显存使用与请求排队长度:采用极值归一化后反向计分,使用量/排队长度越小得分越高。吞吐量:采用极值归一化正向计分,吞吐量越高得分越高。各项指标归一化均基于全数据集的最大最小值进行,最终评分映射至0~100区间。 等级划分: 均衡:评分≥75;轻度失衡:45≤评分<75;严重失衡:评分<45。 三、数据内容描述 清洗后的数据集共1001条记录,每条记录包含12个字段,涵盖TPU硬件运行指标(利用率、温度、功率等)、显存资源使用情况(使用量、带宽利用率)及推理效率指标(延迟、吞吐量)。该数据集适用于云计算资源调度优化、AI推理加速策略评估、分布式算力节点负载均衡算法研发等场景。