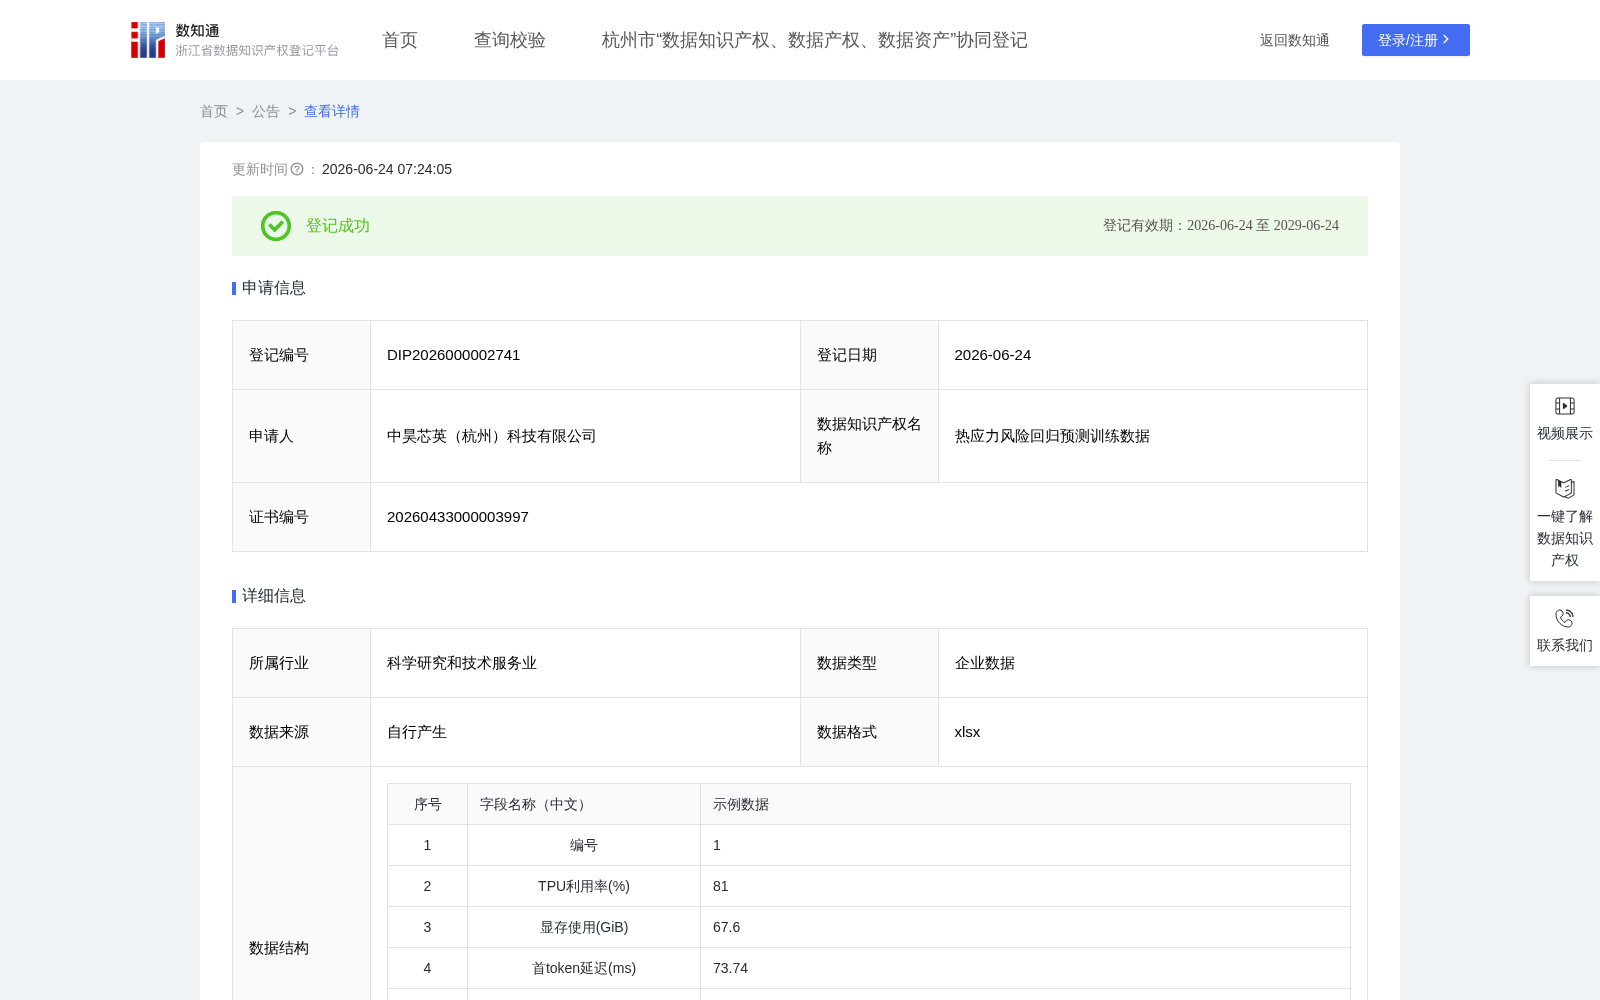
热应力风险回归预测训练数据
收藏资源简介:
本数据集包含数千条TPU运行监控数据,经清洗及特征工程,以热应力指数作为连续回归预测目标。该指数综合了芯片温度与功耗的耦合效应,能够更全面地反映硬件热负荷风险。数据按8:1:1划分为训练集、验证集和测试集,可直接用于回归模型训练。对外部企业而言,本数据可用于训练TPU热应力预测模型,帮助云服务商、AI算力中心根据当前负载特征(利用率、延迟、吞吐、排队等)预估芯片承受的热应力水平,从而提前采取降频、负载迁移或增强散热措施,避免长期高热应力导致芯片老化加速或突发故障。此外,本数据集可作为硬件寿命预测、预防性维护等系统的训练基础。本数据集具有独立性:通过自主构造热应力指数作为预测目标,该指数并非任何单一原始字段的直接复制或简单阈值判断,而是基于温度和功率的耦合计算得出,具有明确的物理意义和独创性。必要性:原始数据仅提供独立的温度和功率值,缺乏综合性的热应力指标;企业自行构造该指标需要额外的领域知识和计算验证,本数据集直接提供标准化、经过验证的热应力指数训练数据,是TPU热管理预测任务的基础。1.加工前的数据说明 原始数据为TPU推理任务性能监控日志,以表格形式存储,每行代表一个采样时刻,按时间顺序编号。总样本量达数千行,所有字段均为数值型且无缺失值。原始数据包含TPU利用率(%)、显存使用(GiB)、TPU温度(℃)、TPU功率(W)、首token延迟(ms)、每token延迟(ms)、吞吐量(tokens/s)、请求排队长度、显存带宽利用率(%)共9个字段。 2.处理规则 首先,对原始数据进行质量检查,剔除温度超出物理合理范围(>100℃或<0℃)、功率为负或零等异常记录。其次,基于温度和功率两个字段,通过特定的数学运算生成热应力指数。该指数的设计原则是:温度与功率越高,热应力指数越大,且二者具有协同放大效应(即高温高功率同时出现时指数显著上升)。具体运算规则为:热应力指数=(温度×功率)/1000。保留热应力指数作为预测目标。之后,将处理后的数据按8:1:1比例随机划分为训练集、验证集和测试集。基于随机森林回归算法构建热应力指数预测模型,以TPU利用率、显存使用、首token延迟、每token延迟、吞吐量、请求排队长度、显存带宽利用率共7个自变量为输入,热应力指数为输出。通过网格搜索优化超参数,特征重要性分析表明利用率和吞吐量是影响热应力指数的关键因素。模型在测试集上达到良好的预测精度(R²>0.85),验证了本数据集的有效性。 3.数据内容描述 最终产出数据集包含7个自变量(TPU利用率、显存使用、首token延迟、每token延迟、吞吐量、请求排队长度、显存带宽利用率),1个因变量(热应力指数,连续数值)。该数据集结构清晰、指标完整,可直接用于训练热应力风险回归预测模型。