
LHUThacSi/ViSportSent
收藏官方服务:
资源简介:
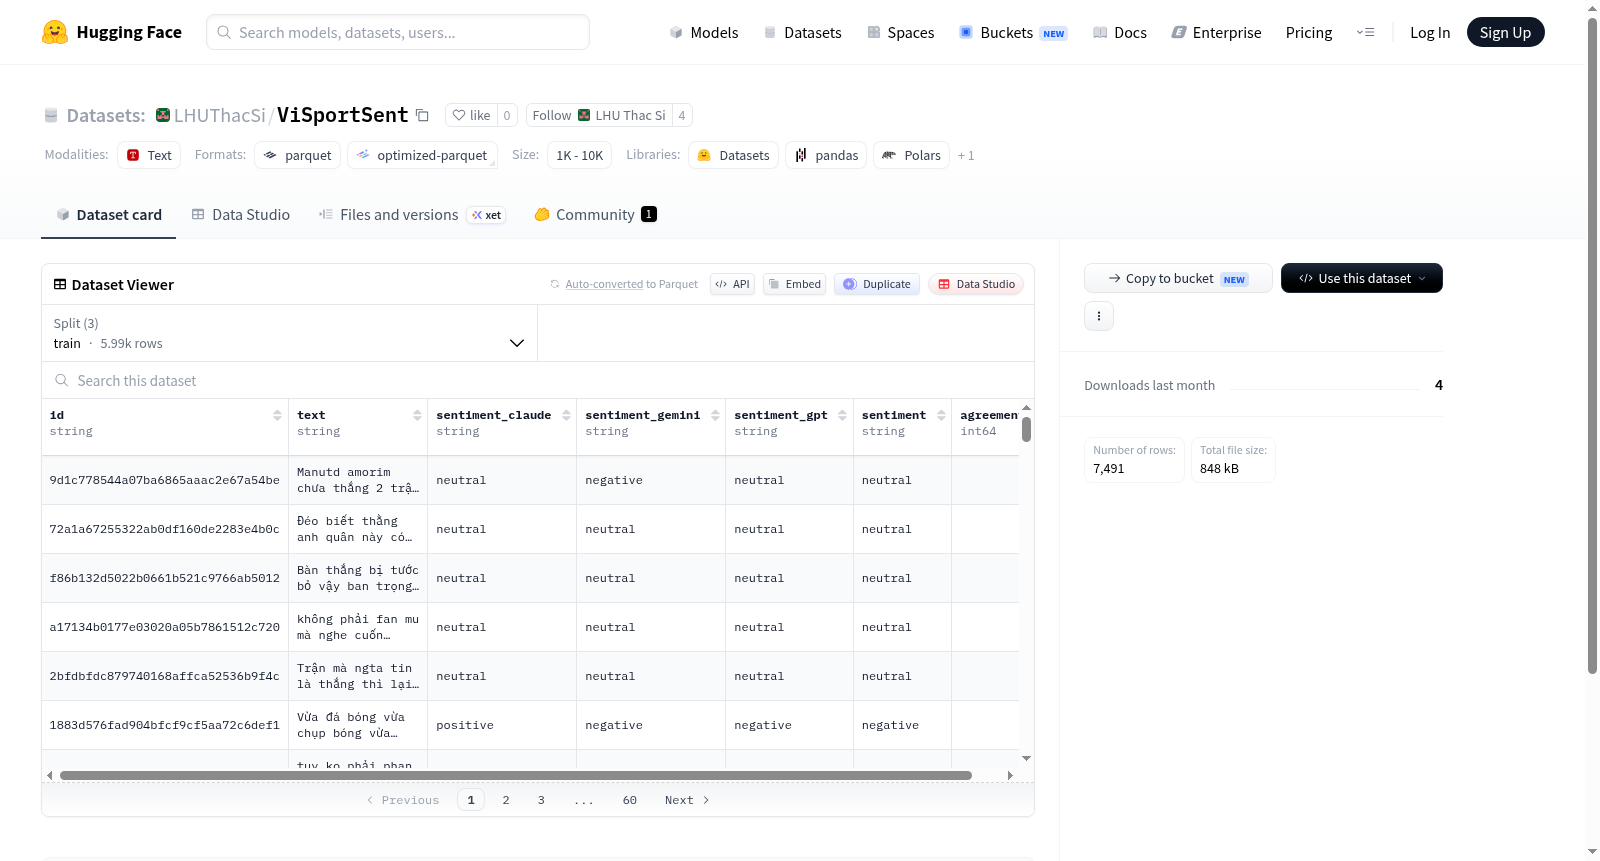
这是一个情感分析数据集,包含文本数据以及由多个模型(如Claude、Gemini、GPT)生成的情感标注,同时提供最终情感标签和标注一致性分数。数据集分为训练集、验证集和测试集,总样本量约7491条,用于情感分析任务的模型训练和评估。
This is a sentiment analysis dataset containing text data and sentiment annotations generated by multiple models (such as Claude, Gemini, GPT), along with final sentiment labels and agreement scores. The dataset is divided into training, validation, and test sets, with a total of approximately 7491 samples, intended for model training and evaluation in sentiment analysis tasks.
提供机构:
LHUThacSi搜集汇总
数据集介绍
构建方式
ViSportSent数据集专为越南语体育文本的情感分析任务而构建。该数据集通过收集与体育领域相关的越南语文本数据,并采用多模型标注策略,分别使用Claude、Gemini和GPT三种大语言模型对每条文本进行情感标注,最终综合各模型输出结果确定最终情感标签,同时引入一致性分数(agreement)以反映模型间标注的可靠程度。数据集划分为训练集(5993条)、验证集(749条)和测试集(749条),结构清晰,便于模型训练与评估。
使用方法
ViSportSent数据集可直接用于越南语体育文本的情感分类模型训练与评估。用户可通过HuggingFace Datasets库加载数据,并利用预定义的train、validation和test划分进行实验。数据集提供的情感标签可用于监督学习,而一致性分数则可作为样本权重或置信度筛选的依据。研究人员亦可探索多模型标注融合策略的优化,或对比单一模型与多模型集成在情感分析任务上的性能差异。
背景与挑战
背景概述
ViSportSent数据集由越南研究团队于近期创建,旨在填补越南语体育文本情感分析领域的资源空白。该数据集聚焦于体育新闻、评论等短文本的情感极性分类,核心研究问题在于应对越南语复杂的语言结构(如缺乏空格分隔、方言差异)在情感分析中带来的挑战。通过整合Claude、Gemini、GPT等模型的多重标注与一致性验证,ViSportSent为低资源语言的体育领域情感分析提供了高质量基准,推动了自然语言处理技术在特定领域与语言变体中的深入应用,对越南语情感分析研究具有奠基意义。
当前挑战
该数据集面临的核心挑战在于解决越南语体育文本情感分析中的领域特异性问题,包括体育评论中频繁出现的专业术语、缩略语和隐喻表达,这些特征导致通用情感模型准确性不足。构建过程中,多重标注(来自Claude、Gemini、GPT)的一致性融合成为主要难点,需通过投票或元学习机制协调不同模型间的分歧以生成可靠标签。此外,数据规模有限(约7500条样本)可能限制深度学习模型的泛化能力,而体育事件的时间敏感性也要求数据集持续更新以保持时效性。
常用场景
经典使用场景
ViSportSent数据集是面向越南语体育新闻评论的情感分析基准资源,其核心应用场景在于训练和评估多源情感分类模型。该数据集通过整合Claude、Gemini、GPT等多个人工智能模型的标注结果,并引入一致性评分机制,为研究者提供了一个兼具多元标注视角与质量控制的语料库。在自然语言处理领域,它常被用于构建针对越南语短文本的细粒度情感识别系统,特别适合处理体育赛事场景下用户评论中蕴含的复杂情感倾向,如赛果喜悦、失利沮丧或战术争议等。
解决学术问题
该数据集精准解决了越南语情感分析中标注一致性不足与跨模型可靠性验证这两项学术难题。通过比较不同大型语言模型在体育评论上的情感判断差异,研究者得以量化评估各标注源的系统性偏差,进而探索集成标注策略以提升标签准确性。此外,ViSportSent为低资源语言的情感分析研究提供了宝贵的验证平台,推动了东南亚语言自然语言处理中关于标注噪声过滤、跨模型标注融合方法以及语料库规模与模型泛化能力关系等关键问题的深入探讨,对完善多语言情感分析理论体系具有显著意义。
实际应用
在实际应用中,ViSportSent数据集直接服务于越南主流体育媒体平台与社交媒体分析系统。基于该数据集训练的情感分析模型能够实时监测体育赛事期间的用户舆论动态,例如自动识别新闻报道评论区中的正面鼓励、负面批评或中立客观内容,帮助平台运营方快速把握公众情绪走向。同时,该数据也为体育品牌营销效果评估、运动员公众形象监测以及赛事转播方内容推荐系统提供了技术支撑,使得基于越南语用户情感反馈的商业决策更加科学化与精准化。
数据集最近研究
最新研究方向
ViSportSent数据集聚焦于越南语体育文本的情感分析,其独特之处在于融合了Claude、Gemini和GPT等多模型标注结果,并引入标注一致性指标。当前前沿研究方向包括探索多模型集成策略以提升情感预测鲁棒性,以及利用该数据集推动低资源语言在特定领域(如体育赛事评论)的情感识别研究,尤其在越南语NLP技术快速发展的背景下,该数据集为跨模型对齐和标注质量评估提供了宝贵基准,对理解体育社群情感动态和舆情监控具有重要影响。
以上内容由遇见数据集搜集并总结生成


