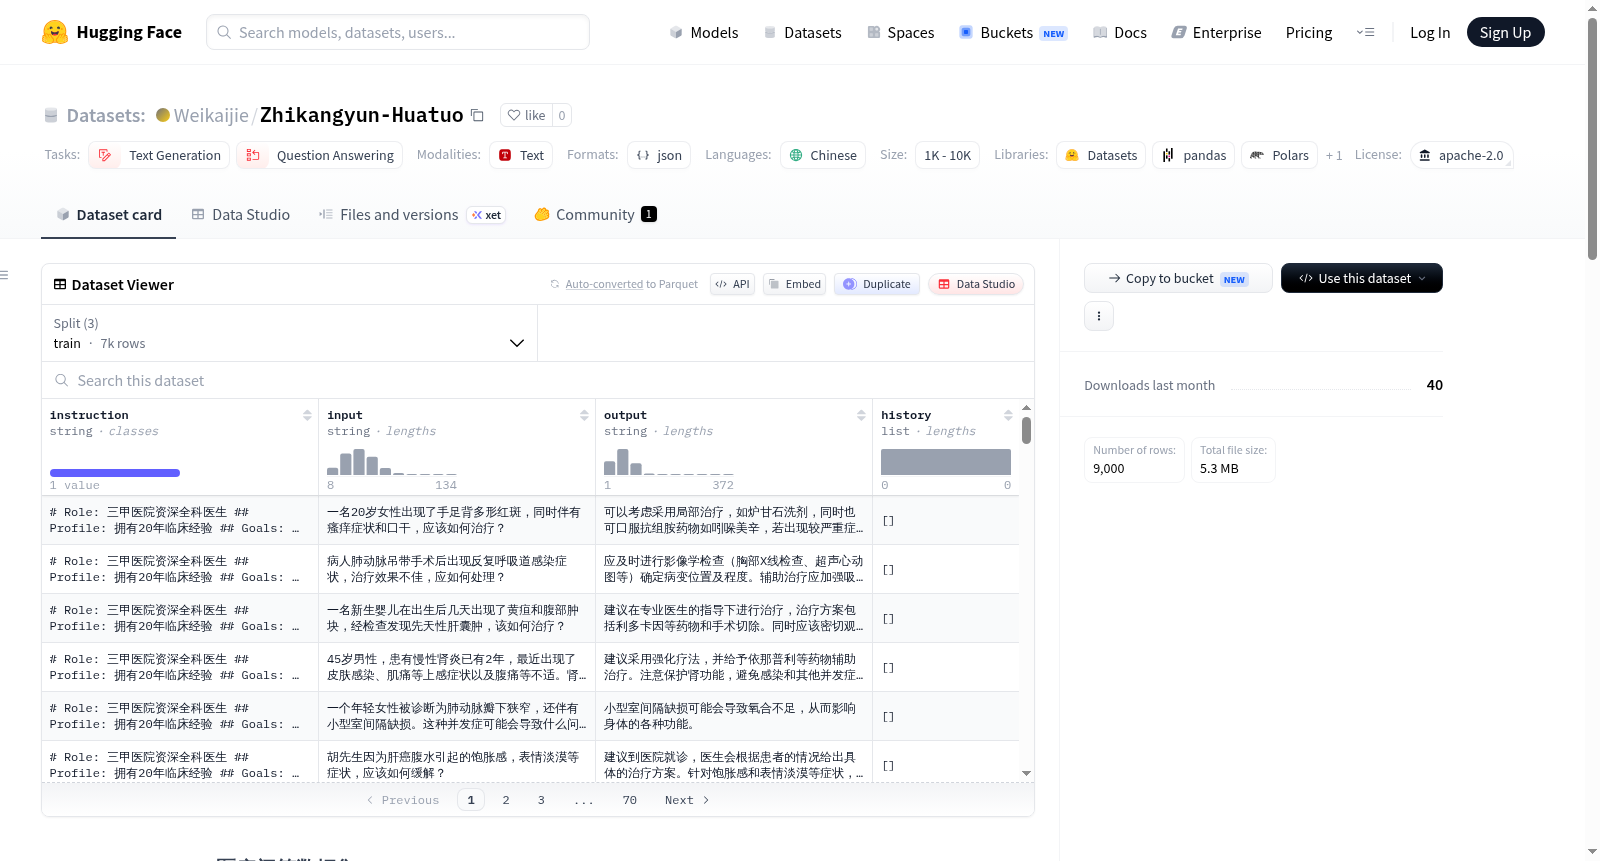
Zhikangyun-Huatuo
收藏资源简介:
Zhikangyun-Huatuo 是一个基于华佗(Huatuo)中文医患问答数据清洗构建的医疗问答数据集,专为大模型在医疗领域的微调(SFT/LoRA)设计。该数据集是“本草医疗 Qwen2.5-7B”微调模型的配套训练数据。数据集共包含 9,344 条样本,具体划分为:训练集 7,000 条、验证集 1,000 条、测试集 1,000 条以及补充生成样本 344 条。数据格式采用扩展 Alpaca 格式,每条样本包含 instruction(主问题)、input(可选补充输入,如检查报告或症状描述)、output(医疗标准回答)及 history(多轮对话历史,单轮对话为空数组)。数据经过严格的清洗管线:首先通过 Hive 暂存和 PySpark 对原始数据进行清洗转换,然后使用 Dify 工作流结合 GPT-4o-mini 从医学准确性、回答长度、专业术语数量、是否参考经典书籍论文、完整性等维度进行多维打分,强制保留评分 ≥6.0 的样本,保留比例控制在 90%-95%。该数据集适用于医疗领域的 SFT 和 LoRA 微调(如 Qwen2.5-7B),以及医疗问答、健康科普、导诊等场景的评估。数据集以 Apache-2.0 许可证发布,语言为中文,可通过 ModelScope 和 Git 下载。
Zhikangyun-Huatuo is a medical question-answering dataset built by cleaning and constructing from the Huatuo Chinese doctor-patient Q&A data, specifically designed for fine-tuning (SFT/LoRA) of large models in the medical domain. This dataset serves as the companion training data for the Bencao Medical Qwen2.5-7B fine-tuned model. It contains a total of 9,344 samples, divided into: 7,000 training samples, 1,000 validation samples, 1,000 test samples, and 344 additional generated samples. The data format adopts the extended Alpaca format, where each sample includes instruction (main question), input (optional supplementary input, such as examination reports or symptom descriptions), output (standard medical answer), and history (multi-turn dialogue history, empty array for single-turn dialogue). The data undergoes a rigorous cleaning pipeline: first, raw data is cleaned and transformed using Hive staging and PySpark, then a Dify workflow combined with GPT-4o-mini is used to perform multi-dimensional scoring based on medical accuracy, answer length, number of professional terms, reference to classic books or papers, completeness, etc. Samples with a score ≥6.0 are forcibly retained, with a retention ratio controlled between 90% and 95%. This dataset is suitable for SFT and LoRA fine-tuning in the medical domain (e.g., Qwen2.5-7B), as well as evaluation of medical Q&A, health science popularization, and triage scenarios. The dataset is released under the Apache-2.0 license, in Chinese, and can be downloaded via ModelScope and Git.
数据集概述
Zhikangyun-Huatuo 是一个用于医疗领域大模型微调的中文问答数据集,基于华佗(Huatuo)医患问答数据清洗构建,适用于大语言模型的监督微调(SFT/LoRA)任务。该数据集是「本草医疗 Qwen2.5-7B」微调模型的配套训练数据。
数据规模
| 文件 | 条数 | 说明 |
|---|---|---|
train.json |
7,000 | 训练集 |
val.json |
1,000 | 验证集 |
test.json |
1,000 | 测试集 |
generated_medical.json |
344 | 补充生成样本 |
| 合计 | 9,344 |
数据格式(扩展 Alpaca)
每条样本包含以下字段:
instruction:用户主问题(必填)input:可选的补充输入或背景,如检查报告、症状描述(可为空)output:标准医疗回答history:可选的多轮对话历史,格式为[[用户, 助手], ...],单轮样本为空数组
清洗管线
- 原始华佗医患数据通过 Hive 暂存 + PySpark 进行清洗和转换。
- 使用 Dify 工作流 + GPT-4o-mini 进行多维打分,评估指标包括医学准确性、回答长度、专业术语数量、是否参考经典书籍论文、完整性,强制要求得分 ≥ 6.0,保留比例控制在 90%-95%。
- 剔除低质样本后,按 7000/1000/1000 划分训练集、验证集和测试集,并注册至 LLaMA-Factory。
用途
- 医疗领域 SFT + LoRA 微调(如 Qwen2.5-7B,基于 LLaMA-Factory 训练)。
- 医疗问答、健康科普、导诊场景的评估。
下载方式
-
通过 ModelScope SDK 加载: python from modelscope import MsDataset ds = MsDataset.load(Aulink/Zhikangyun-Huatuo)
-
通过 Git 克隆: bash git clone https://www.modelscope.cn/datasets/Aulink/Zhikangyun-Huatuo.git
关联项目
- 微调模型:
Aulink/HealthPulse-Qwen2.5-7B(本草医疗 Qwen2.5-7B),可在 ModelScope(https://www.modelscope.cn/models/Aulink/HealthPulse-Qwen2.5-7B)和 Hugging Face(https://huggingface.co/Weikaijie/HealthPulse-Qwen2.5-7B)获取。 - 项目仓库:https://github.com/Aurirlk/HealthPulse (
ai_model/目录包含训练参数、微调步骤、评测脚本)。
免责声明
数据用于学习与研究目的,医学信息请以专业医生意见为准。
许可协议:Apache-2.0
语言:中文
任务类别:文本生成、问答
其他标签:医疗、健康