
遇见数据集

somosnlp-hackathon-2026/Onexe-QA-Dataset

收藏
Hugging Face2026-06-14 更新2026-06-21 收录
官方服务:

资源简介:

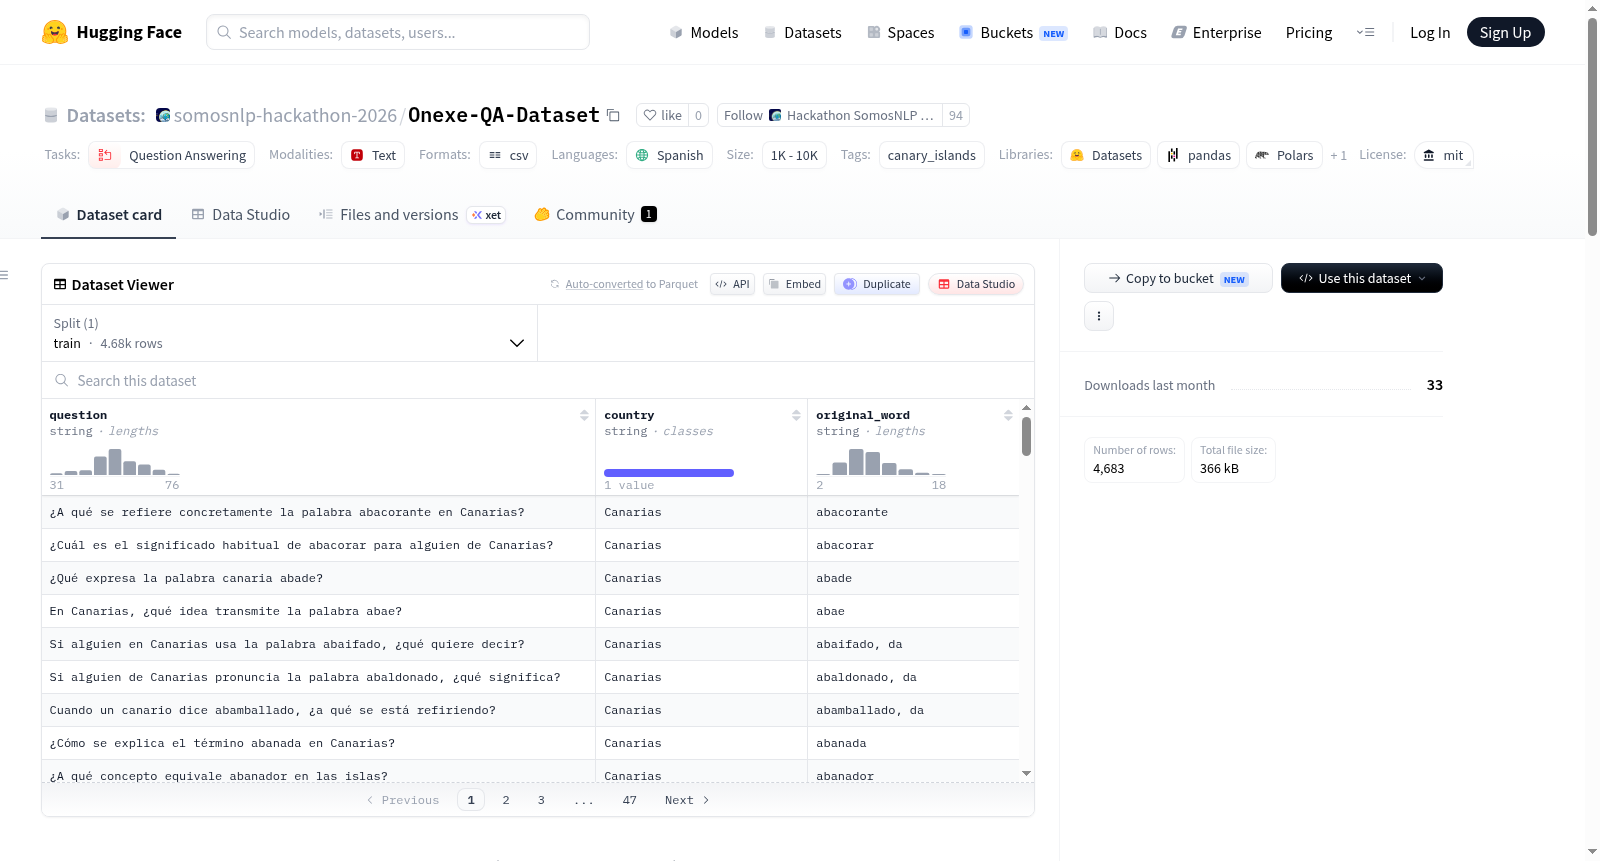
该数据集专门设计用于评估大型语言模型(LLMs)在加那利西班牙语语境下的方言、语言和文化理解能力。它包含4,683个基于加那利语言学院官方词典的评估问题,每个记录使用41种不同的问题模板随机但可重复地生成。主要目标是衡量模型在不同疑问结构下识别加那利地区术语的能力,并评估其对词汇和语法变化的鲁棒性,而无需直接访问答案。

This dataset has been designed specifically for evaluating the dialectal, linguistic, and cultural understanding of Large Language Models (LLMs) within the context of Canarian Spanish. It contains 4,683 evaluation questions based on the official lexicon of the Academy of Canarian Language (Academia Canaria de la Lengua - ACL). Each record presents a linguistic query phrased using one of 41 distinct question templates generated randomly yet reproducibly. The main goal is to measure a models ability to identify Canarian regional terms under diverse interrogative structures and evaluate its robustness to lexical and grammatical variations without having direct access to the answers in this subset.
搜集汇总
数据集介绍
somosnlp-hackathon-2026/Onexe-QA-Dataset 数据集图片
构建方式
该数据集专为评估大语言模型对加那利群岛西班牙语方言、语言学及文化理解能力而构建。基于加那利语言学院的官方词典,数据集精心挑选了4,683道评测问题,每道题目均采用41种随机生成但可复现的疑问句式之一进行表述,旨在通过多样化的句法结构检验模型识别区域术语的鲁棒性,答案未包含在该子集中以支持零样本或少样本推理评估。
特点
数据集特色在于其高度结构化的设计,所有记录均来自加那利群岛区域,确保地域文化聚焦。通过均匀分布于41种句式和方言问句风格的提问方式,有效避免固定提示词带来的评估偏差。字段设计简洁,包含问题、国别和原始词汇,便于直击模型对西伊比利亚-大西洋变体的语言敏感性分析。
使用方法
该数据集主要用作方言鲁棒性基准测试,通过向模型提交句式多变的查询,验证其是否能在语义核心不变的情况下准确理解问题。支持零样本或少样本的加那利词汇推理测试,即可作为测试集评估模型输出是否与官方定义吻合。此外,可用于区域对齐配置文件,衡量模型对加那利西班牙语与标准中性西班牙语差异的洞察能力,数据集采用MIT许可证,允许自由修改与商业使用。
背景与挑战
背景概述
在自然语言处理领域,方言与地域文化的理解能力已成为评估大语言模型(LLM)泛化性能的重要维度。由加那利群岛语言研究院(Academia Canaria de la Lengua)主导创建的Onexe-QA-Dataset,于近年发布,旨在系统性地评估LLM对加那利群岛西班牙语(Canarian Spanish)这一独特方言体的掌握程度。该数据集基于官方词典精编4,683道评估问题,覆盖41种句法变体,通过零样本或少样本推断任务,衡量模型对地方术语的辨识鲁棒性。作为首个聚焦伊比利亚-大西洋西翼方言的标准化基准,该数据集为区城语言建模、方言敏感性分析及多语言模型文化对齐研究提供了关键测试资源。
当前挑战
Onexe-QA-Dataset直面双重核心挑战。首先,在领域问题层面,现有LLM普遍缺乏对加那利群岛方言等非标准变体的深层语义理解,易将地方性词汇误判为普通西班牙语拼写错误或语义异常,亟需一套能揭示模型在句法多样性与文化语境下推理缺陷的评估工具。其次,在构建过程中,团队需从官方词典中筛选并标注4,683条词汇,同时设计41种无偏见的疑问句式模板以避免提示词偏差,确保评估结果能真实反映模型的语言适应性而非模板记忆,这对数据采集的规范性与句式生成的随机可重复性提出了极高要求。
常用场景
经典使用场景
该数据集的核心应用场景在于评估大语言模型对加那利群岛西班牙语方言的理解能力。通过包含4683个基于加那利语言学院官方词汇的评估问题,并采用41种不同句法模板生成提问,研究者能够系统性地检验模型在不同提问方式下对方言词汇的识别与语义推理能力。这种设计有效规避了固定提示词带来的偏差,为方言理解鲁棒性的量化分析提供了标准化基准。
衍生相关工作
该数据集催生了多项关于方言词汇推理与零样本学习的研究工作。例如,基于此数据集提出的方言鲁棒性基准测试方法,已被后续研究用于对比不同模型在低资源语言变体上的表现。另有工作将其与加那利语料库结合,构建了多任务学习框架,验证了少样本微调在方言理解中的有效性。这些衍生研究推动了模型对地域文化知识的内化能力,促进了多方言NLP评测体系的发展。
数据集最近研究
最新研究方向
当前,针对加那利群岛西班牙语方言的大语言模型评估正成为跨语言与方言理解研究的前沿热点。Onexe-QA-Dataset 数据集应运而生,专注于测试模型在多样化句法结构下对加那利语词汇的推断能力,填补了低资源方言评估的空白。随着生成式AI在伊比利亚-美洲地区的广泛应用,该数据集为探究模型对西伊比利亚-大西洋变体的文化敏感性提供了关键基准,其41种问句模板设计有效抑制了提示词偏差,推动了对话系统在区域性语言适应与鲁棒性验证方面的发展,对保护濒危方言、促进语言多样性具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

