
遇见数据集

modal-labs/autoinference-review-replay-512-v1

收藏
Hugging Face2026-07-13 更新2026-07-22 收录
官方服务:

资源简介:

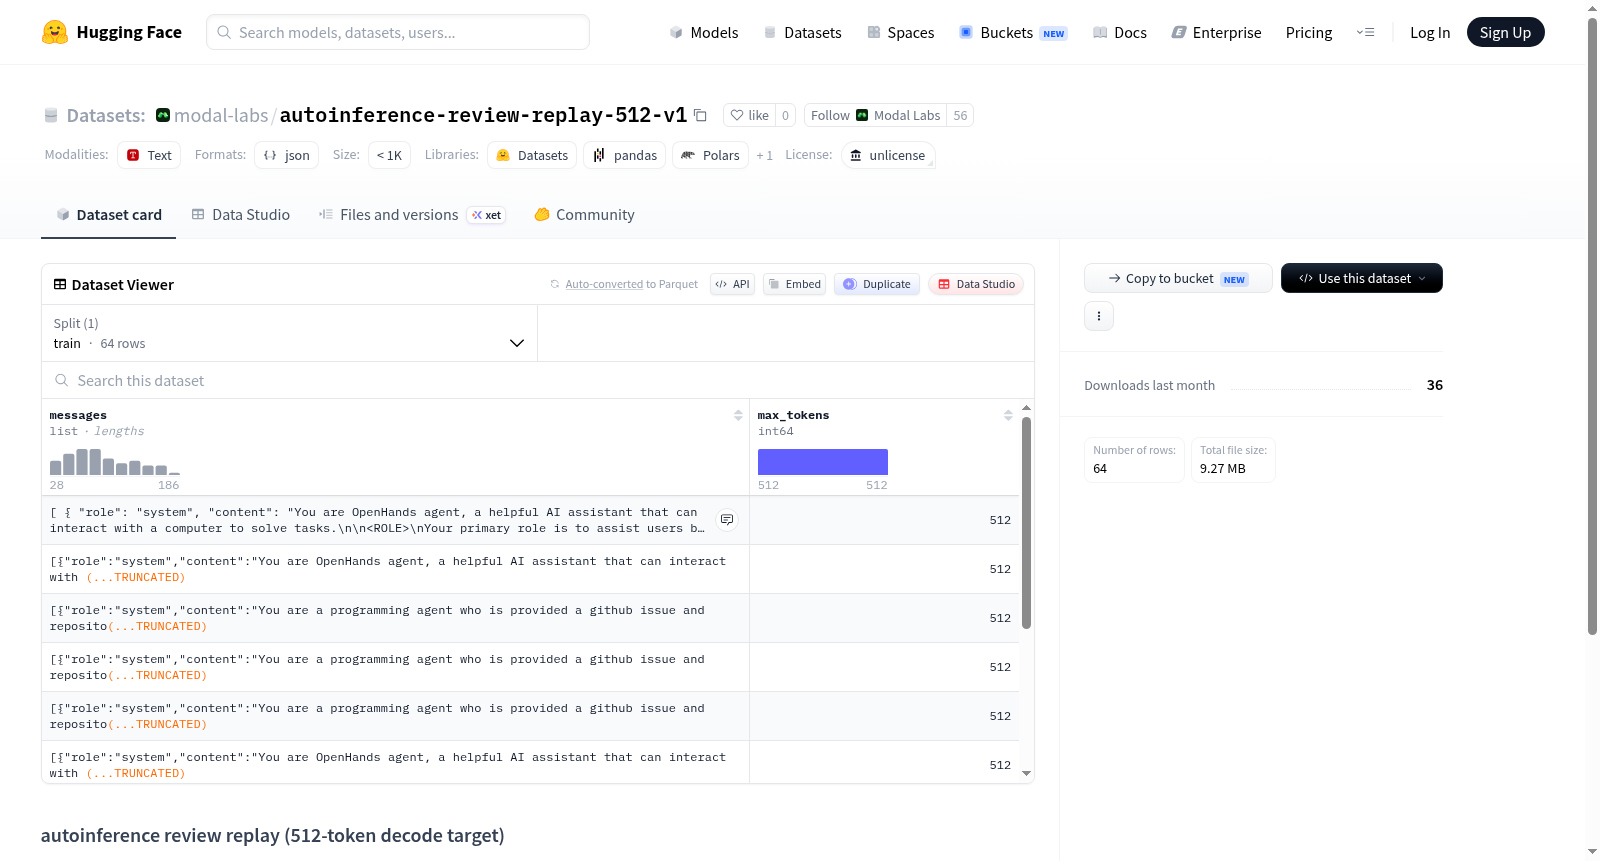
该数据集名为自动推理审查重放(512令牌解码目标),包含64个真实的代码审查重放请求,这些请求采用回合结构,并按轮询顺序排列以模拟生产环境中的基数缓存命中情况。每行数据设置max_tokens为512,这是用户为greptile新应用工作负载定义的解码目标,输入约为37.5k令牌/请求,前缀命中率约为92%。数据格式为每行一个{messages, max_tokens}对象,用于自动推理的OpenAI服务基准测试。数据来源于review_replay_v1_slice0(来自auto inference仓库)。

The dataset is titled auto inference review replay (512-token decode target) and contains 64 real code-review replay requests structured in turns, with round-robin order to reproduce the production radix-cache hit profile. Each row has max_tokens=512 as the user-set decode target for the greptile new-app workload, with input approximately 37.5k tokens per request and a prefix hit rate of about 92%. The format is one {messages, max_tokens} per line for the auto inference OpenAI serving benchmark. Source: review_replay_v1_slice0 (from the auto inference repository).
提供机构:
modal-labs
搜集汇总
数据集介绍
modal-labs/autoinference-review-replay-512-v1 数据集图片
构建方式
该数据集源于对实际代码审查回放请求的采集与结构化处理,共收录64条真实请求,每条请求采用回合制的轮询顺序排列,以复现生产环境中radix-cache的命中分布模式。每条数据包含完整的对话消息(messages)与用户设定的最大生成令牌数(max_tokens=512),格式适配autoinference框架的openai serving基准测试接口。数据来源于autoinference仓库中的review_replay_v1_slice0子集。
使用方法
每条数据以JSON Lines格式存储,包含messages和max_tokens字段,可直接用于autoinference工具集的openai服务基准测试。用户需按行读取数据,将messages作为对话输入,max_tokens作为生成长度限制,从而在自定义推理环境中复现生产级别的缓存压力与解码工作负载。该数据集专为性能评测设计,无需额外预处理即可集成到现有测试流水线中。
背景与挑战
背景概述
在大规模语言模型推理优化领域,推理缓存命中率与请求模式的一致性对服务性能至关重要。autoinference-review-replay-512-v1数据集由Greptile研究团队于近期创建,专注于模拟真实代码审查场景中的推理请求回放。该数据集包含64个结构化的请求流,每个请求以回合制顺序排列,旨在复现生产环境中基数缓存(radix cache)的命中分布。核心研究问题在于如何通过标准化请求模式评估推理系统的效率与缓存利用率。该数据集以每行对话记录和最大512个解码token为基本单元,输入平均约为37.5k token每请求,前缀命中率高达92%,为推理基准测试提供了高保真的真实工作负载模拟,对推理系统优化领域具有重要参考价值。
当前挑战
数据集研究面临的核心领域挑战在于如何高效处理高前缀命中率下的推理请求,尽管92%的缓存命中率显著降低了计算开销,但剩余8%的非命中请求仍可能成为延迟瓶颈,尤其在新应用负载出现时,缓存策略的适应性不足可能导致服务抖动。构建过程中遇到的挑战包括确保请求序列的保真度以准确复现生产环境缓存命中特征,同时需在有限的64个请求样本中平衡数据多样性与代表性。此外,如何在不同推理框架(如自动推理引擎)中标准化数据格式与接口,以及控制解码目标长度(512 token)对长尾请求的影响,也是构建数据的难点所在。
常用场景
经典使用场景
该数据集专为评估大语言模型在代码审查场景下的推理性能而设计。它模拟了真实的代码审查交互流程,以回合制轮询顺序重现了生产环境中基数缓存命中的典型模式。每条数据记录包含一次完整的审查回复请求,设定生成长度为512个令牌,输入文本平均约37.5k令牌,前缀缓存命中率高达92%。研究者可借助该数据集精确衡量模型在长上下文、高缓存命中条件下的解码效率,是进行推理系统性能基准测试的经典选择。
解决学术问题
该数据集有效解决了大语言模型在高并发代码审查推理场景中性能评估的标准化难题。学术界长期缺乏能够真实反映生产环境负载特征的公开基准,尤其是在前缀缓存命中率极高、输入序列超长的特定工作负载下。该数据集的提出填补了这一空白,为研究推理优化技术(如KV缓存复用、动态批处理与调度策略)提供了可复现的测试平台,推动了面向实际部署的推理效率提升研究。
实际应用
在实际应用中,该数据集主要用于大型代码托管平台和自动化代码审查工具的性能压测与优化。开发团队可基于该数据集的请求序列与负载特征,对推理服务进行压力测试,验证其在模拟真实生产流量下的吞吐量和延迟表现。同时,它能够帮助工程师诊断缓存策略、显存管理及请求调度等环节的瓶颈,从而指导推理基础设施的精细化调优,确保在高负载代码审查场景下提供稳定高效的AI辅助服务。
数据集最近研究
最新研究方向
该数据集针对代码审查场景下的自动推理服务性能评估而构建,聚焦于长上下文推理与radix缓存命中率优化这一前沿方向。通过模拟生产环境中高比例前缀命中(约92%)与巨大输入规模(约37.5k tokens/请求)的实际负载,该数据集为研究大语言模型在延迟敏感型代码智能任务中的高效解码策略提供了标准化基准。其面向512 token解码目标的回合制请求回放设计,直接关联到近期业界对AI辅助代码审查系统吞吐量与成本效益的量化研究,揭示了缓存机制与稀疏注意力在降低重复计算开销中的关键作用,对推动代码智能服务的工程化落地具有重要参考价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

