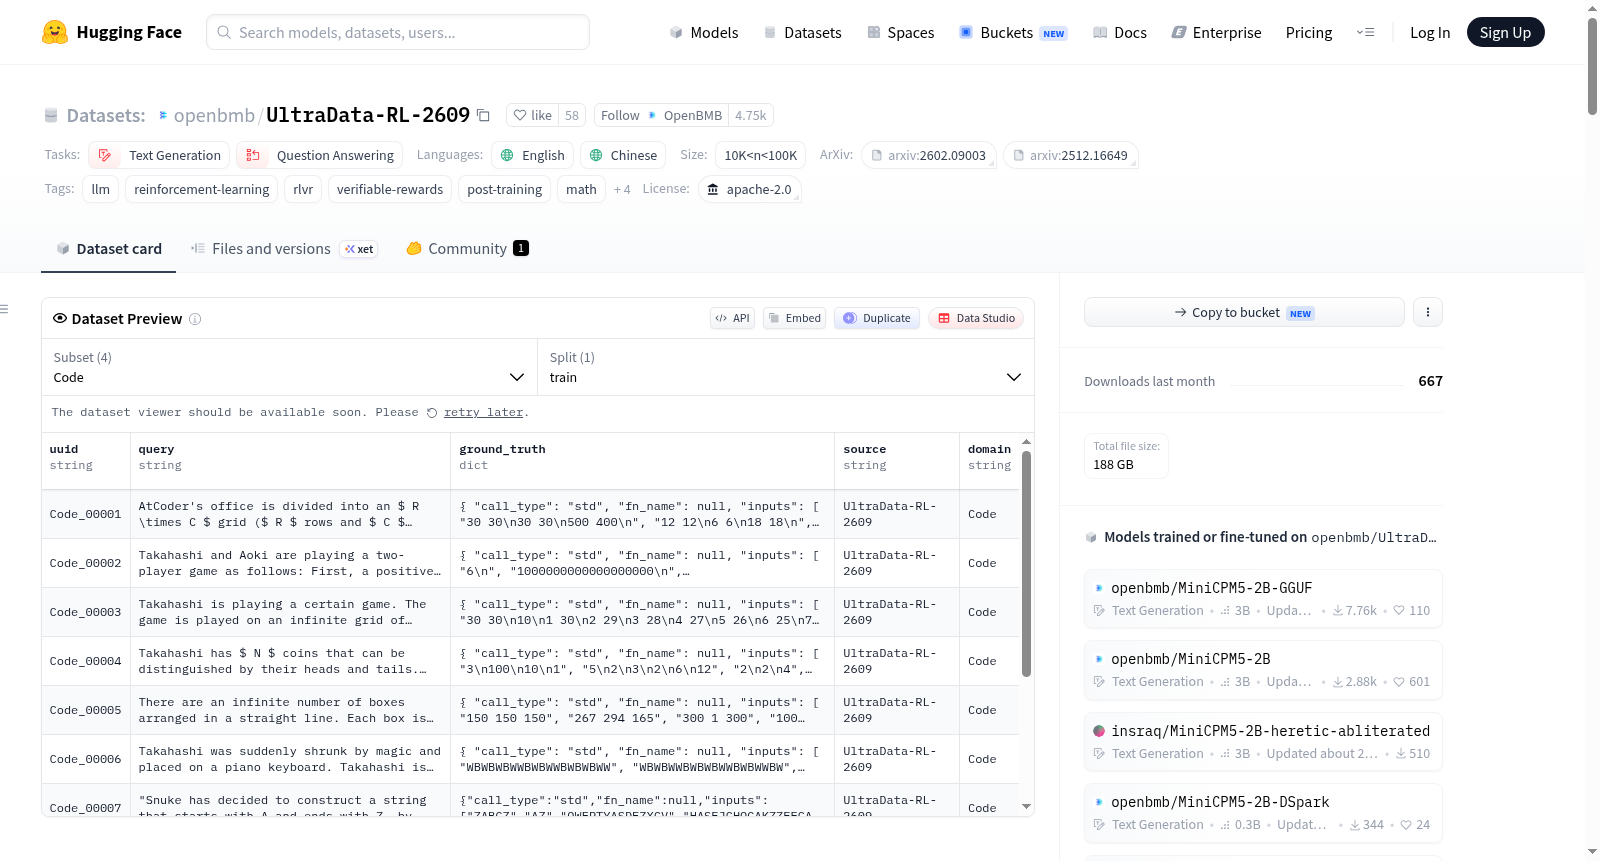
UltraData-RL-2609
收藏资源简介:
UltraData-RL-2609 是一个用于强化学习(RL)的大规模数据集,属于 UltraData 平台的 L0-L4 分级数据管理框架中的 L3 级精炼数据。该数据集专为 MiniCPM5-2B 模型的后训练阶段设计,与 UltraData-SFT-2605 相辅相成,专注于可验证奖励任务。数据集包含超过 85,000 个训练样本,覆盖数学推理、科学/知识推理、长上下文理解以及代码生成四个领域。具体分布为:数学(32,412 个样本,占 37.7%)、代码(23,665 个样本,占 27.5%)、长上下文(18,046 个样本,占 21.0%)、知识(11,872 个样本,占 13.8%)。每个样本均以 JSONL 格式存储,包含五个字段:uuid(全局唯一 ID)、query(完整问题描述)、ground_truth(参考答案或可验证目标)、source(来源标识)、domain(领域标签)。对于代码任务,ground_truth 是一个包含输入输出数组的对象,用于通过执行测试用例进行验证。数据集构建遵循六阶段流水线,确保结果可验证、奖励信号可靠、难度与 RL 训练匹配。数据来源包括多个公开数据集:数学来自 DAPO-Math-17k、DeepScaleR-Preview-Dataset、DeepMath-103K;知识来自 OpenScienceReasoning-2;长上下文来自 HotpotQA、Qasper、MuSiQue 及内部合成数据;代码来自 OpenCodeReasoning、OpenCodeReasoning-2、HardTests。该数据集适用于 RL/RLVR 后训练,特别用于数学推理、科学推理、长上下文多跳问答和带测试用例的程序合成等任务。用户可通过 Hugging Face Datasets 库加载不同配置(Math、Knowledge、Long-Context、Code)进行训练。注意:代码任务需要用户自行提供沙箱执行环境;难度过滤和在线采样权重未存储在字段中;去污染覆盖了构建时的已知评估集。
UltraData-RL-2609 is a large-scale dataset for reinforcement learning (RL), belonging to the L3 refined data level within the UltraData platforms L0-L4 hierarchical data management framework. It is specifically designed for the post-training phase of the MiniCPM5-2B model, complementing UltraData-SFT-2605, and focuses on verifiable reward tasks. The dataset contains over 85,000 training samples covering four domains: mathematical reasoning, scientific/knowledge reasoning, long-context understanding, and code generation. The distribution is: Math (32,412 samples, 37.7%), Code (23,665 samples, 27.5%), Long-Context (18,046 samples, 21.0%), and Knowledge (11,872 samples, 13.8%). Each sample is stored in JSONL format with five fields: uuid (globally unique ID), query (complete question description), ground_truth (reference answer or verifiable target), source (source identifier), and domain (domain label). For code tasks, ground_truth is an object containing input-output arrays for verification via test case execution. The dataset construction follows a six-stage pipeline to ensure verifiable results, reliable reward signals, and difficulty matching RL training. Data sources include multiple public datasets: Math from DAPO-Math-17k, DeepScaleR-Preview-Dataset, DeepMath-103K; Knowledge from OpenScienceReasoning-2; Long-Context from HotpotQA, Qasper, MuSiQue, and internal synthetic data; Code from OpenCodeReasoning, OpenCodeReasoning-2, HardTests. This dataset is suitable for RL/RLVR post-training, particularly for tasks such as mathematical reasoning, scientific reasoning, long-context multi-hop QA, and program synthesis with test cases. Users can load different configurations (Math, Knowledge, Long-Context, Code) via the Hugging Face Datasets library. Note: Code tasks require users to provide their own sandbox execution environment; difficulty filtering and online sampling weights are not stored in the fields; deduplication covers known evaluation sets at the time of construction.
UltraData-RL-2609 数据集详情
基本信息
- 发布机构:OpenBMB (MiniCPM Team)
- 许可证:Apache 2.0
- 语言:英语、中文
- 样本规模:85,995 条训练样本 (10K < n < 100K)
- 任务类型:文本生成、问答
- 发布用途:用于 MiniCPM5-2B 后训练的强化学习(RL)阶段,采用**可验证奖励(verifiable-reward)**机制
数据集构成
数据集包含四个方向的子配置:
| 方向 | 样本数 | 占比 | 任务描述 | 结果验证方式 |
|---|---|---|---|---|
| Math | 32,412 | 37.7% | 数学推理问题 | 与 ground_truth 答案匹配 |
| Code | 23,665 | 27.5% | 自然语言描述的程序合成 | 运行测试用例执行验证 |
| Long-Context | 18,046 | 21.0% | 长文档多跳问答 | 与 ground_truth 匹配,上下文可支撑答案 |
| Knowledge | 11,872 | 13.8% | 短答案科学/知识推理 | 与 ground_truth 答案匹配 |
数据格式
每条 JSONL 记录包含五个字段:
- uuid: 全局唯一样本 ID(域名前缀 + 索引)
- query: 任务描述;长上下文任务中完整上下文与问题均包含在此字段
- ground_truth: 参考答案;对 Code 任务为测试用例对象(含
inputs和outputs数组) - source: 数据来源标识
UltraData-RL-2609 - domain:
Math、Knowledge、Long_Context、Code之一
数据构建流程
六个阶段的流水线(所有域通用):
- 数据采集与整合:数学领域联合了 DAPO、DeepScaler、DeepMath 等公开数据集;科学知识领域来自 OpenScienceReasoning-2;长上下文数据含 HotpotQA、Qasper、MuSiQue 扩展及合成数据;代码领域以 OpenCodeReasoning 系列和 HardTests 为主。
- 任务标准化与重写:统一任务格式、答案字段与元数据,便于训练和验证器使用。
- 可验证性过滤:仅保留具备唯一自动可验证答案的条目,代码任务需在沙箱中执行。
- 奖励可靠性检查:LLM 法官审查问答一致性,数学/知识推理由多个模型独立求解并达成共识;代码测试用例交叉验证。
- 难度校准:在 RL 初始模型基础上估算通过率,移除已掌握条目(通过率=1),保留可学习条目;保留通过率=0但标签确认有效的难样本,配合在线动态采样调度。
- 格式化与质量审查:导出统一 JSONL,检查字段完整性、去重、排除公共评估基准重叠项。
数据特点
- 完整领域覆盖:数学推理、科学知识推理、长上下文理解与代码生成形成互补的 RL 信号。
- 可验证结果:每个领域均具有明确的参考目标与判定方式;多选、判断、证明、多部分及图像依赖题已在构建阶段移除。
- 可靠奖励信号:参考答案与执行结果均通过一致性检查,无法确认标签的数据被剔除而非猜测。
- 匹配 RL 训练的难度:难度过滤仅调整难度与采样权重,绝不改变参考标签。
使用方式
python from datasets import load_dataset
ds = load_dataset("openbmb/UltraData-RL-2609", "Math", split="train") ds = load_dataset("openbmb/UltraData-RL-2609", "Knowledge", split="train") ds = load_dataset("openbmb/UltraData-RL-2609", "Long-Context", split="train") ds = load_dataset("openbmb/UltraData-RL-2609", "Code", split="train")
可用配置:Math、Knowledge、Long-Context、Code。
预期应用场景
- MiniCPM 风格端侧模型的 RL / RLVR 后训练,配合验证奖励使用。
- 各领域独立使用:数学推理(Math)、科学/知识推理(Knowledge)、长上下文多跳问答(Long-Context)、可执行测试的程序合成(Code)。
- 混合比例研究,如与 UltraData-SFT-2605 进行比较分析。
注意事项与局限
- Code 域需自建验证器:数据集只含测试用例而非沙箱环境,用户需自行运行候选程序以计算奖励;需将
inputs[i]作为标准输入并去除末尾空白后与outputs[i]比较。 - 静态标签:构建时的难度过滤与在线采样权重未作为字段存储,仅保留筛选后的条目。
- 去污范围:筛选涵盖构建时已知的评估集,引入新基准前需重新检查。
上游数据来源
各领域均基于公开数据集构建并扩展:
- Math: DAPO-Math-17k、DeepScaleR-Preview-Dataset、DeepMath-103K(三者的并集)
- Knowledge: OpenScienceReasoning-2(改写为短答案形式)
- Long-Context: HotpotQA、Qasper、MuSiQue(扩展为更长上下文)+ 内部合成数据
- Code: OpenCodeReasoning、OpenCodeReasoning-2、HardTests(配合综合测试用例)
性能参考
在 JustRL II 实验设置下,使用该数据集训练后 AIME 2025 在约 300 步 RL 内从 61 提升至 81;最终 MiniCPM5-2B 检查点在 AIME 2025 上达到 86。
引用信息
如需引用,请使用 BibTeX: bibtex @misc{ultradata_rl_2609, title = {UltraData-RL-2609}, author = {MiniCPM Team}, year = {2026}, publisher = {Hugging Face}, howpublished = {url{https://huggingface.co/datasets/openbmb/UltraData-RL-2609}} }