
遇见数据集

thinkPy/americasnlp_2025_guarani_analysis

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

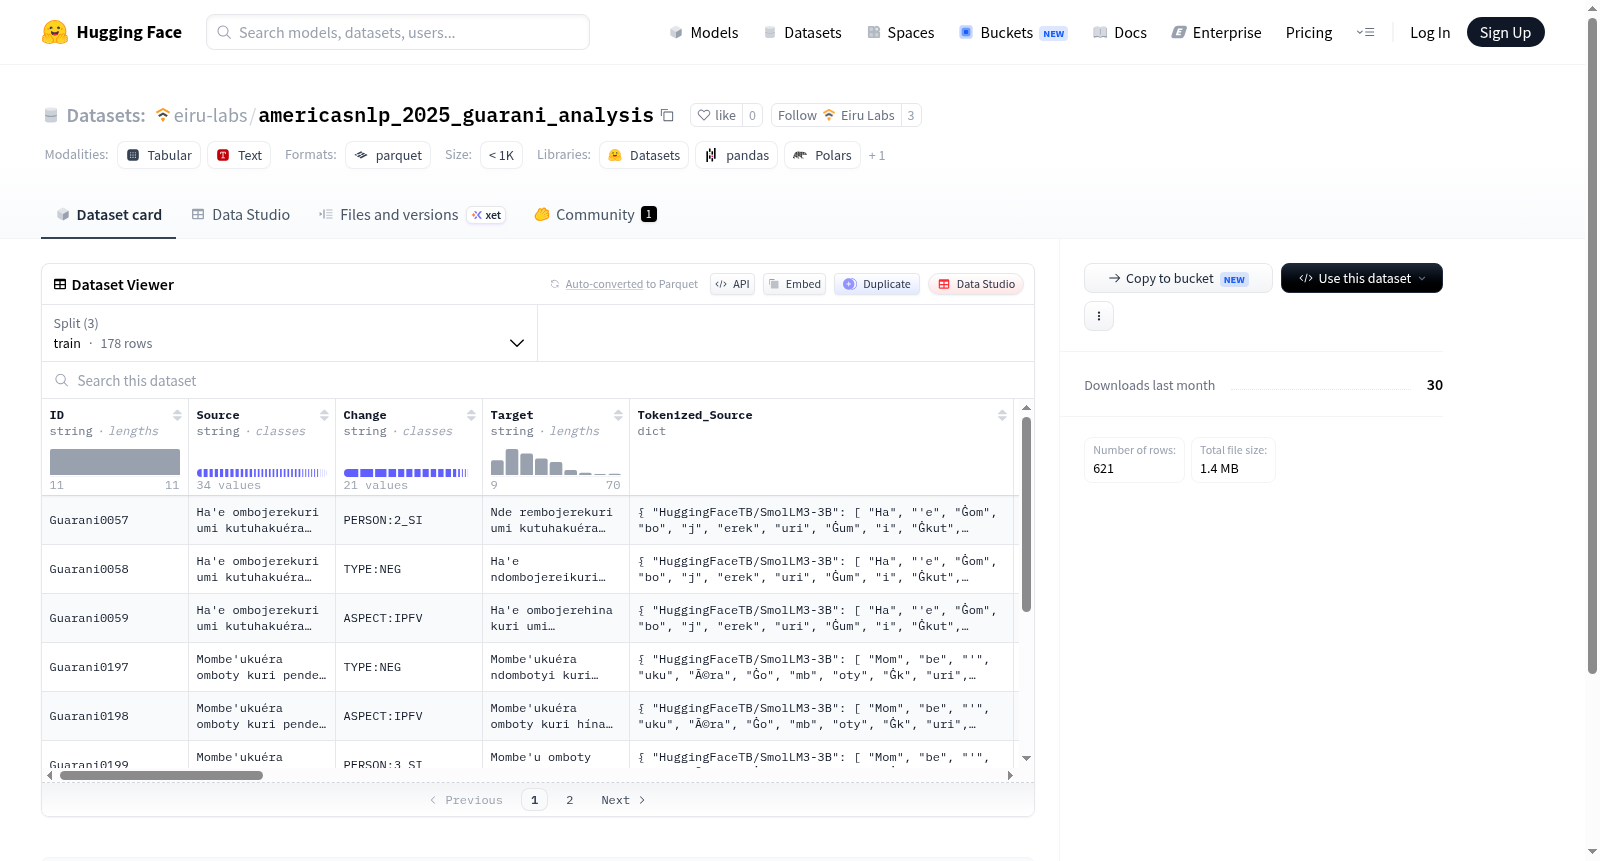
该数据集包含用于文本转换或编辑任务的数据,主要字段包括ID、源文本(Source)、变更描述(Change)和目标文本(Target)。数据集针对多个大语言模型(如SmolLM3-3B、Llama系列、Qwen系列等)提供了分词后的源文本和目标文本(Tokenized_Source和Tokenized_Target),以及对应的词元计数(Source_Token_Count和Target_Token_Count)、生育度量(Source_Fertility_Metric和Target_Fertility_Metric)、词元距离(Token_Distance)和归一化词元距离(Token_Distance_Normalized)。此外,还包含源文本和目标文本的形态学词元(Morphological_Tokens_Source和Morphological_Tokens_Target)。数据集分为训练集(178个示例)、开发集(79个示例)和测试集(364个示例),适用于自然语言处理任务,如文本改写、编辑距离分析或多模型分词比较。

This dataset contains data for text transformation or editing tasks, with main fields including ID, source text (Source), change description (Change), and target text (Target). The dataset provides tokenized source and target texts (Tokenized_Source and Tokenized_Target) for multiple large language models (e.g., SmolLM3-3B, Llama series, Qwen series), along with corresponding token counts (Source_Token_Count and Target_Token_Count), fertility metrics (Source_Fertility_Metric and Target_Fertility_Metric), token distance (Token_Distance), and normalized token distance (Token_Distance_Normalized). Additionally, it includes morphological tokens for source and target texts (Morphological_Tokens_Source and Morphological_Tokens_Target). The dataset is divided into training set (178 examples), development set (79 examples), and test set (364 examples), suitable for natural language processing tasks such as text paraphrasing, edit distance analysis, or multi-model tokenization comparison.
提供机构:
thinkPy
搜集汇总
数据集介绍
thinkPy/americasnlp_2025_guarani_analysis 数据集图片
构建方式
低资源语言机器翻译研究面临的核心挑战在于平行语料的稀缺与标注工具的匮乏。该数据集聚焦于巴拉圭官方语言之一的瓜拉尼语,精心构建了一个面向细粒度形态分析的双语平行语料库,涵盖西班牙语与瓜拉尼语之间的翻译对。每条数据都包含原文、译文、词级数量统计、形态学拆分结果,以及经由29种主流大语言模型分别对源文、目标文及其形态词元进行分词处理后的词元序列、词元计数、繁育度指标、词元距离和归一化距离等多维分析结果,从而为深入探究不同模型在处理粘着语形态时的行为差异提供结构化素材。
特点
该数据集的一个核心特征在于其爬梳了覆盖不同参数量级与架构风格的29种前沿语言模型的分析结果,横跨HuggingFaceTB、LiquidAI、Google、Meta、Microsoft、MistralAI、MoonshotAI、OpenAI、OpenBMB及智谱AI等多家机构。每个样本不仅记录了各模型生成的原生与形态学词元序列,还计算了表征模型内部表征差异的繁育度、词元距离及其归一化值。这种多模型、多粒度的标注体系,使得研究者能够系统性地评估并对比通用大模型在低资源、复杂形态语言上的分词一致性和适应性。
使用方法
该数据集以标准HuggingFace Datasets格式存储,划分为训练、开发与测试三部分,分别包含178、79与364个样本。用户可通过datasets库的load_dataset函数直接加载default配置项使用。每条记录中的Tokenized_Source等结构化字段为嵌套字典,键为模型名称,值为对应字段数据,便于按模型进行筛选与比较分析。此类设计特别适用于开展多模型分词行为对比、形态学特征对齐以及词元级翻译质量评估等研究任务,为低资源自然语言处理领域提供标准化的评测基准与分析工具。
背景与挑战
背景概述
在自然语言处理领域,低资源语言的形态学分析一直是极具挑战性的研究方向。美洲土著语言中的巴拉尼语(Guarani)因其复杂的粘着形态结构和匮乏的数字化语料资源,长期处于计算语言学研究的边缘地带。americasnlp_2025_guarani_analysis数据集应运而生,由美洲NLP社区在2025年构建,旨在为巴拉尼语的形态学分析提供标准化评估基准。该数据集核心研究问题聚焦于跨形态边界的分词及词素标记,通过收录涵盖多个领域的平行语料,为评估多语言模型在形态丰富语言的表示能力提供关键资源。该数据集的发布对于推动低资源语言处理技术发展具有里程碑意义,尤其为评测大规模语言模型在高变异性语素层面的泛化能力开辟了新路径。
当前挑战
构建该数据集面临双重挑战。在领域问题层面,最主要的是解决低资源语言形态学分析的匮乏困境:大多数现代词法分析工具和预训练模型针对印欧语系设计,难以直接应用于巴拉尼语这类形态高度粘着的语言,例如单一名词形式可能包含数十种屈折变化。在构建过程中,数据收集与质量控制的难度尤为突出:原始语料来源稀缺且分布极度不均,需从有限的文献、口语记录和在线社区数据中提炼并规范化处理;同时,由于缺乏现成的形态学专家标注资源,需要设计跨语言的多轮人工校验流程确保标注一致性;此外,该数据集包含29种不同规模语言模型的向量化表示,全面覆盖小至3.5亿参数直至3.9千亿参数的模型,确保不同架构下分词效果的公平对比亦是技术性挑战。
常用场景
经典使用场景
在低资源语言处理领域,瓜拉尼语作为南美洲重要的原住民语言,其计算资源长期匮乏。americasnlp_2025_guarani_analysis数据集为研究者提供了一个横跨多个主流大语言模型的系统化分析基准,涵盖从数百亿参数到超大规模模型的推理表现。该数据集的核心用途在于评估和对比不同模型对瓜拉尼语的理解与生成能力,尤其关注词法分析、分词一致性及语义保留程度。通过标准化源文本和目标文本、统计词元距离与丰度指标,该数据集成为探索多语言模型在极低资源场景下泛化潜力的理想实验平台。
衍生相关工作
围绕此数据集已衍生出多个前沿研究方向。一方面,研究者利用其丰富的词元级标注,提出了一系列针对低资源语言的跨模型分词一致性评估方法,催生了多篇关于大语言模型泛化极限的实证分析。另一方面,基于Source_Fertility_Metric与Token_Distance字段,学术界开发出新型的形态感知神经架构搜索算法,用于自动适配模型词汇表以提升低资源语言编码效率。此外,该数据集的跨模型对比框架被扩展至其他美洲原住民语言,如艾马拉语和克丘亚语,形成了americasnlp系列评测基准,为少样本跨语言迁移学习设立规范化的评测标尺。
数据集最近研究
最新研究方向
针对低资源语言瓜拉尼语的跨模型分词对比研究,该数据集通过系统性地记录源文本与目标文本在近30种主流大语言模型分词器下的词元化结果、fertility度量、词元距离及形态学词元信息,为揭示不同架构与规模的语言模型在处理黏着语形态丰富性时呈现的分词偏好与偏差提供了珍贵的对照基准。这一研究范式革新了传统以单一模型为中心的低资源语言评估,转而构建一个多元模型协同的细粒度分析框架,其意义在于推动多语言与低资源自然语言处理领域的评估标准化,并为开发更适配南美原住民语言形态特征的优化分词策略指明方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

