logdx-ci
收藏资源简介:
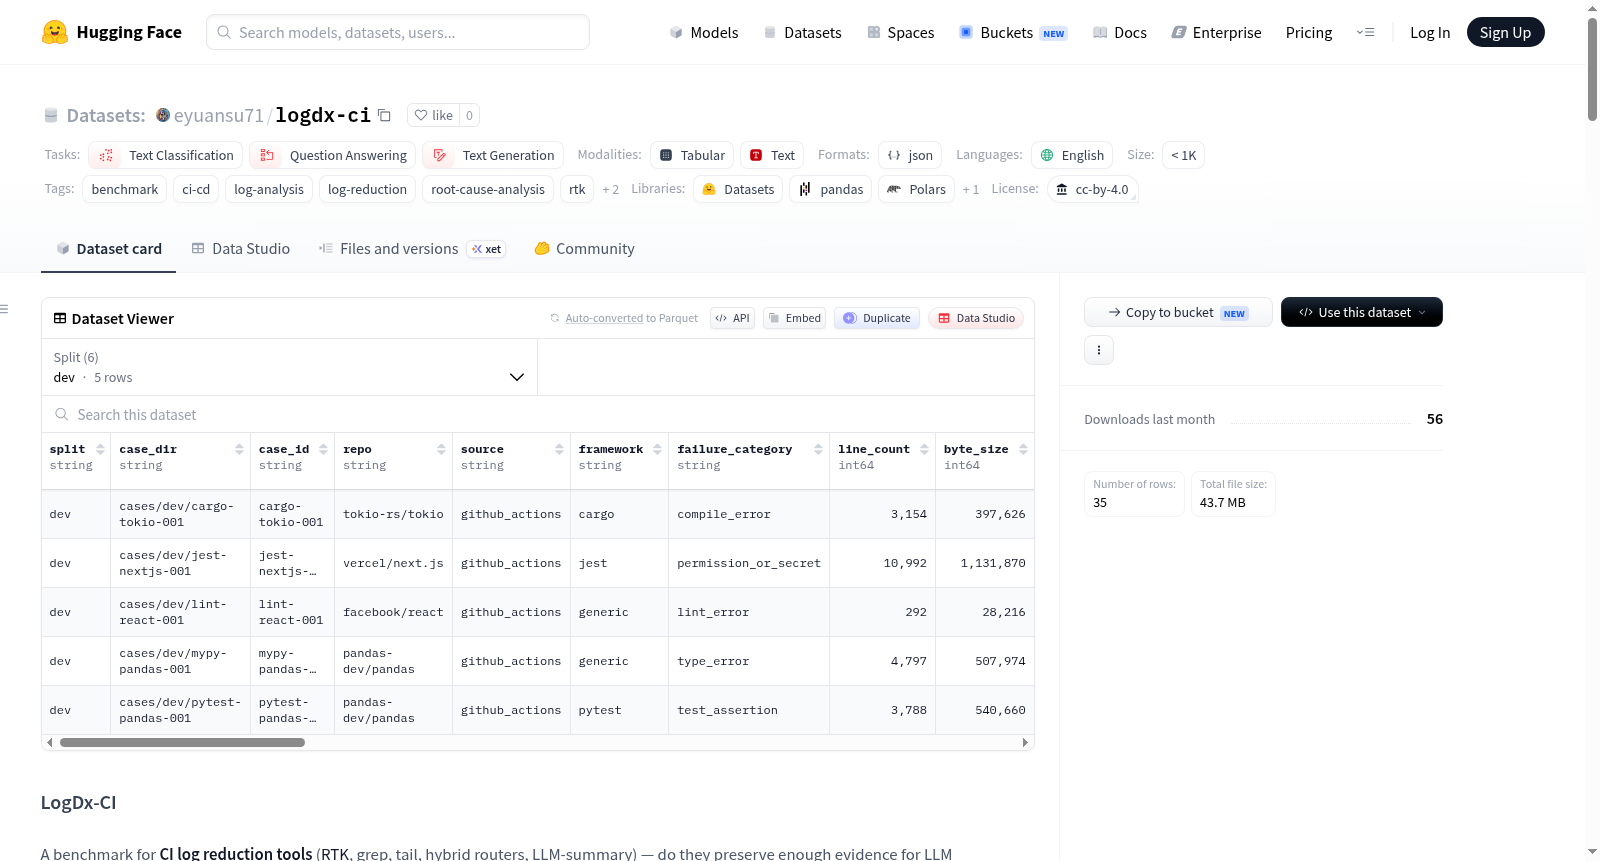
LogDx-CI是一个专门用于评估持续集成(CI)日志缩减工具的基准测试数据集。该数据集旨在测试各种日志处理工具(如RTK、grep、tail、混合路由器和LLM摘要生成器)在压缩CI失败日志时,是否保留了足够的关键证据,以支持大型语言模型(LLM)进行准确的根因诊断。数据集包含35个真实的CI失败案例,这些案例来自公开可见的GitHub Actions运行记录,并经过了隐私审计处理。数据以两种互补的格式提供:一种为扁平化的元数据表格,包含27个字段,涵盖案例的基本信息、标签和根因摘要,适用于快速浏览和过滤;另一种为完整的每案例数据包,包含原始日志文件、详细的案例元数据、完整的嵌套式真值标注(包括必需信号、证据片段、相关文件、预期诊断等)、标签文件以及隐私审计记录。数据被划分为6个分割(dev, holdout, stress, v2_dev, v2_holdout, v2_stress),总计35个案例,覆盖了8种主要的失败类别(如测试断言失败、编译错误、类型错误、依赖安装失败等)和超过7个不同的开发生态系统(如Python的pytest、Rust的cargo、Go测试等)。该数据集适用于文本分类、问答和文本生成等任务,特别是用于评估和比较不同日志缩减方法在辅助LLM进行自动化根因分析方面的效果,并附带基准测试结果。
LogDx-CI is a benchmark dataset specifically designed for evaluating continuous integration (CI) log reduction tools. It aims to test whether various log processing tools (including RTK, grep, tail, hybrid routers, and LLM summarizers) retain sufficient key evidence when compressing CI failure logs to support large language models (LLMs) in accurate root cause diagnosis. The dataset contains 35 real CI failure cases sourced from publicly visible GitHub Actions runs, which have undergone privacy auditing. Data is provided in two complementary formats: one is a flattened metadata table with 27 fields covering basic case information, labels, and root cause summaries, suitable for quick browsing and filtering; the other is a complete per-case data package containing raw log files, detailed case metadata, comprehensive nested ground truth annotations (including required signals, evidence snippets, relevant files, expected diagnoses, etc.), label files, and privacy audit records. The data is divided into 6 splits (dev, holdout, stress, v2_dev, v2_holdout, v2_stress), totaling 35 cases, covering 8 major failure categories (such as test assertion failures, compilation errors, type errors, dependency installation failures, etc.) and over 7 different development ecosystems (e.g., Pythons pytest, Rusts cargo, Go testing, etc.). This dataset is suitable for tasks like text classification, question answering, and text generation, particularly for evaluating and comparing different log reduction methods in assisting LLMs with automated root cause analysis, and it comes with benchmark results.
数据集概述:LogDx-CI
LogDx-CI 是一个专为CI日志缩减工具设计的基准测试数据集,用于评估这些工具在保留足够证据以供大语言模型进行根因诊断方面的表现。
核心信息
- 许可证:CC-BY-4.0(数据)、Apache-2.0(代码)
- 语言:英语
- 当前版本:v1.2
- 总样本数:35个CI失败案例
- 任务类型:文本分类、问答、文本生成
- 相关资源:
数据集结构与使用方式
数据集提供两种格式,包含相同的35个案例:
-
格式一:扁平元数据表格(通过
load_dataset或 Dataset Viewer 浏览)- 包含27列,每行对应一个案例的元数据、标签和根因摘要。
- 共6个数据切分,35行。
- 适用场景:浏览、按类别/生态/切分过滤、构建仪表盘。
- 示例代码: python from datasets import load_dataset ds = load_dataset("eyuansu71/logdx-ci")
-
格式二:完整案例包(通过
snapshot_download获取)- 每个案例包含4个文件:
raw.log(原始CI失败日志)、case.json(安全元数据)、ground_truth.json(AI起草+作者验证的完整嵌套标注)、tags.json(标签)。 - 适用场景:运行基准测试、训练、需要原始日志或完整标注的工作。
- 示例代码: python from huggingface_hub import snapshot_download local_dir = snapshot_download(repo_id="eyuansu71/logdx-ci", repo_type="dataset")
- 每个案例包含4个文件:
数据切分
| 切分 | 案例数 | 说明 |
|---|---|---|
| dev | 5 | v1 原型波次开发集 |
| holdout | 5 | v1 原型波次留出集 |
| stress | 6 | v1 原型波次压力集 |
| v2_dev | 3 | v2 正式波次开发集 |
| v2_holdout | 10 | v2 正式波次留出集 |
| v2_stress | 6 | v2 正式波次压力集 |
| 总计 | 35 |
覆盖范围
- 8种失败类别:
test_assertion,compile_error,type_error,lint_failure,dependency_install,docker_build,timeout_or_oom,multi_failure,并包含scattered和matrix_or_monorepo_failure作为跨领域标签。 - 7+个生态系统:包括 Python (pytest)、Rust (cargo)、Go (go test)、Java (Maven)、Node (pnpm + jest + biome)、Docker (buildx)、helm/k8s、Terraform、Gradle、TCL (cpython)、Airflow、TypeScript (tsc)、Redis 等。
主要发现与领先方法
根据对 35个真实CI失败案例及3个模型系列(Claude Haiku 4.5, Claude Sonnet 4.6, OpenAI gpt-5-mini)的评估,排名前3和垫底4的方法在不同模型系列中表现稳定。
| 排名 | 方法 | 总体得分(案例加权) |
|---|---|---|
| 1 | hybrid-grep-120k-rtk-tail |
0.670 |
| 2 | hybrid-grep-120k-tail |
0.666 |
| 3 | llm-summary-v1-gpt-5-mini (v1.2新增) |
0.664 |
| 4 | grep |
0.639 |
| 5 | llm-summary-v1-haiku (v1.1升级为头条) |
0.632 |
| 6 | tail-200 |
0.614 |
隐私与注意事项
- 隐私:所有原始CI日志来自公开的GitHub Actions运行,并经过隐私审查流程,无隐私泄露记录。
- 注意事项:
- 当前为v1.2预印本版本,目标于v1.3扩展至50+案例。
- 标注由AI起草并由项目作者单一人验证,非独立人工标注。
- 目前仅测试了3个模型系列,不包括Gemini、Llama或DeepSeek。
- 未进行独立的第三方复现评估。
- 案例中包含20个历史排除项,评估时会进行零分弃权处理以保持分母正确。
引用
bibtex @misc{qin2026logdx, title = {{LogDx-CI}: Benchmarking CI Log Reduction Tools for LLM Root-Cause Diagnosis}, author = {Qin, Bowen}, year = {2026}, howpublished = {url{https://github.com/eyuansu62/LogDx}}, note = {v1.2 release; cases corpus at url{https://huggingface.co/datasets/eyuansu71/logdx-ci}}, }