
LogDx-CI
收藏数据链接:
官方服务:
资源简介:
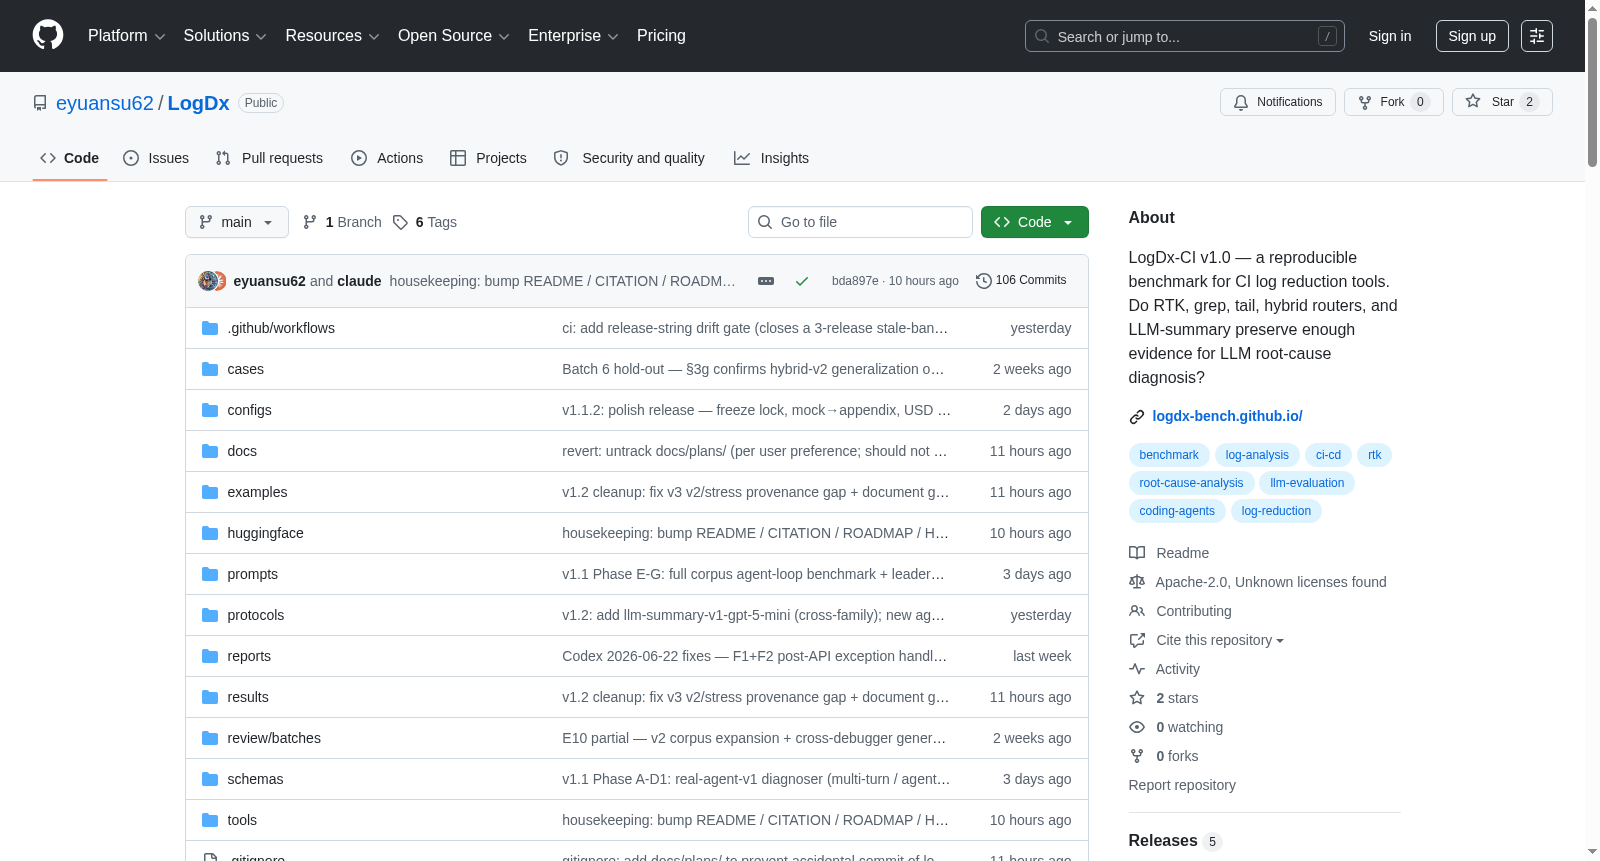
LogDx-CI是一个用于CI日志减少工具的可复现基准,包含35个真实CI故障案例,用于评估不同上下文提供者(如raw、tail、grep、RTK模式、llm-summary和混合路由器)在LLM根因诊断中的表现。数据集包括原始日志、案例JSON、地面真值JSON等文件,旨在优化方法排名稳定性。
LogDx-CI is a reproducible benchmark for CI log reduction tools. It contains 35 real CI failure cases, and is designed to evaluate the performance of different context providers (such as raw, tail, grep, RTK mode, llm-summary and hybrid router) in LLM-based root cause diagnosis. The dataset includes raw logs, case JSON files, ground-truth JSON files and other related documents, aiming to optimize the ranking stability of diagnostic methods.
创建时间:
2026-05-16
原始信息汇总
数据集概述
数据集名称:LogDx-CI
目的:这是一个用于评估CI日志缩减工具(如RTK、grep、tail、混合路由器、LLM摘要)的基准数据集,旨在检验这些工具是否能为LLM根因诊断保留足够的证据。
核心内容:
- 包含 35个真实的CI失败案例(目标扩至50+)。
- 比较了10种上下文提供方法:
raw(原始日志)、tail、grep、三种RTK模式(rtk-read、rtk-log、rtk-err-cat)、llm-summary(LLM摘要),以及三种混合路由器。 - 使用三个调试器家族(Claude Haiku 4.5、Claude Sonnet 4.6、OpenAI gpt-5-mini)对相同的CI失败日志进行根因诊断,并基于AI起草、作者验证的真实答案进行评分。
主要发现:
- 在三个模型家族中,排名前2的稳定交集为
hybrid-grep-120k-rtk-tail和hybrid-grep-120k-tail。 - 底部4个方法集也为所有三个模型家族所共有。
数据与代码:
- 代码与工具(
tools/、examples/等):采用 Apache-2.0 许可证。 - 数据、报告与协议(
cases/、results/、reports/等):采用 CC-BY-4.0 许可证。 - 数据镜像:位于 Hugging Face 数据集 eyuansu71/logdx-ci。
- 使用方式:通过
git clone获取仓库,每个案例位于cases/<split>/<case_id>/目录下,包含raw.log、case.json、ground_truth.json等文件。
局限性(当前预印本 v1.2):
- 仅包含35个案例(目标为50+,需更广泛的生态系统覆盖)。
- 真实答案是AI起草、单作者验证,而非独立人工注释。
- 仅测试了三个模型家族(Haiku/Sonnet/gpt-5-mini),GPT-4o/Gemini/Llama 为预期的后续方向。
- 存在20个历史排除记录(在
configs/historical_provider_error_exclusions.json中),在评估中表现为零分弃权。
相关链接:
搜集汇总
数据集介绍
构建方式
LogDx-CI数据集的构建围绕持续集成(CI)日志归约工具对根因诊断效用的评估展开。研究团队从公开的GitHub Actions运行中采集了35个真实的CI失败案例,每个案例包含原始日志、案例描述、人工验证的基准真相及隐私审计信息。在此基础上,设计了10种上下文提供方法,包括原始日志、tail、grep、RTK的三种模式(rtk-read、rtk-log、rtk-err-cat)、LLM摘要以及三种混合路由策略。将同一份CI失败日志分别交由Claude Haiku 4.5、Claude Sonnet 4.6和OpenAI gpt-5-mini三类大语言模型进行诊断,并依据AI起草且经作者验证的基准真相评分,最终形成跨模型家族的方法排名稳定性基准。
特点
该数据集的核心特点在于聚焦方法排名的跨模型稳定性,而非单纯追求最高诊断分数。通过35个真实案例与三个不同模型家族的交叉验证,揭示了混合路由策略(如hybrid-grep-120k-rtk-tail和hybrid-grep-120k-tail)在稳定性上的显著优势,其在前三排名中保持一致。数据集提供了完整的评估管线,包含可复现的评分脚本和缓存机制,支持新增上下文提供方法、诊断模型家族及案例贡献。当前版本v1.2为预印本,目标扩展至50+案例及更多模型生态。
使用方法
用户可通过克隆GitHub仓库直接使用数据集,每个案例存放于cases目录下,包含原始日志、基准真相及元数据文件。若要复现排行榜结果,可运行tools/evaluate_diagnosis.py脚本并指定评估集与诊断器配置。对于全新的大语言模型API调用,需参考RELEASE_NOTES中的可复现性说明。数据集的完整架构、验证脚本及添加新方法的清单均收录于CONTRIBUTING.md文档中,方便研究者扩展与对比分析。
背景与挑战
背景概述
持续集成(CI)在现代软件开发中扮演着核心角色,然而CI失败日志的冗长与冗余特性严重阻碍了根因诊断的效率。针对此痛点,新加坡国立大学的Bowen Qin团队于2025年创建了LogDx-CI基准数据集,旨在系统评估各类日志缩减工具(包括RTK、grep、tail、混合路由器及LLM摘要)是否在为大型语言模型(LLM)进行根因诊断时保留足够的关键证据。该数据集涵盖35个真实CI失败案例,通过三种模型家族(Claude Haiku 4.5、Claude Sonnet 4.6及OpenAI gpt-5-mini)对十种上下文提供方法进行排名稳定性比较,为CI日志处理领域提供了首个标准化评估框架,对减少故障排查时间、提升自动化诊断可靠性具有重要影响。
当前挑战
LogDx-CI面临的挑战集中在两大维度。领域问题层面,CI失败日志的格式异构性与语义噪声使得传统缩减方法常丢弃关键线索,而现有LLM辅助诊断方案又缺乏统一的日志冗余度与证据保留度权衡指标,导致方法选择缺乏依据。构建过程中,团队遭遇了案例多样性不足(当前仅35例,目标为50+)、人工标注成本高昂(仅单作者验证AI初稿)、以及跨模型家族通用性验证缺失(仅测试三个模型)等困难。此外,日志隐私审计、历史方法排除偏差(20项已记录)以及跨方法间的排名不稳定亦构成核心障碍,亟需通过扩展案例集、引入独立人工标注与更多模型(如GPT-4o、Gemini、Llama)来强化基准的鲁棒性与普适性。
常用场景
经典使用场景
在持续集成(CI)与软件可靠性工程领域,日志缩减工具的性能评估一直是研究难点。LogDx-CI数据集专为基准测试CI日志缩减方法而设计,其经典使用场景在于:向多个LLM诊断器(如Claude Haiku 4.5、Claude Sonnet 4.6、OpenAI gpt-5-mini)提供经不同缩减策略处理后的同一CI失败日志,通过比较诊断结果与人工验证的真实根因,系统性地评估各缩减方法在保留诊断证据方面的有效性。该数据集涵盖35个真实CI故障案例、10种上下文提供器(包括raw、tail、grep、三种RTK模式、LLM摘要及混合路由策略),并采用跨模型家族的方法排名稳定性作为评估核心,而非单一LLM的绝对得分。
衍生相关工作
LogDx-CI数据集一经发布便催生了多项具有影响力的衍生工作。在方法论层面,研究者基于其评估框架提出了新型混合路由算法,例如将统计异常检测与LLM摘要动态结合的上下文提供器,进一步提升了低资源场景下的诊断质量。在工具生态方面,RTK项目(Rust Token Killer)借助该数据集的基准测试结果优化了其日志过滤策略,并衍生出针对不同失败模式的专用模式(如rtk-err-cat被验证为有效的中间提供器)。此外,该数据集的评估协议被多个后续工作采纳为默认比较基线,包括针对GPT-4o、Gemini及Llama系列模型的跨模型稳定性研究,以及探索日志粒度与诊断延迟之间权衡关系的新兴课题。
数据集最近研究
最新研究方向
在持续集成(CI)领域,日志压缩与根因诊断的协同优化正成为前沿焦点。LogDx-CI基准的提出,突破了传统仅评估LLM诊断准确性的局限,转而聚焦于不同日志缩减方法(如RTK、grep、混合路由器及LLM摘要)对下游诊断效果的稳定贡献。该数据集通过35个真实CI失败案例与三族LLM诊断器的系统对比,揭示了混合策略(如hybrid-grep-120k-rtk-tail)在跨模型排名中表现出的卓越稳健性。这一发现表明,日志缩减并非简单的信息过滤,而是需要为LLM保留关键证据的精细任务。LogDx-CI的发布呼应了AI运维领域对可解释、可复现基准的迫切需求,为后续研究从单一诊断性能比拼转向日志处理与诊断流程的系统耦合提供了可量化的评估范式。
以上内容由遇见数据集搜集并总结生成


