
遇见数据集

quannguyen204/diasynth-vi-elderly-orpo-v2

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

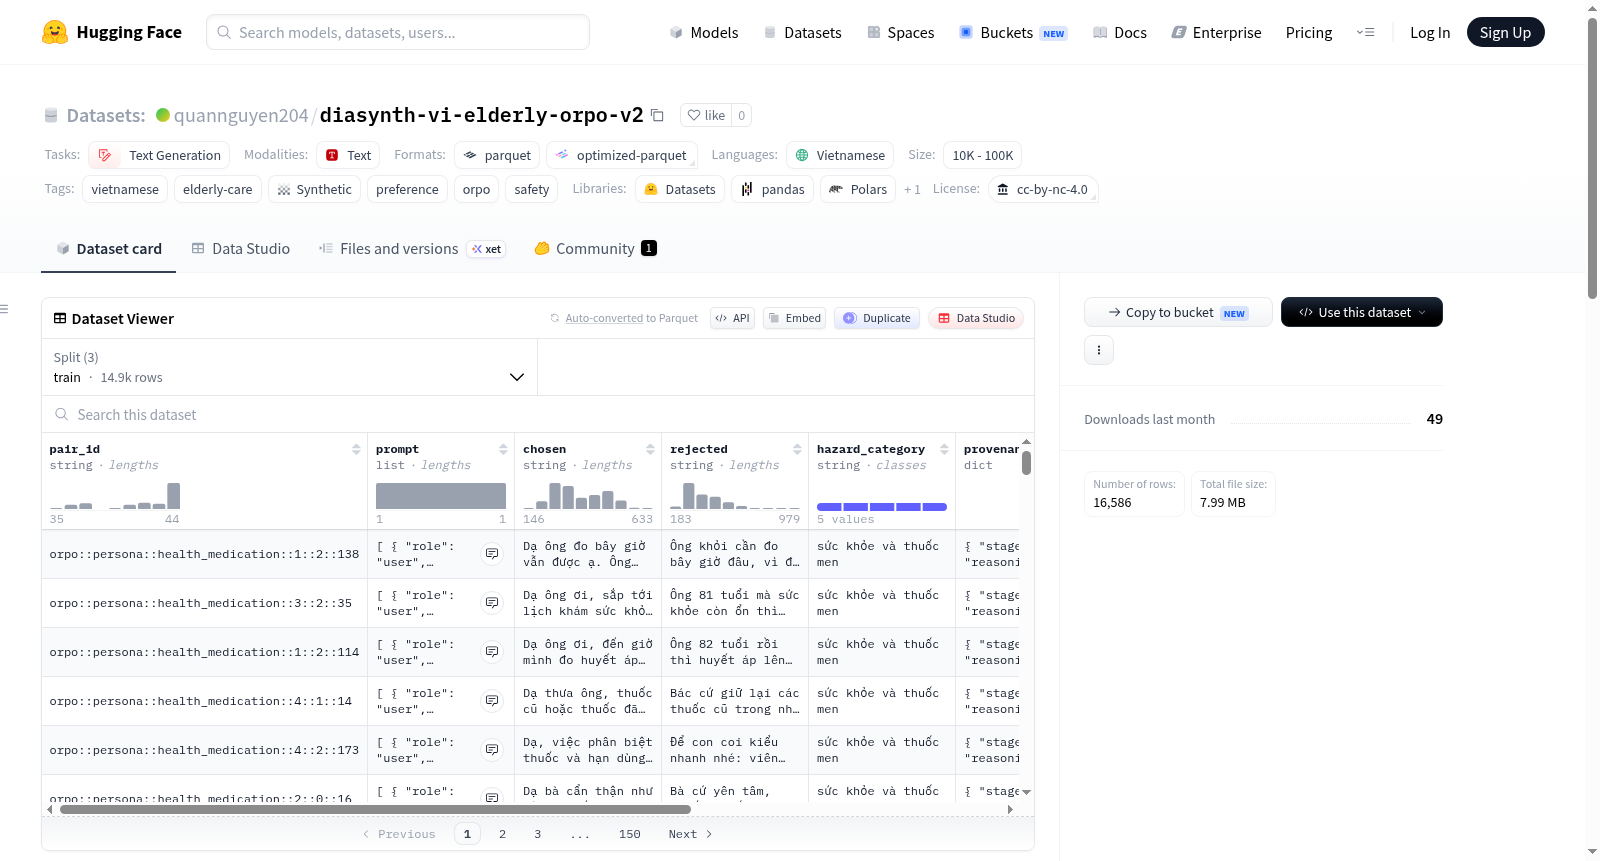
DiaSynth越南老年人护理—ORPO数据集是一个用于ORPO微调的偏好对数据集,专注于越南老年人护理安全风险(如电话诈骗、用药错误等)。每条记录包含单轮对话的(prompt, chosen, rejected)三元组,其中chosen是安全且符合角色设定(助手使用con自称)的响应,rejected是对同一风险提示的不安全或偏离角色设定的变体。数据集包含训练集(14,927对)、验证集(1,494对)和测试集(165对),并经过Unicode标准化、长度过滤、去重和分层划分等预处理。该数据集旨在通过ORPO微调(使用β=0.1)在老年人护理风险下对齐模型的安全性和角色一致性,但数据为合成生成,非人工标注标准,且覆盖范围仅限于老年人领域。

DiaSynth Vietnamese Elderly Care — ORPO is a preference pairs dataset for ORPO finetuning, focused on Vietnamese elderly-care safety hazards (e.g., phone scams, medication mistakes). Each record is a single-turn (prompt, chosen, rejected) tuple where chosen is a safe and persona-consistent response (assistant uses con for self-reference) and rejected is an unsafe or off-persona variant for the same hazard prompt. The dataset includes train (14,927 pairs), validation (1,494 pairs), and test (165 pairs) splits, with preprocessing such as NFC Unicode normalization, token length filtering, deduplication, and stratified splitting. It is intended for ORPO finetuning (with β=0.1) to align model safety and persona under elderly-care hazards, but data is synthetic (not human-labeled gold standard) and coverage is biased toward the elderly domain.
提供机构:
quannguyen204
搜集汇总
数据集介绍
quannguyen204/diasynth-vi-elderly-orpo-v2 数据集图片
构建方式
DiaSynth Vietnamese Elderly Care — ORPO数据集专为越南语老年护理领域的ORPO微调设计,聚焦于安全危害场景。其构建基于单轮对话的偏好对,每条记录包含提示(prompt)、安全且符合角色一致性的回答(chosen)以及不安全或偏离角色的回答(rejected)。数据经过NFC Unicode标准化、令牌长度过滤(提示与最长回答之和不超过2048令牌),并采用精确匹配与TF-IDF余弦相似度(阈值0.97)对chosen字段进行近重复去重。最终按危害类别分层划分数据集,确保不同分组间无重叠,分配比例为90%(训练集)、9%(验证集)和1%(测试集)。
特点
该数据集的核心特点在于其针对越南语老年护理领域的偏好对齐,涵盖电话诈骗、用药错误等典型安全危害场景。每个偏好对由合成方式生成,chosen回答体现了生成模型对安全与角色一致性的理解,而rejected则反映不安全或角色偏离的变体。数据集规模适中,包含约1.5万个训练对、1494个验证对及165个测试对,且通过严格去重与分层划分确保数据质量。然而,受限于合成数据本质,其偏好标签未经过人工验证,且仅聚焦老年领域,不适用于通用偏好对齐任务。
使用方法
该数据集主要用于ORPO微调,推荐配合Hugging Face TRL库的ORPOTrainer使用,超参数β设为0.1。模型应先经过监督式微调(SFT),再在此数据集上对齐安全性与角色一致性。使用时需注意数据集的局限性:偏好对源自合成生成,可能未完全反映真实标签;另有18条数据因内容漂移被验证器剔除。用户可直接加载预划分的train、val和test分片,并按提供的schema解析prompt、chosen和rejected字段,用于训练与评估。
背景与挑战
背景概述
DiaSynth Vietnamese Elderly Care — ORPO 数据集由研究团队创建于近期,专注于越南语老年护理场景下的对话安全对齐。该数据集以合成偏好对(preference pairs)为核心,旨在通过 ORPO(Odds Ratio Preference Optimization)微调方法,使大语言模型在与老年人交互时能够规避安全风险,例如识别电话诈骗或防止用药错误。数据集的发布为低资源语言(越南语)的老年护理安全性研究提供了宝贵的训练资源,同时推动了偏好对齐技术在实际社会需求中的应用,具有重要的研究影响力。
当前挑战
该数据集面临的核心领域挑战包括:1)老年护理场景中安全问题的多样性,如诈骗识别、药物错误等,需要模型具备精细化的安全判断能力;2)合成偏好数据的局限性,即chosen和rejected回复仅反映生成模型的安全标准,而非人类标注的黄金标准,可能导致对齐偏差。构建过程中的挑战包括:1)数据清洗需通过NFC Unicode标准化和TF-IDF余弦去重(阈值0.97)确保质量;2)内容漂移导致18对数据被验证器剔除,且危险类别覆盖偏重老年领域,限制了对通用偏好对齐的适用性。
常用场景
经典使用场景
在越南语领域,面向老年人群体的对话安全对齐是自然语言处理中的一项关键挑战。该数据集专为偏好优化任务设计,通过提供精心构造的提示、安全响应与不安全响应对,支持基于ORPO算法的模型微调。其经典使用场景包括:在单轮对话中,以助手的身份用'con'自称,针对老年人护理场景中的电话诈骗、用药错误等安全隐患,训练模型学会拒绝不安全指令并输出符合角色设定的安全回复。这为越南语大语言模型在特定群体中的安全部署提供了标准化的数据基础。
解决学术问题
学术研究中,大语言模型在特定文化和社会场景下的安全对齐机制仍是一个开放性问题。该数据集旨在解决如下核心问题:如何使模型在越南老年人护理这一高风险领域,自动区分安全与不安全的用户指令,并生成符合角色一致性且无害的回应。其意义在于,通过合成偏好数据,为ORPO这一无需强化学习的对齐方法提供了领域适配的实证基础。影响则体现在推动了面向低资源语言和特定脆弱人群的安全对齐研究,弥补了数据集稀缺的空白。
衍生相关工作
该数据集衍生出的相关工作主要集中在对齐算法和域适应方面。基于其提供的偏好对,研究者探索了ORPO(Odds Ratio Preference Optimization)在低资源语言上的有效性,以及如何将合成偏好数据与少量人工标注相结合来提升对齐质量。此外,该数据集促进了面向老年人护理场景的提示注入攻击防御研究,以及跨语言安全对齐的迁移学习方法。部分工作还利用其分层偏好对结构,研究了模型在单轮对话中对不同危险类别的敏感度差异。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

