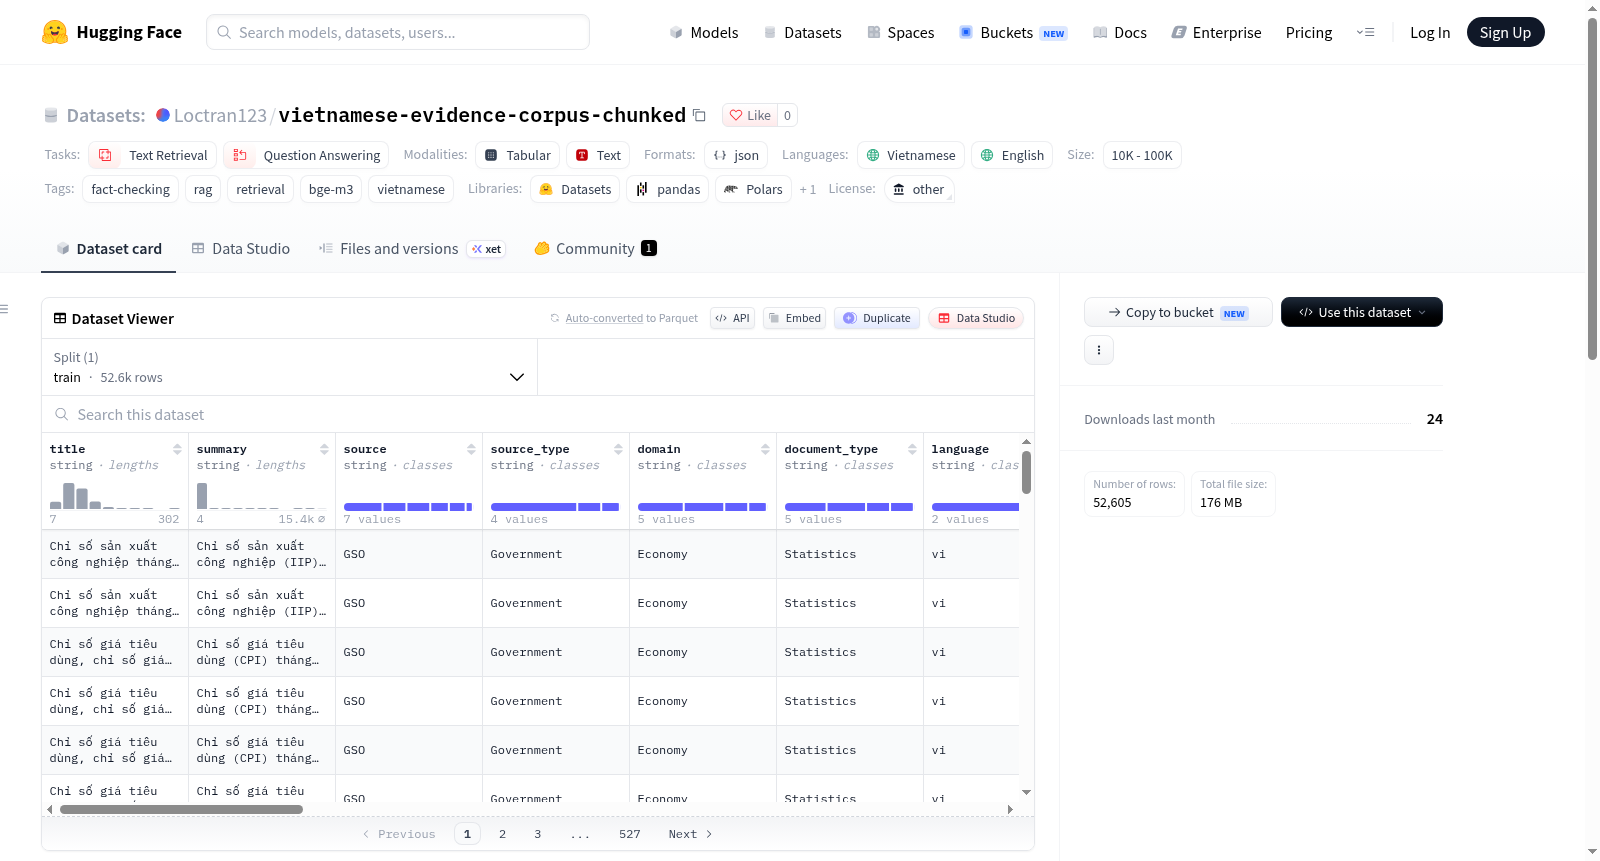
vietnamese-evidence-corpus-chunked
收藏资源简介:
该数据集是越南语-英语双语的证据语料库(分块版本),专为多语言信息检索、检索增强生成(RAG)和事实核查实验而准备。数据集中包含来自13,572个源文档的47,679个文本块,其中38,603个为越南语块,9,076个为英语块。每个块的最大长度为512个BGE-M3分词器令牌。数据集提供丰富的字段信息,包括:块ID、文档ID、块索引、令牌起始位置、令牌结束位置、令牌数量、标题、文本、摘要、来源、来源类型、领域、文档类型、语言、国家、发布日期、爬取日期、URL、作者、元数据以及质量。建议在嵌入时将标题和文本拼接为"title + + text"作为输入,其余字段用作过滤或引用元数据。数据集可通过Hugging Face Datasets库加载,文件为data/corpus_v1_chunked.json。请注意,该仓库不授予超出原始源文章的权利,用户需自行遵守各来源的使用条款。
This dataset is a Vietnamese-English bilingual evidence corpus (chunked version) prepared for multilingual information retrieval, retrieval-augmented generation (RAG), and fact-checking experiments. It contains 47,679 text chunks from 13,572 source documents, including 38,603 Vietnamese chunks and 9,076 English chunks. Each chunk has a maximum length of 512 BGE-M3 tokenizer tokens. The dataset provides rich fields: chunk_id, doc_id, chunk_index, token_start, token_end, token_count, title, text, summary, source, source_type, domain, document_type, language, country, publish_date, crawl_date, url, author, metadata, and quality. It is recommended to concatenate title and text as "title + + text" for embedding, while other fields serve as filtering or reference metadata. The dataset can be loaded via the Hugging Face Datasets library from the file data/corpus_v1_chunked.json. Note that this repository does not grant rights beyond the original source articles, and users must comply with the terms of use of each source.
越南语证据语料库(分块版)
数据集概述
该数据集是一个为多语言信息检索、检索增强生成(RAG)和事实核查实验准备的分块证据语料库,包含越南语和英语两种语言的内容。
数据规模
- 总块数:47,679 个文本块
- 来源文档:13,572 篇源文档
- 语言分布:38,603 个越南语块,9,076 个英语块
- 块长度上限:512 个 BGE-M3 tokenizer 词元
主要字段
- 标识字段:
chunk_id(块ID)、doc_id(文档ID)、chunk_index(块索引) - 位置信息:
token_start(起始词元)、token_end(结束词元)、token_count(词元数量) - 内容字段:
title(标题)、text(正文)、summary(摘要) - 来源信息:
source(来源)、source_type(来源类型)、domain(领域)、document_type(文档类型) - 语言与时间:
language(语言)、country(国家)、publish_date(发布日期)、crawl_date(抓取日期) - 其他字段:
url(链接)、author(作者)、metadata(元数据)、quality(质量)
使用说明
- 嵌入输入格式:使用 `title + "
" + text` 作为嵌入输入内容
- 过滤与引用:其余字段可作为筛选条件和引用元数据使用
加载方式
python from datasets import load_dataset
dataset = load_dataset( "Loctran123/vietnamese-evidence-corpus-chunked", data_files="data/corpus_v1_chunked.json", split="train", )
使用许可与注意事项
- 该数据集采用 other 许可证
- 数据集本身不授予对原始来源文章的额外权利
- 用户需自行遵守各原始来源的条款规定