
遇见数据集

MCG-NJU/VideoChat3-OL617k

收藏
Hugging Face2026-07-17 更新2026-07-22 收录
官方服务:

资源简介:

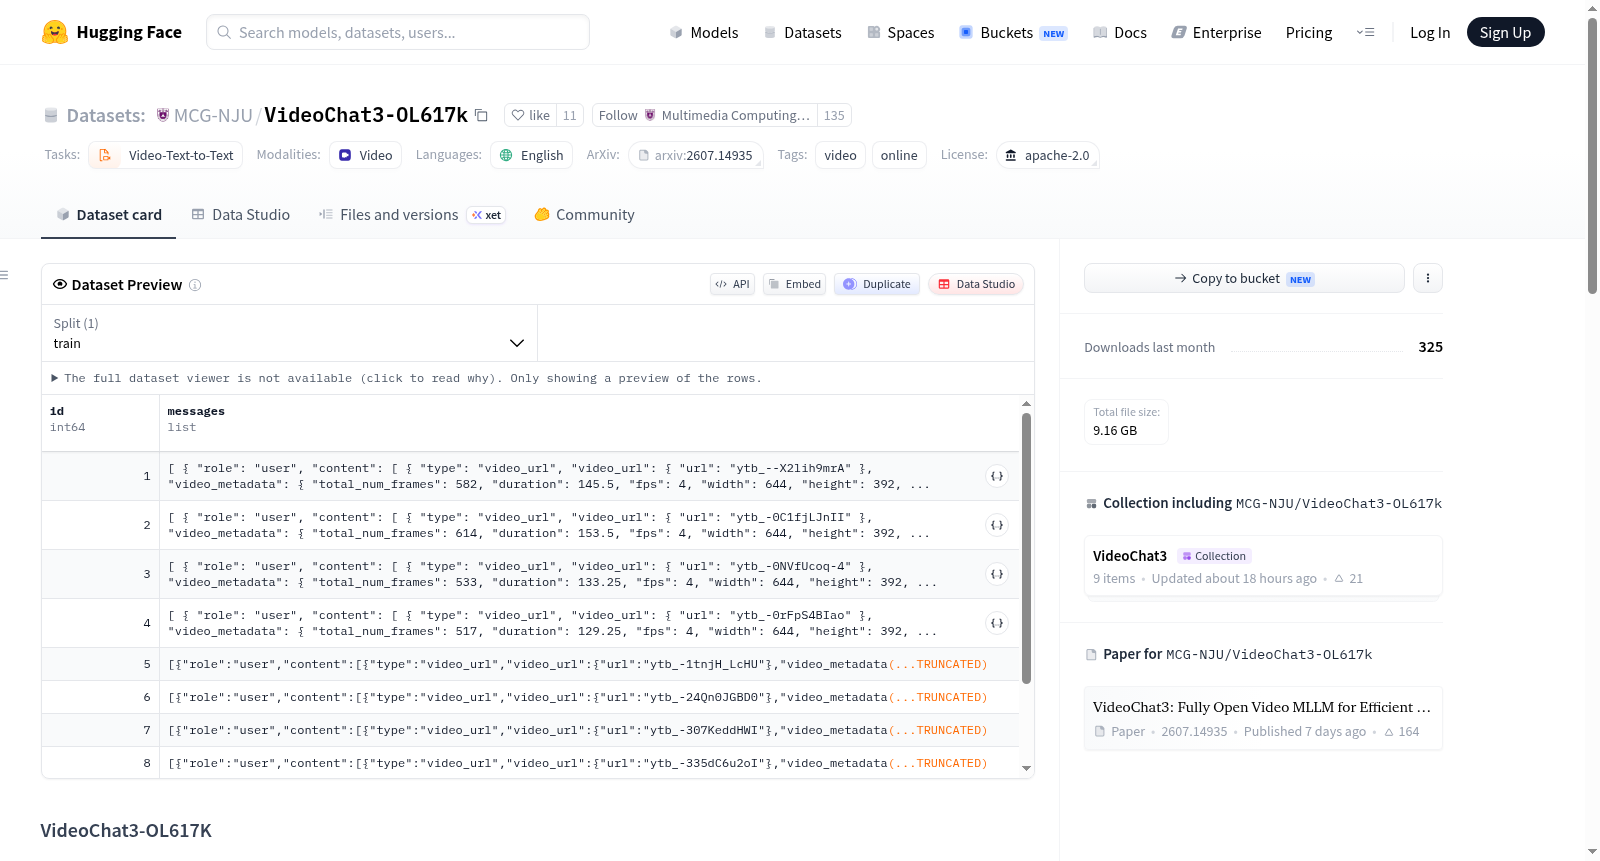
VideoChat3-OL617K是VideoChat3使用的在线视频指令数据,旨在训练主动式流媒体视频助手,这些助手能够持续观察传入的视频、积累视觉证据并在适当时刻响应。该数据集将视频-问题-答案三元组转换为因果流监督,首先定位并验证视觉线索间隔,然后转换为带有明确响应状态标记的流序列:`</Silence>`、`</Standby>`和`</Response>`。这些标记教导模型何时保持沉默、继续收集证据和提供答案。本仓库提供JSONL注释文件,原始视频未在此处复制;用户应从下方列出的原始数据集路径解析视频。

VideoChat3-OL617K is the online video instruction data used by VideoChat3. It is designed to train proactive streaming video assistants that continuously observe incoming video, accumulate visual evidence, and respond at the appropriate moment. The dataset converts video-question-answer triples into causal streaming supervision. Visual clue intervals are first localized and verified, then transformed into streaming sequences with explicit response-state tokens: `</Silence>`, `</Standby>`, and `</Response>`. These tokens teach the model when to remain silent, continue collecting evidence, and provide an answer. This repository provides JSONL annotation files. The original videos are not duplicated here; users should resolve videos from the original dataset paths listed below.
提供机构:
MCG-NJU
搜集汇总
数据集介绍
MCG-NJU/VideoChat3-OL617k 数据集图片
构建方式
VideoChat3-OL617k数据集专为训练主动式流式视频助手而构建,该助手需持续观察传入视频、积累视觉证据并在适当时刻响应用户。其构建核心在于将传统的视频-问题-答案三元组转化为因果式流式监督信号。具体而言,首先基于视觉线索区间进行定位与验证,随后将这些区间转换为带有显式响应状态标记的流式序列,包含<|Silence|>(保持静默)、<|Standby|>(持续收集证据)与<|Response|>(提供答案)三种令牌,以此引导模型学习何时应保持静默、何时需继续积累证据以及何时给出回答。数据来源于StreamForest、Streamo、Seeker、AVA及EgoQA等多个视频数据集,并提供了JSONL格式的标注文件与视频源映射关系。
使用方法
使用者需通过HuggingFace获取JSONL标注文件,并依据ol617k.json中提供的映射关系,自行从原始数据集路径(如StreamForest、Streamo、Seeker等)下载对应视频。在组织数据时,应将标注与原始视频进行配对,形成完整的训练样本。数据集以标准JSONL格式存储,便于在常见深度学习框架中加载与解析。建议用户在训练过程中,结合VideoChat3的开源代码库,利用其提供的流式数据处理流水线,将标注中的状态令牌与视频帧序列对齐,从而有效训练具备主动响应能力的视频理解模型。
背景与挑战
背景概述
随着视频多模态大语言模型(Video MLLM)的快速发展,传统离线处理方式难以满足流媒体场景下对实时互动与主动响应的迫切需求。VideoChat3-OL617k数据集由南京大学MCG实验室研究团队于2026年创建,旨在推动具备流式理解能力的视频助手模型研究。该数据集将视频-问题-答案三元组转换为因果流式监督格式,通过精细定位视觉线索时间区间,并引入`</Silence>`、`</Standby>`和`</Response>`三类状态令牌,引导模型自主决策静默观察、持续累积证据或适时作答。数据集融合了StreamForest、Streamo、Seeker及AVA、EgoQA等来源的标注,构建了总计逾61.7万条流式视频指令,为新一代主动视频理解系统奠定了关键数据基础。
当前挑战
现有视频理解模型多基于完整视频片段进行离线推理,无法处理实时涌入的动态视频流,导致在监控直播、自动驾驶等场景下缺乏适时响应的能力。构建过程中面临多重挑战:首先,原始数据来源多样、拍摄视角与内容类别差异显著,需统一处理不同采样率、时空跨度及光照条件的视频;其次,将非流式视频问答样本转化为包含精确响应时刻的因果流式监督,需可靠定位每个视觉线索并验证其触发响应的时机;此外,确保`</Silence>`、`</Standby>`、`</Response>`三类状态令牌在不同视频片段中语义一致且对齐人类判断,成为标注质量的关键瓶颈。
常用场景
经典使用场景
VideoChat3-OL617K数据集专为主流流式视频理解任务而构建,其核心应用场景在于训练具备主动感知能力的流式视频助手。该数据集通过将视频-问题-答案三元组转化为因果流式监督信号,并引入显式的响应状态令牌,使模型学会在连续观测视频流的过程中自主判断何时保持静默、何时积累证据以及何时给出回答。这一独特设计使得数据集成为开发实时视频问答、在线事件检测与渐进式视频理解等经典任务的基石,广泛应用于需要模型对不断涌入的视觉信息进行动态推理与适时反馈的研究场景。
解决学术问题
该数据集有效解决了传统视频理解模型依赖完整视频片段进行离线处理的局限,推动了在线视频理解领域的学术研究。具体而言,它攻克了模型在流式环境中无法自主决定回答时机、难以区分信息积累与响应输出的关键难题。通过提供包含沉默、待机与响应三种显式状态令牌的流式监督数据,VideoChat3-OL617K使研究者得以训练模型在观察证据尚不充分时保持等待,在信息完备时及时作答。这一突破性设计促进了视频多模态大模型从被动问答向主动流式响应的范式转变,深刻影响了实时视频分析、自动驾驶环境感知、智能监控等前沿方向的理论发展。
实际应用
在实际应用层面,VideoChat3-OL617K所训练的流式视频助手展现出广泛的应用潜力。在智能监控领域,系统可实时观察监控视频流,仅当检测到异常事件时主动发出警报,而非持续输出无意义的信息。在辅助驾驶场景中,模型能够持续分析路况视频,在关键的交通信号或潜在危险出现时及时向驾驶员提供提示。此外,该数据集还支撑了在线教育中的实时讲解、直播场景的智能互动以及视障辅助系统的环境描述生成等应用,使得视频理解系统能够以更自然、更高效的方式融入人类实时交互环境。
数据集最近研究
最新研究方向
VideoChat3-OL617K数据集聚焦于在线流式视频理解的前沿方向,通过引入因果流式监督机制,将视频-问题-答案三元组转化为带有明确响应状态令牌(</Silence>、</Standby>、</Response>)的流式序列,推动主动式流式视频助手的训练。该数据集整合了StreamForest、Streamo、Seeker等多个视频源,旨在模拟模型在持续观察输入视频、累积视觉证据后,在适当时机进行响应的动态过程。这一研究方向紧密关联实时视频分析、智能监控及人机交互等热点应用领域,为视频多模态大语言模型从被动问答向主动感知的演进提供了关键数据支撑,其意义在于填补了流式视频指令数据的空白,推动了高效、通用视频理解系统的实用化进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

