
遇见数据集

nb-asr-supermorphed-nob

收藏
Hugging Face2026-09-04 更新2026-09-05 收录
官方服务:

资源简介:

该数据集名为 NbAiLab/nb-asr-supermorphed-nob,旨在将普通挪威博克马尔语(Bokmål)文本直接转换为 AltMorph 括号编码格式。数据集包含训练集(349,692 行,约 901 万源词)、验证集(1,000 行)和测试集(1,000 行),以及一个审计配置(包含被拒绝的行)。每一行保留原始来源数据集、修订版本、行ID、文档ID、来源类型和许可证信息。数据集的构建基于上游训练数据,经过 NFC 和空白字符规范化、按不超过 200 个空白词分割、去重、语言识别过滤(使用挪威语语言识别模型排除非挪威语文本)、语义聚类与采样,并通过规则教师模型和神经网络学生模型生成候选,最终由三位盲审者以多数一致方式接受。自动一致接受率为 94.72%,最终训练集包含 351,556 个自动一致和 369 个经三人审核一致的行。该数据集适用于文本到文本生成任务,特别是形态学编码转换。

The dataset named NbAiLab/nb-asr-supermorphed-nob is designed to convert ordinary Norwegian Bokmål text directly into the AltMorph bracket encoding format. The dataset includes a training set (349,692 rows, approximately 9.01 million source words), a validation set (1,000 rows), a test set (1,000 rows), and an audit configuration (containing rejected rows). Each row retains the original source dataset, revision version, row ID, document ID, source type, and license information. The dataset is constructed based on upstream training data, undergoing NFC and whitespace normalization, splitting by no more than 200 whitespace words, deduplication, language identification filtering (using a Norwegian language identification model to exclude non-Norwegian text), semantic clustering and sampling, and candidate generation through a rule-based teacher model and a neural network student model, finally accepted by three blind reviewers with majority agreement. The automatic consistent acceptance rate is 94.72%, and the final training set contains 351,556 automatically consistent rows and 369 rows agreed upon by three reviewers. This dataset is suitable for text-to-text generation tasks, particularly morphological encoding conversion.
创建时间:
2026-09-04
搜集汇总
数据集介绍
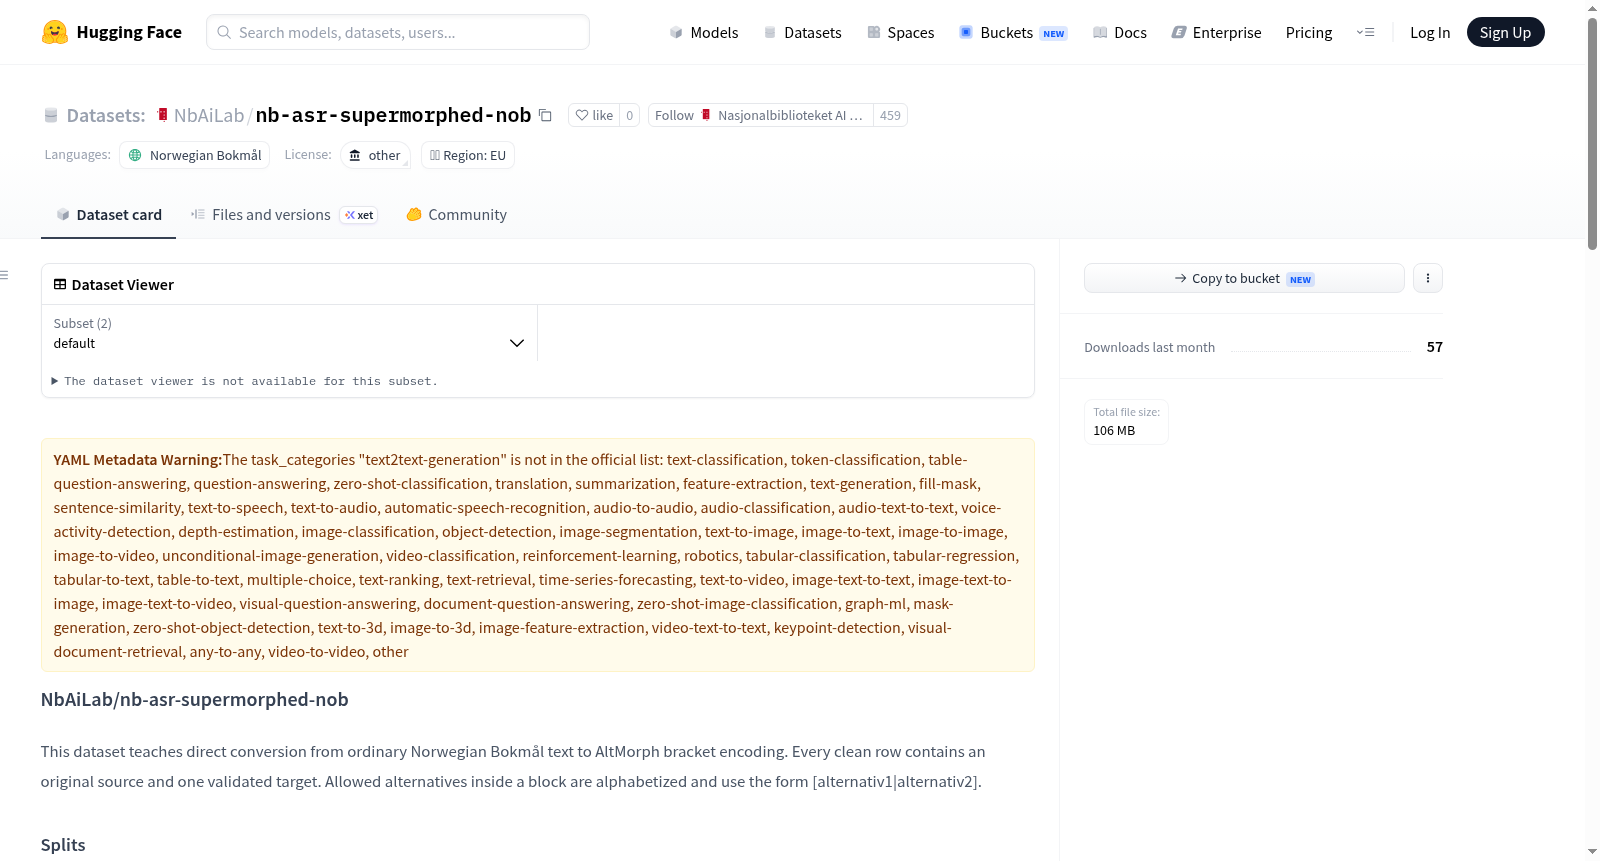
nb-asr-supermorphed-nob 数据集图片
构建方式
在挪威书面语形态复杂性的驱动下,该数据集旨在实现从普通挪威博克马尔语文本到AltMorph括号形态编码的直接转换。构建过程严格基于上游训练材料,经NFC归一化与空白清理后切分为至多200词的行,并筛除超过120词的行,最终限定至多一千万源词。每行均经固定版本的语言识别模型过滤,以外语高置信度否决非挪威语内容,同时保留原始溯源字段。规则教师与学生模型双路径生成候选目标,并由三名盲审者对不一致项独立评审,仅三方一致认可的结构合规候选被保留。
使用方法
该数据集适用于文本到文本生成任务,可直接用于训练与评估将标准挪威博克马尔语转换为AltMorph括号编码的序列到序列模型。使用者应遵循行级许可证信息,并参照上游数据集卡片进行合规复用。训练时可利用默认配置下的train、validation与test分片;审计配置可用于分析拒绝样本或研究候选生成的分歧模式。由于验证与测试按文档级隔离,可有效评估模型对未见过文档的泛化能力。推理时建议遵循构建时使用的贪婪解码设置,如批大小8、源与目标长度限制768词元。
背景与挑战
背景概述
书面挪威语(Bokmål)的形态学分析与语音合成长期依赖人工规则与词典资源,其形态变化丰富、异形同义现象普遍,为自然语言处理带来显著的标注瓶颈。挪威国家图书馆下属的NbAiLab推出nb-asr-supermorphed-nob数据集,旨在建立从标准书面挪威语文本到AltMorph括号编码的直接转换能力。该数据集由约35万条训练样本构成,覆盖逾900万源词,通过规则教师模型与神经学生模型的协同流程构建,并引入多语种语言辨识模型实施外语过滤。其核心研究问题在于降低形态标注与语音合成前端处理的人工成本,对低资源语言形态学建模、语音识别与合成管线具有重要的方法学参考价值。
当前挑战
该数据集所应对的领域问题在于,将自由文本自动映射为包含词形变体候选的形态学编码,本质上属于序列到序列的结构化生成任务,模型须在词形切分、屈折还原与同义异形排序等层面同时保持高精度,而书面挪威语的复合词与借词进一步加剧了歧义消解难度。构建过程中的挑战同样突出:候选生成依赖规则教师与神经模型的双路比对,二者在部分样本上产生逾一万九千条分歧,需经三名盲审独立裁决方予保留;语言辨识模型仅可作为外语排除的高置信度否决手段,无法替代书面挪威语与新挪威语的判别;上游文档级去重与留出隔离须在保留可追溯谱系的前提下完成,以避免训练集与验证集之间的信息泄漏。
常用场景
经典使用场景
在挪威语博克马尔语(Norwegian Bokmål)的自然语言处理中,该数据集最经典的使用场景是训练序列到序列模型,实现从普通正字法文本到AltMorph括号编码的直接转换。AltMorph编码通过方括号列举词元的允许替代形式(如[alternativ1|alternativ2]),以刻画形态学变体与规范歧义。数据集提供经严格验证的源-目标配对,其中目标编码内的替代项按字母序排列,为模型学习形态丰富语言的标准化表征提供了高质量监督信号。
解决学术问题
该数据集直面形态丰富语言在文本规范化与语言建模中的核心难题:词形变体与规范歧义难以被传统分词或词表机制充分捕捉。借助AltMorph括号编码,数据将潜在的形态替代形式显式暴露给模型,从而缓解数据稀疏与未登录词问题,并为形态感知的文本生成、拼写规范化及语言建模提供可复用的评测基准。其严格的文档级划分、来源追踪与许可证标注,亦为低资源语言数据构建中的可复现性与伦理合规提供了方法学参照。
实际应用
在实际应用中,该数据集支撑挪威语博克马尔语的拼写与形态规范化、语音识别后处理以及机器翻译预处理等任务。模型可将非规范或口语化文本转换为包含形态替代的标准编码,提升下游系统对变体形式的鲁棒性。其按源类型、长度与语义聚类联合采样的构建策略,使训练数据贴近真实文档分布,适用于构建面向出版、教育及语言技术产品的挪威语文本处理流水线。
数据集最近研究
最新研究方向
在挪威书面语形态生成与规范化领域,该数据集推动了大模型驱动的直接文本到AltMorph括注编码的转换研究。通过整合规则教师与t5gemma-2-1b模型的学生蒸馏流程,并采用三盲评审共识机制,研究者得以系统评估自动形态标注的可靠性。其细粒度溯源与审计配置的设计,为低资源语言形态学资源的可复现构建树立了标杆,进而支撑了机器翻译、语音识别后处理及语言教育工具中形态歧义消解的前沿探索,对维护挪威语语言多样性具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

