
遇见数据集

Kurd-LLM-Dataset

收藏
github2026-07-03 更新2026-07-20 收录
官方服务:

资源简介:

Kurd-LLM-Dataset 是一个大规模、精心编制的库尔德语语言资源库,由 Kurdish-Tech 组织创建。该数据集旨在弥补低资源语言建模的不足,作为开发库尔德语高级AI应用、文本处理工具和翻译引擎的核心基础设施。它包含超过50万个单词、术语和定义,覆盖 Kurmancî 和 Soranî 方言,原始数据大小约166 MB,源自 wq ferheng 数据库,并格式化为机器可读形式。

Kurd-LLM-Dataset is a large-scale, meticulously curated Kurdish language resource created by the Kurdish-Tech organization. This dataset aims to address the gap in low-resource language modeling, serving as a core infrastructure for developing advanced Kurdish AI applications, text processing tools, and translation engines. It contains over 500,000 words, terms, and definitions, covering both the Kurmancî and Soranî dialects. The original dataset has a size of approximately 166 MB, sourced from the wq ferheng database, and is formatted into machine-readable form.

创建时间:
2026-07-03
原始信息汇总

🧠 Kurd-LLM-Dataset 数据集详情

📌 概述

Kurd-LLM-Dataset 是一个大规模、精心编译的库尔德语语言资源库,由 Kurdish-Tech 组织创建。该数据集旨在弥合低资源语言建模的差距,为库尔德语的高级AI应用、文本处理工具和翻译引擎提供核心基础设施。

📊 数据集规格

  • 总记录数: 超过 500,000 个词汇、术语和定义
  • 大小: 约 166 MB(原始文本/数据)
  • 涵盖方言: Kurmancî(北库尔德语)和 Soranî(中库尔德语)
  • 数据来源: 完全从 wq ferheng 大型数据库编译和工程化处理,格式化为机器可读

🚀 目的与用例

该数据集发布旨在赋能库尔德语在数字和AI时代的发展,高度优化用于以下场景:

  1. 训练大型语言模型(LLM): 微调基础模型(如 LLaMA、GPT 等),使其原生理解和生成库尔德语文本
  2. 自然语言处理(NLP): 情感分析、分词、词干提取和句法分析
  3. 机器翻译: 构建库尔德语方言与全球语言之间的高精度翻译矩阵
  4. 语音识别(STT/TTS): 提供语音映射和语音AI训练的文本基线

🤝 贡献与组织

该项目由 Kurdish-Tech 维护,鼓励研究人员、数据科学家和开发者 fork、分析并在此基础上构建应用。
搜集汇总
数据集介绍
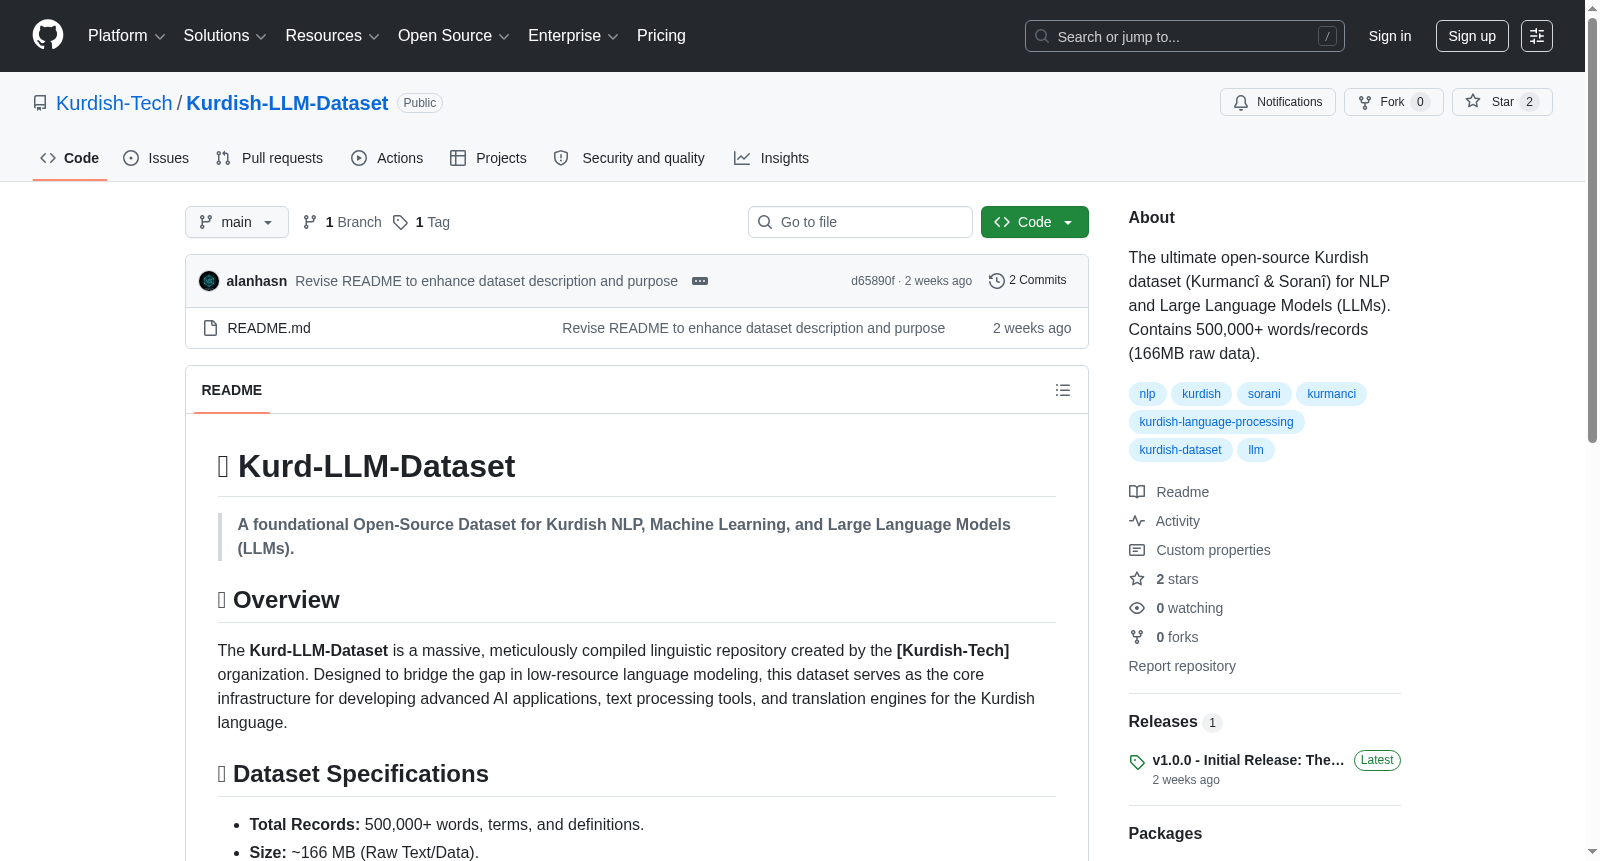
Kurd-LLM-Dataset 数据集图片
构建方式
该数据集由Kurdish-Tech组织精心构建,源自庞大的wq ferheng数据库,经过系统化整理与工程化处理,以机器可读格式呈现。数据集涵盖库尔曼吉语(Kurmancî)和索拉尼语(Soranî)两大方言,总计包含超过50万个词汇、术语及其释义,原始文本数据规模约166MB,为低资源语言建模提供了坚实的底层基础设施。
特点
作为面向库尔德语的开放基础数据集,其核心特色在于大规模覆盖两种主要方言,语料内容丰富且格式规范,高度适配大语言模型(LLM)的微调与预训练需求。该数据集专为自然语言处理任务优化,可支撑词法分析、情感识别、句法解析等多元应用,并具备跨方言翻译与语音识别领域的扩展潜力。
使用方法
研究者可直接将数据集加载至深度学习中,用于训练或微调如LLaMA、GPT等主流大模型的库尔德语能力。在自然语言处理中,可提取文本进行分词、词干提取和语法解析;在机器翻译中,可作为双语语料构建高精度翻译矩阵。此外,该数据也适用于语音识别的声学模型训练,为库尔德语数字生态的构建提供核心语料支持。
背景与挑战
背景概述
库尔德语作为一种低资源语言,在自然语言处理与人工智能领域长期面临数据匮乏的困境,限制了其在大语言模型、机器翻译及语音识别等关键技术上的发展。Kurd-LLM-Dataset由Kurdish-Tech组织于近年创建,是一个大规模、开源的库尔德语语言数据集,涵盖Kurmancî和Soranî两种主要方言,包含超过50万词条与定义,原始文本规模约166MB。该数据集的发布旨在为库尔德语NLP研究奠定基础数据基础设施,促进AI技术在库尔德语社区的广泛应用,对推动低资源语言建模、跨方言机器翻译及文化数字化保存具有重要影响力。
当前挑战
该数据集面临的首要挑战是所解决的领域问题:库尔德语作为低资源语言,缺乏大规模、高质量且标准化的训练数据,现有模型难以实现精准的语义理解与生成,同时两种主要方言在词汇、语法和书写系统上的差异增加了统一建模的难度。构建过程中,从庞大的*wq ferheng*数据库中提取、清洗并格式化文本数据,需处理方言变体、歧义定义及机器可读性适配等问题,确保数据的一致性与可用性,这涉及大量的语言学工程与计算资源投入。
常用场景
经典使用场景
Kurd-LLM-Dataset作为库尔德语低资源语言处理领域的基石性数据集,其最经典的使用场景集中于大型语言模型的领域适配与多模态自然语言处理任务的底层支撑。研究者通常将其作为微调基础模型(如LLaMA、GPT等)的核心语料,使这些模型获得库尔德语原生理解与生成能力。此外,该数据集在机器翻译、语音识别与文本转语音系统中发挥关键作用,凭借其对Kurmancî与Soranî两种方言的覆盖,为跨方言与跨语言对齐提供了标准化的数据基础,显著提升了库尔德语在计算语言学中的可操作性。
衍生相关工作
基于Kurd-LLM-Dataset,研究社区已衍生出若干标志性工作。其中,针对该数据集的方言对齐特性,已有工作探索了基于对比学习的低资源方言嵌入方法;在模型微调方向上,研究者利用该数据集对LLaMA进行持续预训练,首次实现了库尔德语指令跟随模型的原生对话能力;此外,该数据集还催生了库尔德语情感分析基准评估集与跨领域命名实体识别标注体系,为低资源语言NLP的标准化评测奠定了重要基础。
数据集最近研究
最新研究方向
在低资源语言建模与自然语言处理的前沿探索中,Kurd-LLM-Dataset的发布标志着库尔德语在人工智能领域迈出了关键一步。该数据集聚焦于库尔德语两大主要方言——库尔曼吉语和索拉尼语,通过精心编译50万词条的语言资源,为训练原生库尔德语大语言模型、优化情感分析及句法解析等NLP任务提供了坚实基础。当前,围绕该数据集的研究热潮集中于多模态机器翻译与语音识别系统的开发,旨在打破库尔德语在数字时代的语言壁垒。这一开源举措不仅推动了低资源语言的AI平等化进程,更为文化保护与科技普惠树立了典范,催化了全球NLP社区对濒危语言技术生态的重视与协作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

