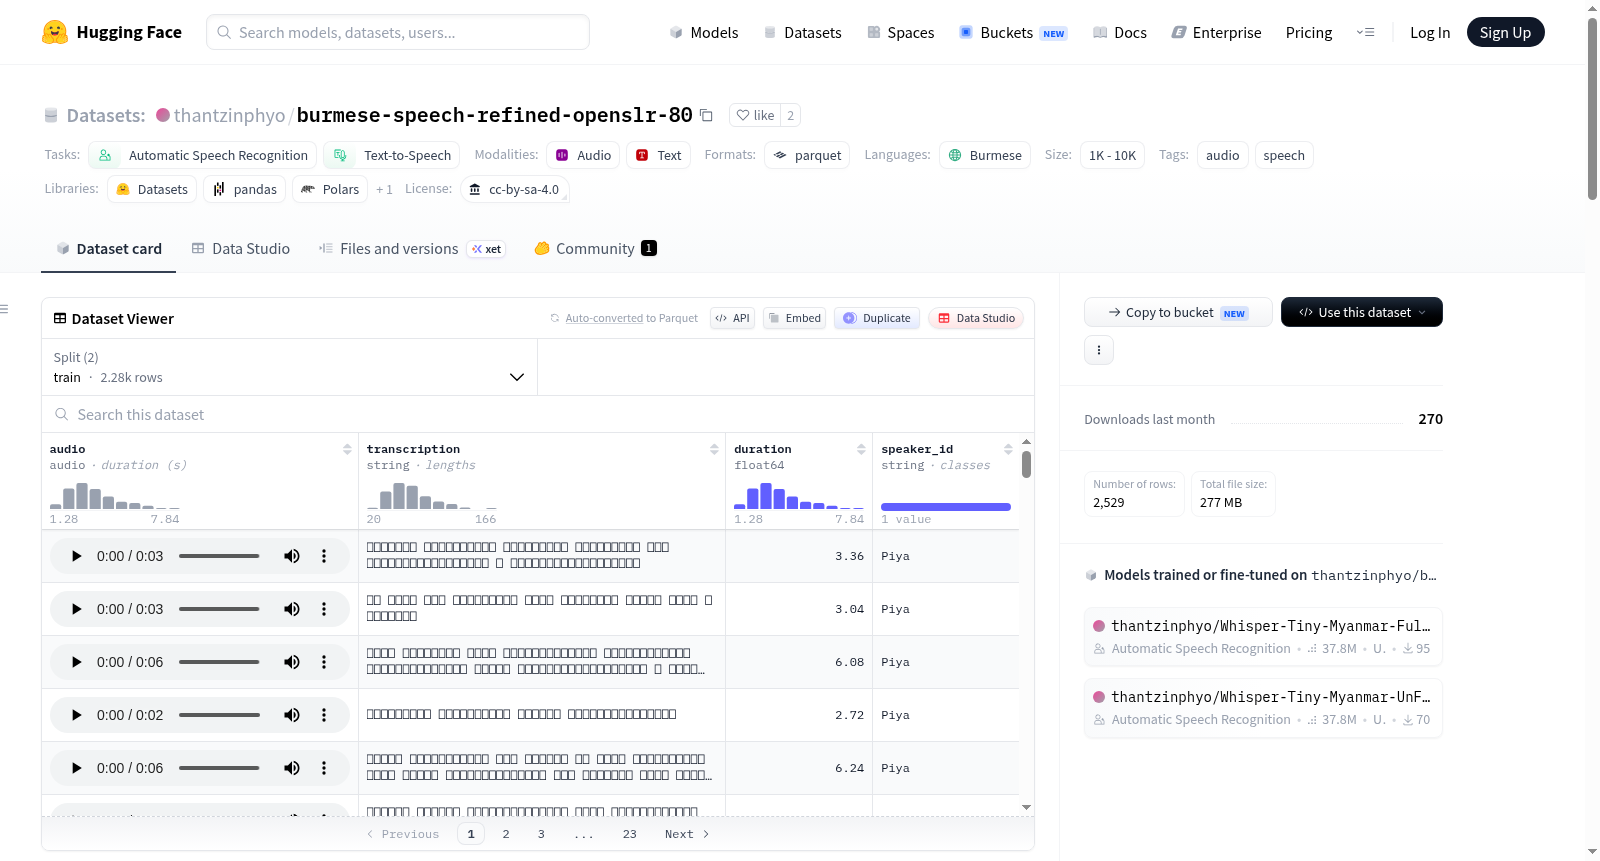
burmese-speech-refined-openslr-80
收藏资源简介:
Burmese Speech Refined OpenSLR-80 是一个基于原始 OpenSLR-80 数据集改进的缅甸语语音数据集。原始数据集中的文本根据音频发音转录,而本数据集由人工审查并修正文本,使其符合标准缅甸语拼写和书写规范,然后使用名为 Piya 的男性合成语音根据修正后的文本重新生成音频。数据集包含 2,529 个音频文件,总时长约 2.47 小时,音频格式为 16kHz、16-bit PCM、单声道 WAV。数据分为训练集(2,277 个样本)和测试集(252 个样本)。每条记录包含音频、转录文本、时长和说话人 ID。该数据集适用于文本转语音(TTS)、自动语音识别(ASR)、语音处理及其他基于缅甸语的机器学习应用。许可证为 CC-BY-SA 4.0。
Burmese Speech Refined OpenSLR-80 is an improved Burmese speech dataset based on the original OpenSLR-80 dataset. The text in the original dataset was transcribed according to audio pronunciation, while this dataset has been manually reviewed and corrected to conform to standard Burmese spelling and writing conventions. Audio was then regenerated using a male synthetic voice named Piya based on the corrected text. The dataset contains 2,529 audio files with a total duration of approximately 2.47 hours, in 16kHz, 16-bit PCM, mono WAV format. It is split into training set (2,277 samples) and test set (252 samples). Each record includes audio, transcription text, duration, and speaker ID. This dataset is suitable for text-to-speech (TTS), automatic speech recognition (ASR), speech processing, and other machine learning applications based on Burmese. The license is CC-BY-SA 4.0.
数据集概述
基本信息
- 数据集名称:Burmese Speech Refined OpenSLR-80
- 语言:缅甸语/缅甸语(
my) - 许可证:Creative Commons Attribution-ShareAlike 4.0 International (CC BY-SA 4.0)
- 任务类别:自动语音识别(ASR)、文本转语音(TTS)
- 标签:音频、语音
- 样本数量:1K < N < 10K
数据集内容
该数据集基于原始 OpenSLR 数据集(SLR80)开发,针对缅甸语应用场景对文本和音频数据进行了精心审查和进一步改进。原始数据集中的缅文文本是根据对应音频的发音方式转录的,而本数据集以原始音频和文本数据为参考,人工审查并纠正了文本,使其遵循标准缅文拼写和书写习惯。随后使用纠正后的缅文文本,通过男声合成音色 Piya 生成了新的音频。该数据集旨在提供遵循标准书写规范的缅文文本、一致的音色数据以及统一的音频录音。
数据规模
- 总音频片段数:2,529个
- 总时长:约2.47小时
- 音频规格:16 kHz、16-bit PCM、单声道 WAV
- 说话人:Piya(男声合成音)
- 数据划分:
- 训练集(train):2,277个样本,约254.2 MB
- 测试集(test):252个样本,约28.9 MB
- 总下载大小:约277.4 MB
- 总数据集大小:约283.1 MB
数据特征
- audio:音频文件
- transcription:转录文本
- duration:音频时长(float64)
- speaker_id:说话人标识
数据用途
该数据集适用于文本转语音(TTS)、语音识别(ASR)、语音处理及其他基于缅甸语的机器学习应用。
引用来源
该数据集构建于原始 OpenSLR 数据集(SLR80)基础之上,原始数据集由 Google, Inc. 于2018年、2019年版权持有,并可通过 OpenSLR 获取。相关引用文献为 Oo 等人(2020)在 LREC 会议上发表的《Burmese Speech Corpus, Finite-State Text Normalization and Pronunciation Grammars with an Application to Text-to-Speech》。