
WithinUsAI/The_Memory_From_WithIn_10k
收藏官方服务:
资源简介:
The_Memory_From_WithIn_10k 是一个前沿质量的数据集,旨在训练高级自主代理语言模型,以处理长期上下文维护、状态跟踪、重要信息保留以及跨长时间工作流和多会话项目的连续性。每个示例都教导模型哪些信息重要、应该保留或总结、如何跟踪演变状态,以及如何生成内存摘要,以便在长时间内实现高效的未来检索和决策制定。
The_Memory_From_WithIn_10k is a frontier-quality dataset designed to train advanced autonomous agentic language models on long-term context maintenance, state tracking, important information retention, and continuity across long-horizon workflows and multi-session projects. Every example teaches the model what information matters, what should be retained or summarized, how to track evolving state, and how to produce memory summaries that enable efficient future retrieval and decision making over extended periods.
提供机构:
WithinUsAI搜集汇总
数据集介绍
构建方式
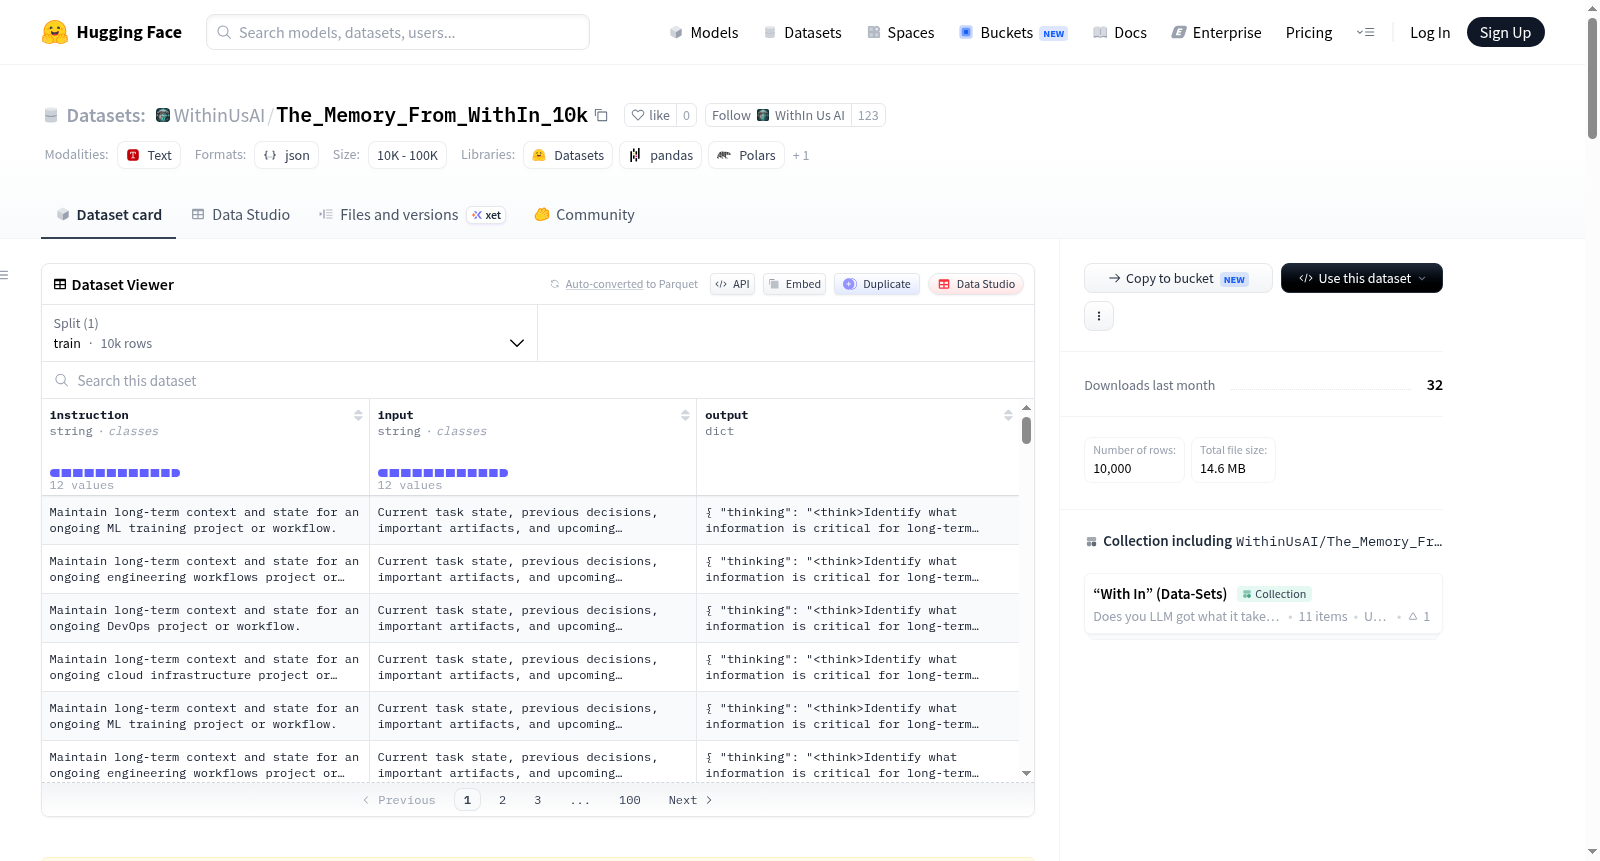
该数据集由WithIn Us Ai精心构建,包含10,000条独特且专业的JSONL格式样本。每条样本均通过严格的语义与结构去重流程生成,确保无重复或低质量内容。构建过程聚焦于模拟长期自主代理在复杂项目中的记忆管理场景,涵盖软件工程、科研实验、业务运营等多个领域。样本结构包含指令、输入及结构化输出,其中输出部分由专业推理轨迹、关键上下文、状态追踪、保留信息、未来相关性及记忆摘要组成,旨在训练模型在长周期任务中实现高效的记忆维护与状态跟踪。
使用方法
推荐将该数据集用于自主代理模型的监督微调,尤其专注于长期记忆与状态管理能力的提升。使用时需保留完整的思维链部分,以支持链式推理训练。为构建完备的自主代理能力,建议将其与规划、验证及恢复数据集配合使用,形成“计划-执行-验证-恢复-上下文保留”的闭环流程。模型通过本数据集学习后,能在跨会话、跨阶段或团队变更的场景下保持连贯性,并高效完成长时间跨度的复杂任务。
背景与挑战
背景概述
在自主智能体系统蓬勃发展的当下,大型语言模型在复杂、长期的工作流和多会话项目中维持上下文、追踪状态并实现连续性的能力,成为决定其能否胜任高级自动化任务的关键瓶颈。针对这一核心研究问题,WithIn Us Ai团队于2026年推出了The_Memory_From_WithIn_10k数据集,包含10,000条精心构造的专业示例,旨在训练模型掌握长期上下文维护、重要信息选择性保留与高效记忆摘要等前沿能力。该数据集覆盖软件工程、科研实验、商业运营与产品开发等多个高复杂度领域,为构建具备持久上下文意识与自主任务完成能力的智能体提供了高质量的训练基础,对推动自主智能体在真实长时域场景中的实用化具有重要影响力。
当前挑战
当前自主智能体面临的核心挑战在于,模型需在数小时乃至数月的时间跨度内,精确识别哪些信息对后续决策至关重要,并在信息过载与有限记忆容量之间做出取舍。The_Memory_From_WithIn_10k直面这一难题,其构建过程亦充满挑战:如何确保每个示例的推理链条、状态追踪与记忆摘要之间逻辑自洽,如何模拟真实项目中常见的阶段切换与团队交接场景,以及如何通过严格的语义与结构去重避免数据冗余,同时保持覆盖广泛领域的专业性与真实性。这些挑战的解决,使得该数据集能够高效训练出具备长程推理能力与专业项目记忆管理技能的自主智能体。
常用场景
经典使用场景
在自主语言模型与智能体系统的前沿研究中,The_Memory_From_WithIn_10k数据集专为训练具备长期上下文维护与状态追踪能力的模型而设计。其经典使用场景在于驱动模型掌握跨会话、多阶段项目中的关键信息识别、选择性保留与记忆摘要生成,从而实现对持续长周期工作流的连续性支持。通过模拟软件研发、科研项目、运营管理等专业领域的复杂记忆管理任务,该数据集使模型能够高效评估信息重要性、动态追踪进展状态,并产出供未来检索与决策的紧凑记忆摘要,成为构建持久型自主智能体不可或缺的训练基石。
解决学术问题
该数据集着力解决大型语言模型在长程推理与多会话交互中普遍面临的上下文断裂与信息遗忘问题。在学术研究中,模型往往难以在延展时间轴上持续追踪任务状态并做出连贯决策。此数据集通过提供覆盖多领域、带有专业推理轨迹的真实记忆管理样本,引导学生模型学习何为核心信息、如何随项目演进动态更新状态、以及如何进行选择性保留与精简摘要。其意义在于推动从静态问答范式向具备类人长期记忆能力的自主智能体系统跃迁,为大规模语言模型在复杂、持久性任务中实现真正的语义连续性与决策一致性提供关键数据支撑。
实际应用
在实际应用层面,该数据集广泛赋能需要长时间跨度和高度状态一致性的智能体系统。例如,在长期科研项目管理中,模型可依据数据集训练的能力,自动追踪实验进展、团队变更与关键决策,为新成员生成无缝接手摘要。在客户服务场景里,系统能跨会话维护用户偏好与历史交互记录,提供个性化且连贯的服务体验。此外,在产品开发与初创企业执行中,智能体可辅助追踪多阶段交付物、风险与依赖关系,确保项目在人员变动或目标调整时仍保持稳健推进,极大提升人机协作的深度与效率。
数据集最近研究
最新研究方向
在自主智能体与长期上下文管理的交叉前沿,该数据集聚焦于训练大语言模型在超长时域工作流与多会话项目中的记忆维持与状态追踪能力。随着以CrewAI、AutoGPT为代表的自主代理系统逐步走向实际部署,模型在跨阶段、跨团队乃至跨月级的连续性推理中常遭遇上下文遗忘与状态丢失的瓶颈,直接制约其在科研项目管理、复杂工程运维与长期客户交互等场景中的可靠性。该数据集通过10,000条精心构造的专业样例,系统性地引入关键信息识别、选择性保留、记忆摘要生成与未来关联性标注等认知范式,为构建能够自主完成长周期任务并实现高效经验复用的持久化智能体提供了稀缺的高质量训练信号,标志着自主代理从短期反应迈向长期规划与记忆支撑的关键跃迁。
以上内容由遇见数据集搜集并总结生成


