
遇见数据集

annakosovskaia/reasoning-data-numina

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

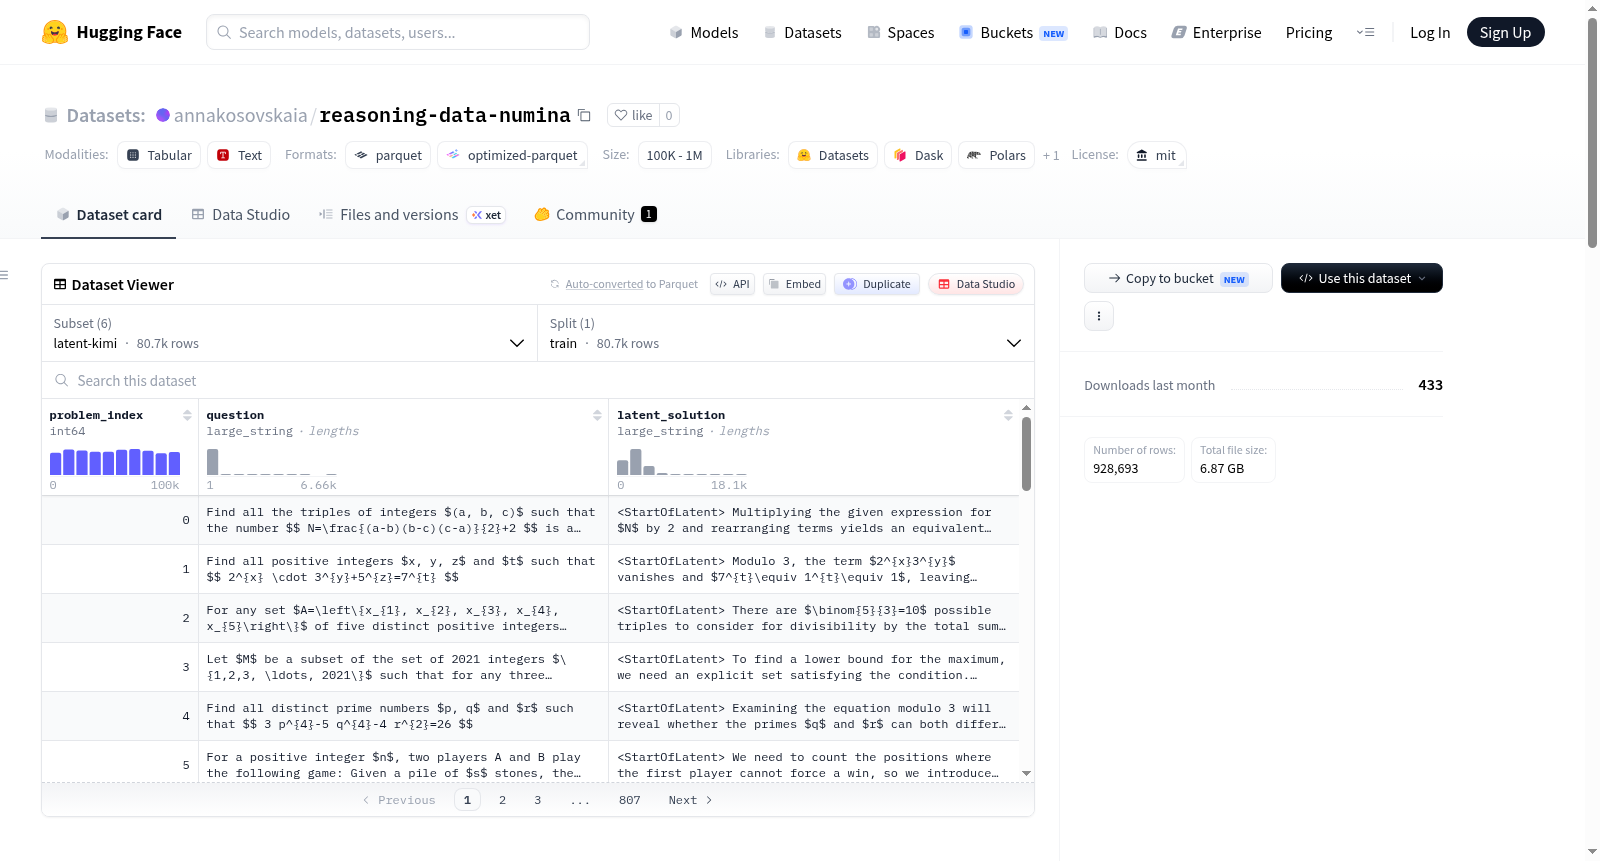
NuminaMath推理轨迹数据集包含在NuminaMath-1.5-RL-Verifiable-cleaned数据集(配置为all)的问题上,由不同模型生成的推理轨迹。数据集包含多个配置,分别对应不同的生成模型:latent-kimi使用Kimi-K2.5模型生成,采用交错潜在推理格式,每个可见数学步骤前包含一个简短的潜在思考;qwen和minimax配置包含问题、预期答案、尝试次数、尝试记录(含推理和解决方案)以及正确推理和解决方案;qwen_distilled-7b、qwen_distilled-14b和qwen_distilled-mixed-7-14b配置仅保留正确轨迹,每个问题最多包含4次尝试,其中混合配置优先使用7B模型的轨迹。数据集旨在提供数学问题求解的多样化推理过程记录。

The NuminaMath Reasoning Traces dataset contains reasoning traces generated by different models on problems from the NuminaMath-1.5-RL-Verifiable-cleaned dataset (config all). The dataset includes multiple configurations corresponding to different generative models: latent-kimi uses the Kimi-K2.5 model to generate traces in an interleaved latent-reasoning format, where each visible mathematical move is preceded by a short latent thought; qwen and minimax configurations include the problem, expected answer, total attempts, attempts (with reasoning and solution), and correct reasoning and solution; qwen_distilled-7b, qwen_distilled-14b, and qwen_distilled-mixed-7-14b configurations retain only correct traces, with up to 4 attempts per problem, and the mixed configuration fills slots with the shortest correct traces from the 7B model first, then the 14B model. The dataset aims to provide diverse reasoning process records for mathematical problem-solving.
提供机构:
annakosovskaia
搜集汇总
数据集介绍
annakosovskaia/reasoning-data-numina 数据集图片
构建方式
该数据集基于NuminaMath-1.5-RL-Verifiable-cleaned数据集的全部问题,由多个前沿大语言模型生成推理轨迹构建而成。具体而言,数据集包含六个子配置,分别对应Kimi-K2.5、DeepSeek-R1-Distill-Qwen-7B/14B、Qwen3.5-397B-A22B以及MiniMax-M2.5等模型。对于latent-kini配置,其解决方案采用交织的潜在推理格式,每个可见数学步骤前嵌入一个短小的潜在思考,以解释该步骤的推理桥梁,灵感来源于《Reasoning to Learn from Latent Thoughts》。对于蒸馏模型,则仅保留正确的推理轨迹,每个问题最多包含四次尝试。混合配置优先使用7B模型的最短正确轨迹,不足时由14B模型补充。
特点
该数据集的核心特点在于其多模型、多粒度的推理轨迹覆盖,为数学推理研究提供了丰富的资源。latent-kini子集通过显式标记潜在思考过程,揭示了模型在数学推导中的内部逻辑,有助于探索推理的可解释性。蒸馏模型子集则聚焦于正确解法,且每个问题支持多次尝试,便于分析模型在多次推理中的稳定性与一致性。混合配置通过择优选择最短正确解,兼顾了数据效率与多样性。所有子集均保留了问题索引与原始问题文本,便于与原始数据集对齐及进行跨模型比较。
使用方法
该数据集可通过HuggingFace的datasets库加载,指定相应的config_name即可获取不同子集。例如,使用load_dataset('reasoning-data-numina', 'latent-kimi')可加载Kimi-K2.5生成的潜在推理格式数据。对于蒸馏模型子集,返回的每条样本包含问题、期望答案及单次正确推理轨迹,可直接用于训练推理模型或作为监督微调数据。对于qwen和minimax子集,可通过'correct_reasoning'和'correct_solution'字段提取首次正确尝试的完整推理过程。数据的question字段与NuminaMath原数据集一致,便于进行跨数据集联合分析。
背景与挑战
背景概述
在数学推理领域,大规模语言模型(LLM)的链式思维与潜在推理能力成为研究焦点。数据集reasoning-data-numina发布于2025年,由多家机构合作构建,基于NuminaMath-1.5-RL-Verifiable-cleaned数据集中的数学问题,利用Kimi-K2.5、DeepSeek-R1-Distill-Qwen系列、Qwen3.5-397B-A22B及MiniMax-M2.5等先进模型生成推理轨迹。该数据集旨在捕捉不同模型在解决数学问题时的推理逻辑,特别是采用交叠潜在推理格式(interleaved latent-reasoning)来揭示隐式思维过程,为理解与提升LLM的逐步推理能力提供了重要资源。其研究核心在于探索潜在思维如何桥接数学步骤,对推动可解释人工智能与数学自动推理的发展具有显著影响力。
当前挑战
该数据集面临的核心挑战源于数学推理的本质复杂性与构建过程的精细度。领域问题层面,数学推理要求严格的形式化与逻辑一致性,而语言模型生成的推理轨迹常存在跳跃、冗余或错误,如何确保潜在推理(latent thought)的准确性与必要性,避免引入误导性信息,是提升数据质量的关键。构建过程中,不同模型(如Kimi-K2.5与DeepSeek-R1-Distill系列)在问题覆盖与推理风格上差异显著,整合异构轨迹时需处理格式统一与答案验证难题;此外,为每个问题生成多轮正确轨迹并选择性压缩(如混用7B与14B模型的最短正确解),在保持推理完备性的同时控制数据规模,构成了工程与算法的双重挑战。
常用场景
经典使用场景
在数学推理与逻辑演绎的研究领域中,reasoning-data-numina 数据集成为了一个不可或缺的基准资源。该数据集汇聚了来自 Kimi-K2.5、DeepSeek-R1-Distill-Qwen 系列以及 Qwen3.5 等顶尖模型对 NuminaMath 问题的推理轨迹,尤其以交错潜在推理格式(latent-reasoning format)——在每个数学操作前嵌入显式的思考桥接片段——而独树一帜。经典的使用方式是基于这些细粒度的推理链,训练和评估语言模型在复杂数学题目上的逐步推导能力,探究模型如何在离散的步骤间建立逻辑联系,从而推动 AI 在形式化推理任务上的性能跃升。
解决学术问题
该数据集从根本上回应了数学推理领域中的“黑箱困境”——即深度学习模型虽然能输出正确答案,但其内部推理过程模糊难解。通过提供模型在解题时生成的显性化潜在思考步骤,reasoning-data-numina 使得研究者得以系统分析模型在演绎、归约、分支分类和矛盾识别等环节的逻辑完整性。它不仅缓解了数学推理任务中数据稀缺的问题,还促进了可解释推理路径生成技术的研究,纠正了以往仅通过最终答案衡量模型能力的偏差,为构建更透明、更严谨的数学人工智能系统奠定了坚实的数据基础。
衍生相关工作
reasoning-data-numina 数据集的发布催生了一系列富有影响力的衍生工作。直接利用其推理轨迹,研究者模拟了 Kimi-K2.5 的“潜在思维蒸馏”范式,催生了如《Reasoning to Learn from Latent Thoughts》等开创性论文,实验表明模型通过模仿这种显性推理桥接能够显著提升迁移学习效率。此外,基于该数据中 DeepSeek 蒸馏版本的混合配置,学术界出现了大量探讨计算资源节约与推理纯度之间权衡的对比研究,并衍生出侧重最短正确推理路径挖掘的开源工具包,进一步加深了关于语言模型何时以及如何从演示推理中获益的理论认知。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

