fineweb10B-tokenized-custom
收藏资源简介:
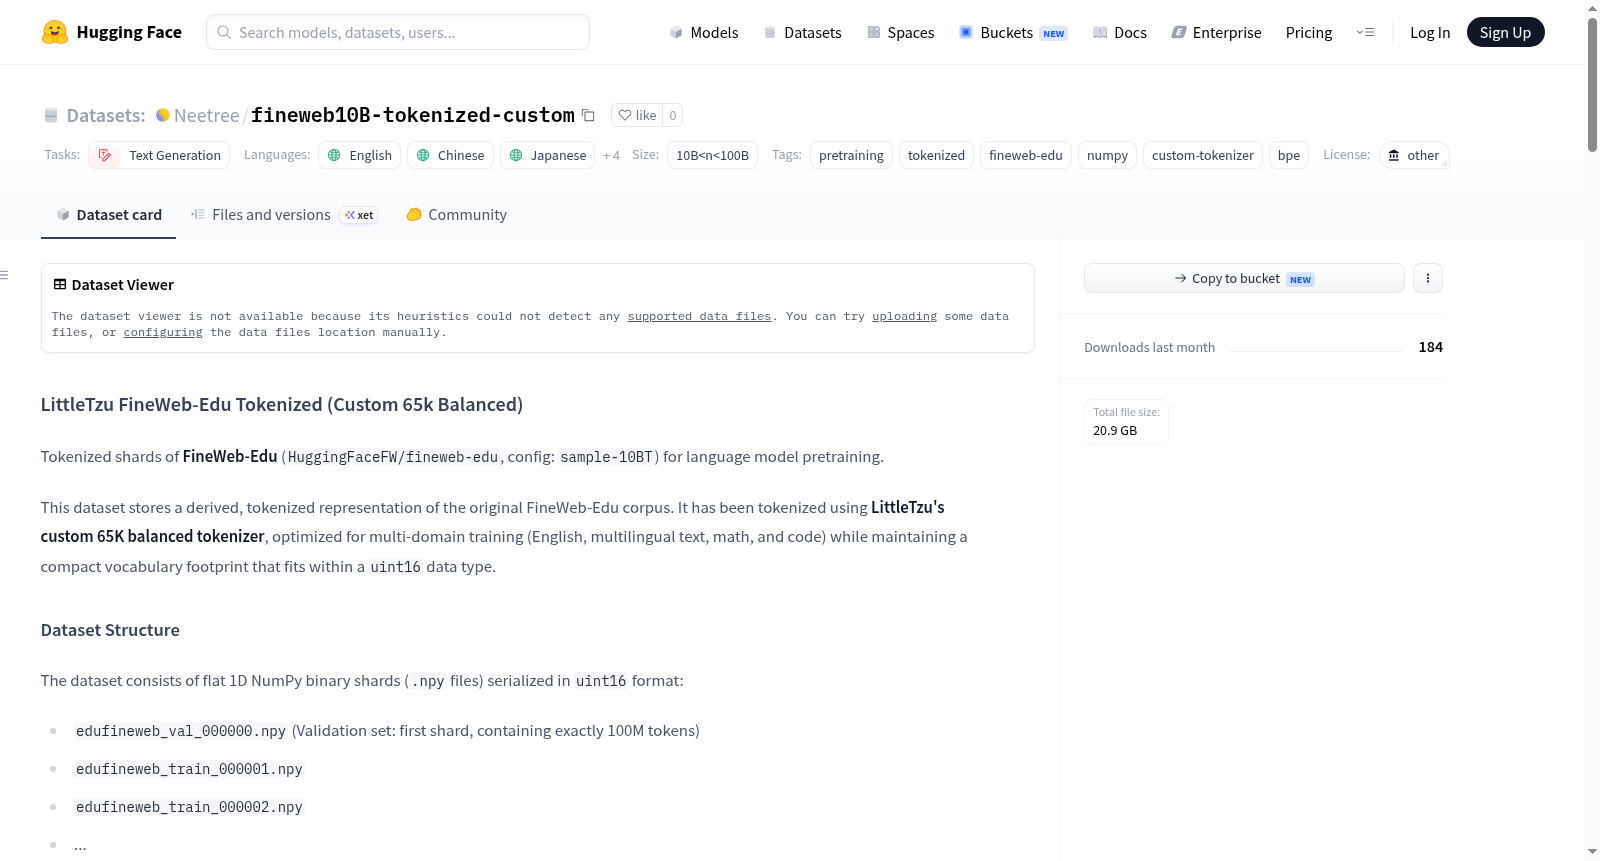
LittleTzu FineWeb-Edu Tokenized (Custom 65k Balanced) 是一个用于语言模型预训练的、经过分词处理的数据集。它基于 Hugging Face 的 FineWeb-Edu 语料库(配置:`sample-10BT`)派生而来,使用了一个自定义的、词汇量为 65,536 的 Byte-Level BPE 分词器进行分词。该分词器专为多领域训练(包括英语、多语言文本、数学和代码)优化,同时保持紧凑的词汇表大小,使其能自然地适配 `uint16` 数据类型,从而在加载时相比标准 `uint32` 或 `int32`/`int64` 加载器节省 50% 的内存/存储开销。分词器在平衡的 500 万文档子集上训练,涵盖英语(通用与教育)、多语言中文、意大利语、数学/科学、日语、代码和韩语领域,以确保其在各领域的高效性。数据集结构由扁平的 1D NumPy 二进制分片(.npy 文件)组成,序列化为 `uint16` 格式。每个分片恰好包含 100,000,000(100M)个 token。原始文档经过分词后,每个文档前都添加了 `<|eos|>` token 作为分隔,然后被打包成连续的 100M token 数组。数据集中包含一个验证集分片(`edufineweb_val_000000.npy`)和多个训练集分片(`edufineweb_train_000001.npy` 等)。该数据集适用于大规模因果语言模型预训练、数据加载管道基准测试,以及与 LittleTzu 训练配置兼容的轻量级、经济型模型训练基线。
数据集概述
LittleTzu FineWeb-Edu Tokenized (Custom 65k Balanced) 是一个经过分词后的预训练数据集,基于 Hugging Face 的 FineWeb-Edu 数据集(配置:sample-10BT)构建,专门用于语言模型预训练。
- 语言:英语、中文、日语、韩语、意大利语、西班牙语、德语
- 许可证:其他(需参考原始数据集)
- 任务类型:文本生成
- 标签:预训练、分词、FineWeb-Edu、NumPy、自定义分词器、BPE
- 数据规模:10B < n < 100B 词元
数据集结构
数据集由扁平的 1D NumPy 二进制分片文件(.npy 格式,以 uint16 序列化)组成:
- 验证集:
edufineweb_val_000000.npy(包含 1 亿个词元) - 训练集:
edufineweb_train_000001.npy至edufineweb_train_000099.npy
每个分片正好包含 100,000,000(1亿)个词元。原始文档被分词后,每个文档前加上 <|eos|> 标记,然后打包成连续的 1 亿词元数组。
自定义分词器:tokenizer_65k_balanced
分词器为 字节级 BPE(Byte-Level BPE),词汇量为 65,536,天然适配 uint16 数组,节省 50% 的内存/存储开销。
- 模型类型:字节级 BPE
- 词汇量:65,536
- 预分词:
ByteLevel(add_prefix_space=False)Digits(individual_digits=True)— 将数字逐个拆分(如123→1,2,3)
- 特殊与控制词元:
- 标准:
<|pad|>,<|bos|>,<|eos|>,<|unk|>,<|sep|> - 聊天格式:
<|im_start|>,<|im_end|> - 保留位:50 个保留占位符(
<|reserved_0|>至<|reserved_49|>)
- 标准:
训练混合语料(均衡语料)
分词器基于 500 万文档的均衡子集训练:
| 语种/领域 | 来源 | 占比 |
|---|---|---|
| 英语(通用及教育) | HuggingFaceFW/fineweb-edu | 25% |
| 多语言中文 | epfml/FineWeb2-HQ (cmn_Hani) |
20% |
| 多语言意大利语 | HuggingFaceFW/fineweb-2 (ita_Latn) |
15% |
| 数学/科学 | open-web-math/open-web-math | 15% |
| 多语言日语 | epfml/FineWeb2-HQ (jpn_Jpan) |
10% |
| 编程代码 | bigcode/the-stack-v2-train-smol | 10% |
| 多语言韩语 | HuggingFaceFW/fineweb-2 (kor_Hang) |
5% |
分词压缩效率(字符/词元)
| 语言/领域 | 自定义 65k(字符/词元) | OpenAI cl100k_base(字符/词元) | 相对效率 |
|---|---|---|---|
| 英语 | 5.13 | 5.13 | 持平(1.00x) |
| 意大利语 | 5.19 | 3.59 | +44.5%(1.44x) |
| 韩语 | 1.71 | 1.09 | +56.8%(1.57x) |
| 日语 | 1.38 | 0.85 | +62.3%(1.62x) |
| 中文 | 1.20 | 0.94 | +27.6%(1.28x) |
| Python 代码 | 2.35 | 2.94 | -20.0%(0.80x) |
数据准备与预处理
数据集通过并行化处理脚本(fineweb.py)完成分词和分片:
- 从原始
HuggingFaceFW/fineweb-edu(sample-10BT)数据集流式读取文档。 - 使用
tokenizer_65k_balanced.json分词器对文档进行分词。 - 在每个文档前添加
<|eos|>词元。 - 将词元流打包成连续的 1D NumPy 数组缓冲区(大小 1 亿)。
- 将每个分片转换为
np.uint16格式并保存到本地或上传至 Hugging Face。
加载与流式读取
- 下载分片:使用
huggingface_hub的snapshot_download下载所有.npy文件。 - PyTorch 数据加载器示例:使用
np.load配合内存映射(mmap_mode="r")实现高效流式加载,按需生成输入(x)和目标(y)批次。
预期用途
- 大规模因果语言模型预训练。
- 数据加载管线的基准测试。
- 轻量级、低预算的模型训练基线(兼容 LittleTzu 训练配置)。
引用与原始数据集
原始数据集为 Hugging Face 的 FineWeb-Edu,详细信息请参考文献及其 数据集页面。若使用本分词/分片版本,请引用原始数据集创建者。