
SupraBench/bap
收藏官方服务:
资源简介:
--- dataset_info: features: - name: id dtype: string - name: task dtype: string - name: answer dtype: float64 - name: host_name dtype: string - name: molecule dtype: string - name: version dtype: string - name: question dtype: string - name: source dtype: string - name: prompt_strategy dtype: string splits: - name: test num_bytes: 13768606 num_examples: 7827 - name: cb7 num_bytes: 1082259 num_examples: 651 download_size: 1497145 dataset_size: 14850865 configs: - config_name: default data_files: - split: test path: data/test-* - split: cb7 path: data/cb7-* ---
提供机构:
SupraBench搜集汇总
数据集介绍
构建方式
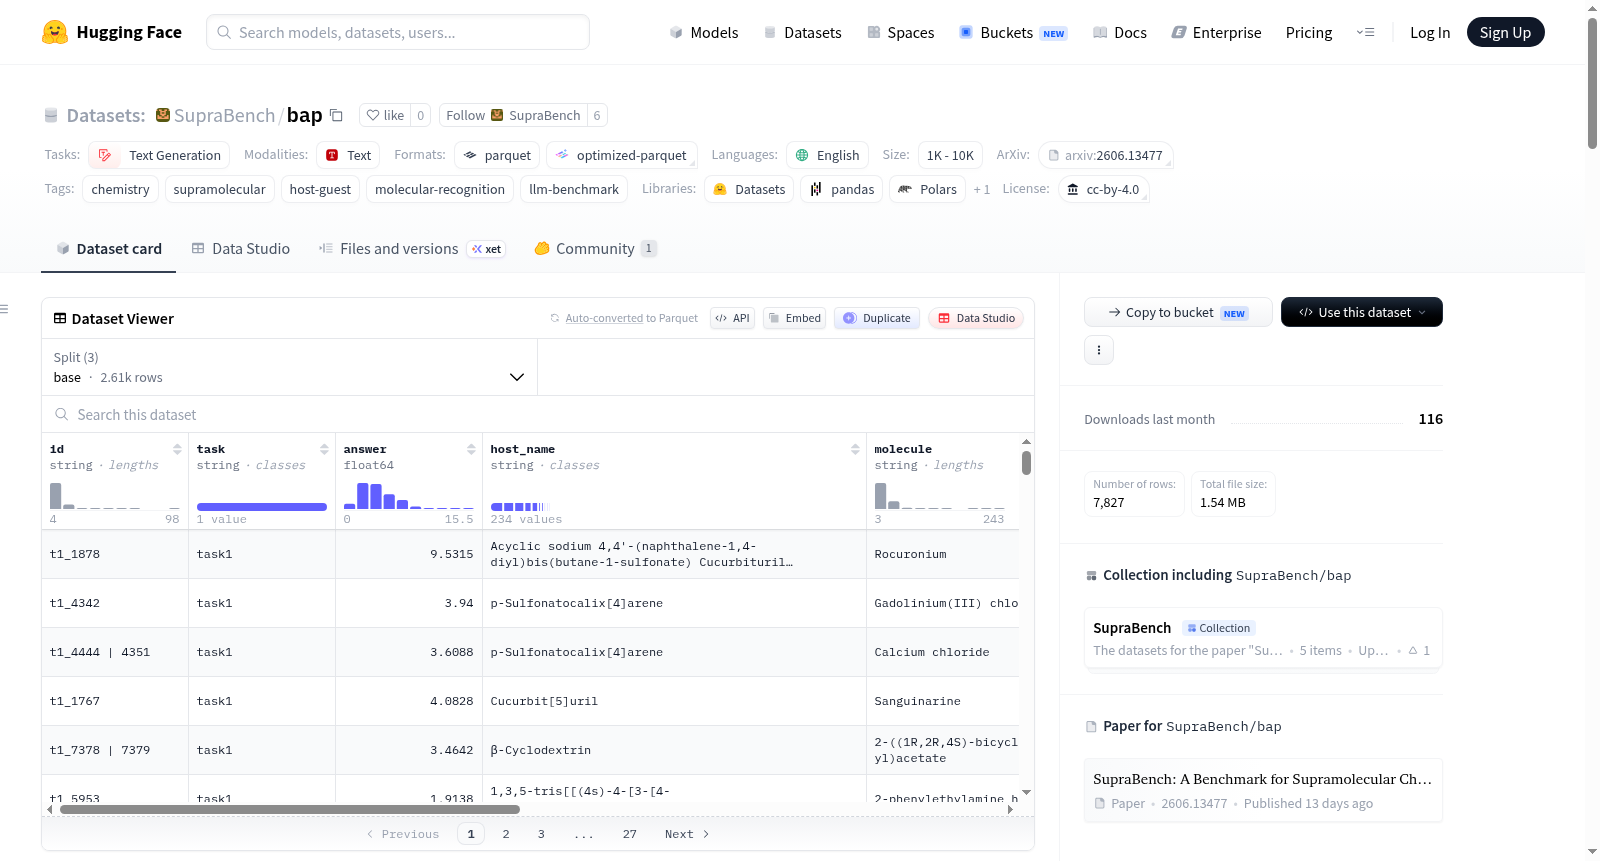
SupraBench/bap数据集是首个面向超分子主客体化学推理的大语言模型基准测试集,其构建基于从SupraBank数据库中提取的主客体结合亲和力数据。每条记录包含一个主客体对的结合常数log K_a作为回归目标,并配有详细的分子结构与环境信息。数据集按照提示策略划分为base、cot和fewshot三个子集,分别对应基础提示、思维链提示和少样本提示,使得不同推理能力能够被系统评估。此外,CB[7]泛化记录在各子集中保持独立标识,便于探究模型对特定主体的外推能力。
使用方法
使用该数据集时,用户可直接通过HuggingFace datasets库加载,支持按提示策略选择base、cot或fewshot子集。每个样本均以完整渲染的问题和参考标签形式提供,便于零样本或少样本推理评估。对于完整的基准测试运行,官方代码仓库提供了端到端的推理与评分流程,用户只需配置任务参数与模型配置即可自动获取性能指标。数据集采用CC-BY-4.0许可协议,源自SupraBank的公开数据可自由用于学术研究,分子结构则结合PubChem与OPSIN工具进行标准化处理。
背景与挑战
背景概述
超分子化学作为现代化学的前沿领域,致力于研究非共价键主导的主客体组装行为,其在药物递送、化学传感及体内毒素捕获等关键应用中展现出不可替代的价值。然而,主客体系统的理性设计长期受困于低效的实验验证流程——每对主客体组合需耗费数天的干实验室确认,极大制约了研究进展。在此背景下,由天津大学马天一等研究人员于2026年创建的SupraBench数据集应运而生,这是首个针对大型语言模型在超分子主客体化学推理能力评估的综合性基准。该数据集以结合亲和力预测为核心任务,系统性地整合了来自SupraBank的2609个配体-受体结合记录,并配套提供了超分子领域专有的文本语料库。作为该领域标准化评估的开创性工作,SupraBench为衡量和推动语言模型在分子识别任务中的认知能力提供了关键测试平台。
当前挑战
该数据集主要面临三方面挑战。首先,在领域问题层面,结合亲和力的定量预测本质上是一个复杂的回归任务,要求模型理解非共价相互作用的微妙机制,当前最先进模型如Gemini-3-Flash的均方根误差仍高达1.679,远未达到可辅助实验设计的精度阈值。其次,在基准构建过程中,数据整合面临异构数据源的统一难题——需要从SupraBank、欧洲PMC、PubChem等多源异构平台中提取标准化格式的分子结构与结合常数,并处理不同实验室间测量标准的差异性。最后,在提示策略设计上,实验表明链式思考推理不仅未能改善反而放大了模型在结合亲和力预测上的推理缺陷,而不同任务间最优提示策略的显著差异进一步增加了评估框架的设计难度。
常用场景
经典使用场景
在超分子化学研究领域,结合亲和力预测(Binding Affinity Prediction, BAP)数据集作为SupraBench基准的核心组成部分,主要用于评估大型语言模型对主客体化学中非共价相互作用的理解与推理能力。该数据集包含2609个样本,每个样本记录了特定主客体对的结合常数(log K_a),模型需根据提供的分子结构与背景信息,回归预测该数值。经典使用方式涉及将数据集划分为base、cot和fewshot三种提示策略,以检验模型在不同信息呈现方式下的预测准确性。BAP数据集为评估LLM在量化化学推理任务上的表现提供了标准化测试平台,尤其聚焦于主客体结合这一微观但关键的化学现象。
解决学术问题
BAP数据集旨在解决超分子化学领域中一个长期存在的学术难题:如何快速、准确地预测主客体分子间的结合亲和力,而不依赖耗时且昂贵的实验验证。传统上,每对主客体组合的亲和力测定需要数天的干实验室验证,严重制约了药物递送、化学传感及体内毒素捕获等应用的发展。该数据集使研究人员能够系统性地评估LLM在这一回归任务上的表现,揭示模型在量化化学推理中的优势与局限。研究表明,尽管前沿大模型如Gemini-3-Flash展现出较好的预测能力,但所有测试模型在BAP任务上均存在显著的改进空间,这为后续研究指明了方向。
实际应用
在实际应用中,BAP数据集支撑的模型能力可直接迁移至超分子化学的多个关键环节。在药物递送系统中,精确预测主客体结合强度有助于快速筛选合适的载体分子,从而加速纳米药物的设计周期。在化学传感领域,合理的主客体组合能够显著提升传感器的选择性与灵敏度,BAP驱动的预测模型可辅助研究人员在大量候选分子中高效识别最优搭配。此外,在环境毒素捕获与生物医学解毒方面,准确的亲和力预测能够指导功能性主体的设计,以应对特定毒素的清除需求。这些应用场景均受益于BAP数据集带来的量化推理能力跃升。
数据集最近研究
最新研究方向
当前,超分子主客体化学领域正迎来人工智能与大数据方法的深度融合浪潮。结合亲和力预测(BAP)数据集作为首个专门面向大语言模型(LLM)在此领域推理能力的基准测试,其最新研究聚焦于评估前沿模型对非共价键组装行为的量化预测能力。通过构建涵盖2609个样本的标准化评测集,并采用多种提示策略(基础/少样本/思维链)进行系统性对比,研究表明即使如Gemini-3-Flash和DeepSeek-v4等顶尖模型,在结合亲和力的回归预测任务上仍存在显著性能瓶颈,平均绝对误差(MAE)最低达1.248,但距离实际药物递送与毒素捕获等关键应用的精度要求尚有较大提升空间。这一前沿探索不仅揭示了LLM在分子识别中因果推理的固有局限,也为智能化超分子设计工具的发展奠定了关键评估范式。
以上内容由遇见数据集搜集并总结生成


